令和5年度 春期に実施されたネットワークスペシャリスト試験
午後Ⅱの全2問(記述式)です。事例本文・設問・解答例と解説をそのまま読めます。
問1 マルチクラウド利用による可用性向上
マルチクラウド利用による可用性向上に関する次の記述を読んで,設問に答えよ。
A 社は,従業員 500 人のシステム開発会社である。A 社では,IaaS を積極的に活用して開発業務を行ってきたが,利用している IaaS 事業者である B 社で大規模な障害が発生し,開発業務に多大な影響を受けた。A 社のシステム部では,利用する IaaS 事業者をもう 1 社追加してマルチクラウド環境にし,本社を中心にネットワーク環境も含めた可用性向上に取り組むことになり,E さんを担当者として任命した。
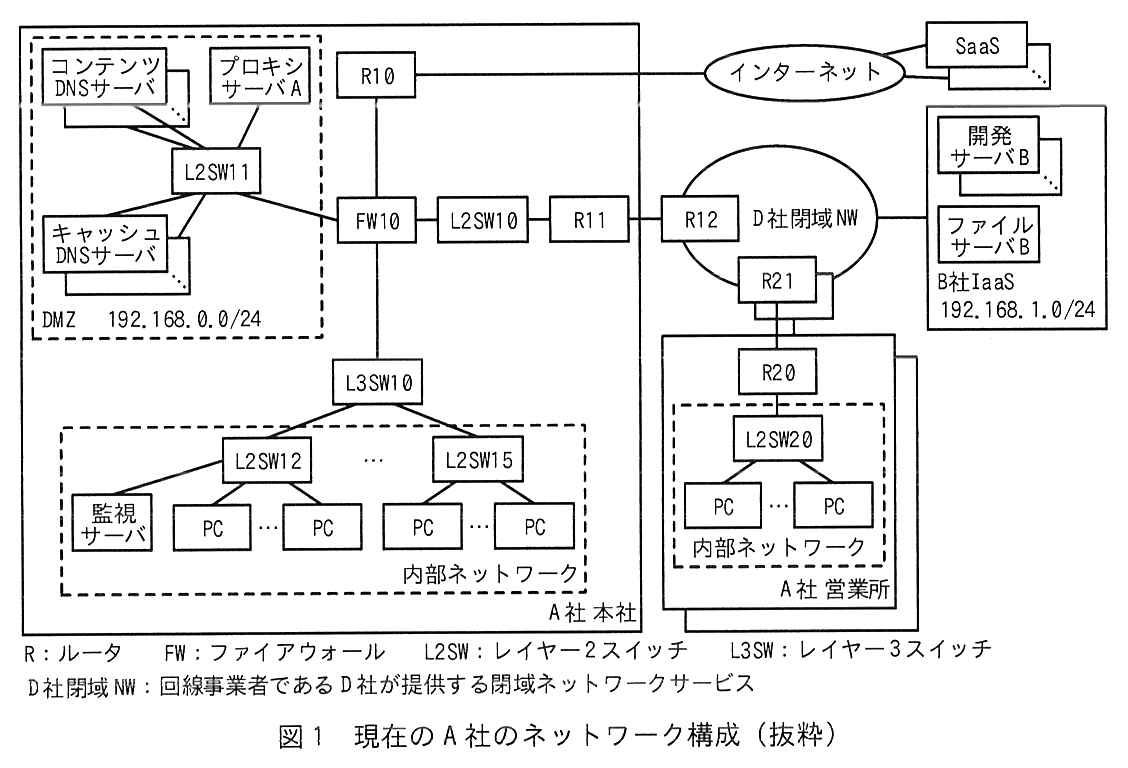
現在の A 社のネットワーク構成を図1に示す。
図1 現在の A 社のネットワーク構成(抜粋)
図1の概要を次に示す。
A 社は本社と 2 か所の営業所で構成されている。 D 社閉域 NW を利用して,本社と 2 か所の営業所を接続している。R11 及び R20 といった A 社と D 社閉域 NW とを接続するルータは,D 社からネットワークサービスとして提供されている。 D 社閉域 NW と B 社 IaaS は相互接続しており,A 社は D 社閉域 NW 経由で B 社 IaaS を利用している。 A 社ネットワークでは静的経路制御を利用している。 B 社からは,Web ブラウザを利用した画面操作によって,IaaS 上に仮想ネットワーク,仮想サーバを簡単に構築できる管理コンソールが提供されている。 A 社のシステム部は,受託した開発業務ごとに開発サーバB を構築し,A 社の担当部門に引き渡している。開発サーバB の運用管理は担当部門で実施する。 システム部は,共用のファイルサーバB を構築し,A 社の全部門に提供している。 A 社の全部門で利用する電子メールやチャット,スケジューラーなどのオフィスアプリケーションソフトウェアはインターネット上の SaaS を利用している。これらの SaaS は HTTPS 通信を用いている。 A 社の一部の部門では,担当する業務に応じてインターネット上の SaaS を独自に契約し,利用している。これらの SaaS では送信元 IP アドレスによってアクセス制限をしているものもある。これらの SaaS も HTTPS 通信を用いている。 プロキシサーバA は,従業員が利用する PC やサーバからインターネット向けの HTTP 通信,HTTPS 通信をそれぞれ中継する。従業員はプロキシサーバとして proxy.a-sha.co.jp を PC の Web ブラウザやサーバに指定している。 A 社は,本社設置の R10 を経由してインターネットに接続している。FW10 にはグローバル IP アドレスを付与しており,FW10 を経由するインターネット宛ての通信は NAPT 機能によって IP アドレスとポート番号の変換が行われる。 キャッシュ DNS サーバは,PC やサーバからの問合せを受け,ほかの DNS サーバへ問い合わせた結果を応答する。キャッシュ DNS サーバは複数台設置されている。 コンテンツ DNS サーバは,PC やサーバのホスト名などを管理し,PC やサーバなどに関する情報を応答する。コンテンツ DNS サーバは複数台設置されている。 監視サーバは,ICMP を利用する死活監視(以下,ping 監視という)を用いて DMZ や IaaS にあるサーバの監視を行っている。監視サーバで検知された異常はシステム部の担当者に通知され,復旧作業などの必要な対応が行われる。 システム部では,ネットワーク環境の可用性向上の要件を次のとおりまとめた。
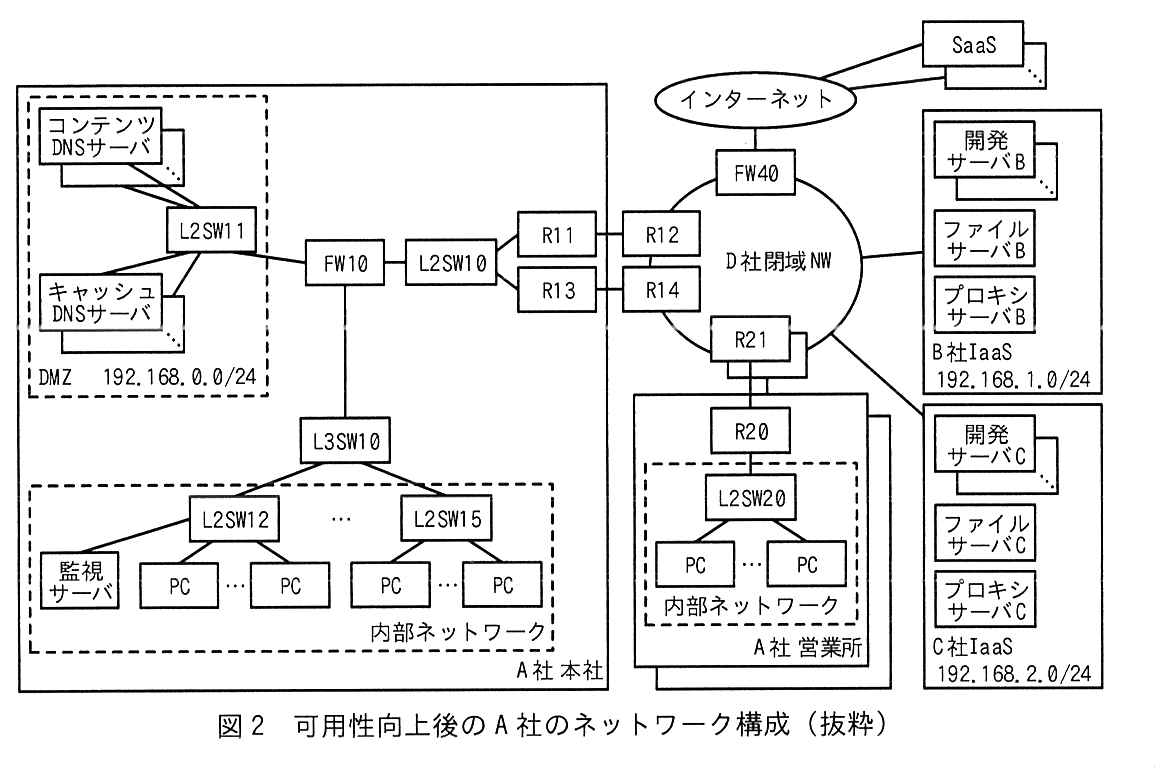
新規に C 社の IaaS を契約し,B 社 IaaS と併せたマルチクラウド環境にし,D 社閉域 NW 経由で利用する。 A 社本社と D 社閉域 NW との接続回線を追加し,マルチホーム接続とする。 インターネット接続を本社経由から D 社閉域 NW 経由に切り替える。 可用性向上後の A 社のネットワーク構成を図2に示す。
図2 可用性向上後の A 社のネットワーク構成(抜粋)
〔B 社と C 社の IaaS 利用〕
C 社からも,B 社と同様に管理コンソールが提供されている。B 社 IaaS に構築された仮想ネットワーク,仮想サーバと C 社 IaaS に構築された仮想ネットワーク,仮想サーバは D 社閉域 NW を経由して相互に通信できる。
E さんは,B 社と C 社の IaaS 利用方針を次のとおり策定した。
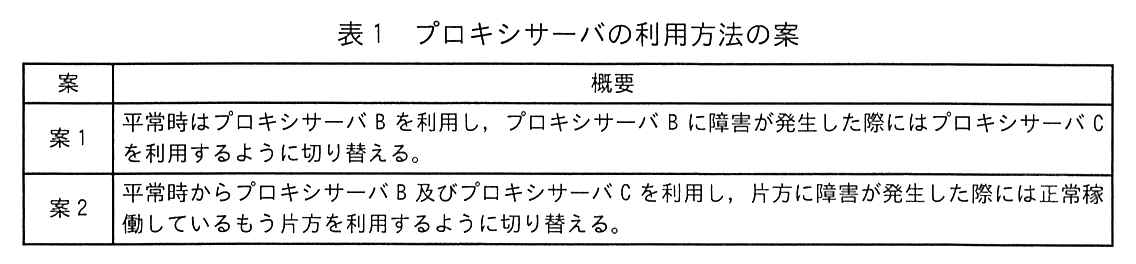
C 社 IaaS にファイルサーバC を新たに構築し,ファイルサーバB と常に同期をとるように設定する。A 社従業員はファイルサーバB 又はファイルサーバC を利用する。 B 社 IaaS にプロキシサーバB を,C 社 IaaS にプロキシサーバC を新たに構築し,プロキシサーバA から切り替える。 B 社 IaaS を利用して開発サーバB を,C 社 IaaS を利用して開発サーバC を構築し,A 社の担当部門に引き渡す。 〔プロキシサーバの利用方法の検討〕
E さんは,IaaS に構築するプロキシサーバB とプロキシサーバC の利用方法を検討した。プロキシサーバの利用方法の案を表1に示す。
表1 プロキシサーバの利用方法の案
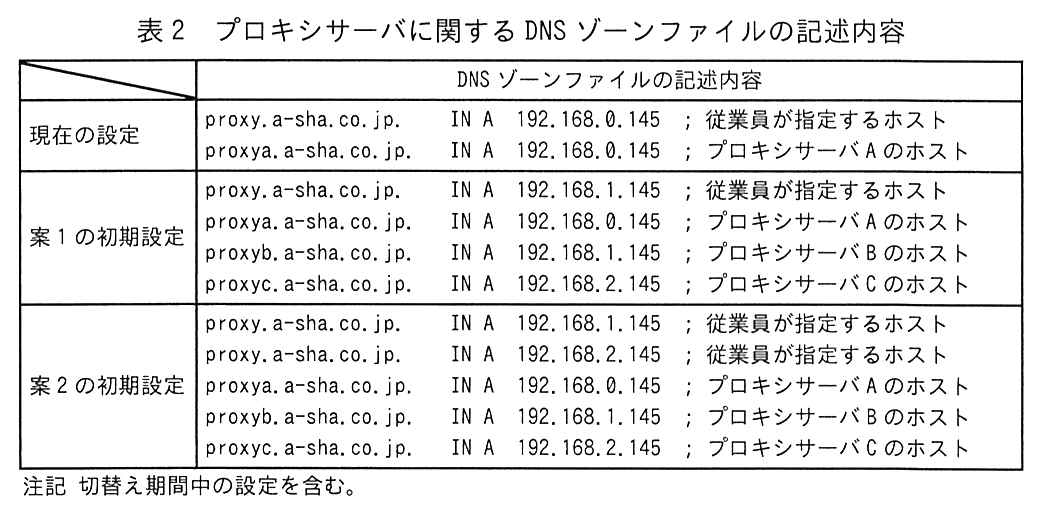
E さんは,従業員が利用するプロキシサーバを,DNS の機能を利用して制御することを考えた。プロキシサーバに障害が発生した際には,DNS の機能を利用して切り替える。
プロキシサーバに関する DNS ゾーンファイルの記述内容を表2に示す。
表2 プロキシサーバに関する DNS ゾーンファイルの記述内容
E さんは,プロキシサーバの監視運用について検討した。監視サーバで利用できる①ping 監視では不十分だと考え ,新たに TCP 監視機能を追加し,プロキシサーバのアプリケーションプロセスが動作するポート番号に TCP 接続可能か監視することにした。また,監視対象として,従業員がプロキシサーバとして指定するホストに加えて,プロキシサーバA,プロキシサーバB,プロキシサーバC のホストを設定することにした。
次に,監視サーバでプロキシサーバB の異常を検知した際に,従業員がプロキシサーバの利用を再開できるようにするための復旧方法として,②DNS ゾーンファイルの変更内容を案1,案2それぞれについて検討した 。また,③平常時から proxy.a-sha.co.jp に関するリソースレコードの TTL の値を小さくすることにした 。
これらの検討の結果,プロキシサーバの負荷分散ができること,及びプロキシサーバの有効活用ができることから案2の方が優れていると考え,E さんは案2を採用することにした。
さらに,E さんは,自動でプロキシサーバを切り替えるために,④DNS とは異なる方法で従業員が利用するプロキシサーバを切り替える方法も検討した 。プロキシサーバを利用する側の環境に依存することから,DNS ゾーンファイルの書換えによる切替えと併用することにした。
〔マルチホーム接続〕
次に,E さんは D 社閉域 NW とのマルチホーム接続について検討した。A 社本社に増設するルータ及び回線は D 社からネットワークサービスとして提供される。マルチホーム接続の設計について D 社担当者から説明を受けた。
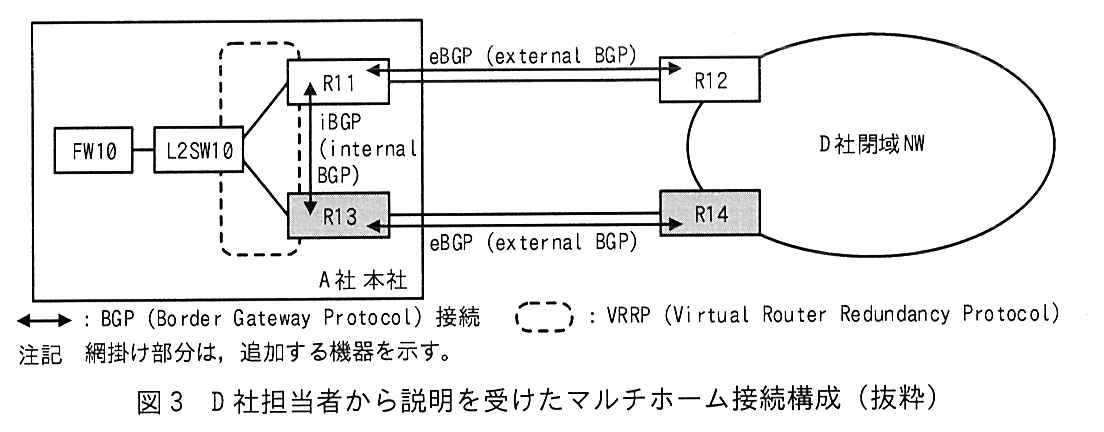
D 社担当者から説明を受けたマルチホーム接続構成を図3に示す。
図3 D 社担当者から説明を受けたマルチホーム接続構成(抜粋)
図3の概要は次のとおりである。
本社と D 社閉域 NW との間で,新たに R13 と専用線が D 社からネットワークサービスとして提供される。R11 と R13 とを併せてマルチホーム接続とする。 増設する専用線の契約帯域幅は既設の専用線と同じにし,平常時は既設の専用線を利用し,障害発生時には増設する専用線を利用する。 既存の R11 と R12 は,静的経路制御から BGP による動的経路制御に変更する。 R11 と R12 との間,R13 と R14 との間は eBGP で接続する。⑤R11 と R13 との間は iBGP で接続し,あわせて next-hop-self 設定を行う 。 R11 と R13 との間では VRRP を利用する。FW10 は VRRP で定義する仮想 IP アドレスをネクストホップとして静的経路設定を行う。 D 社担当者からの説明を受けた E さんは,BGP について調査した。
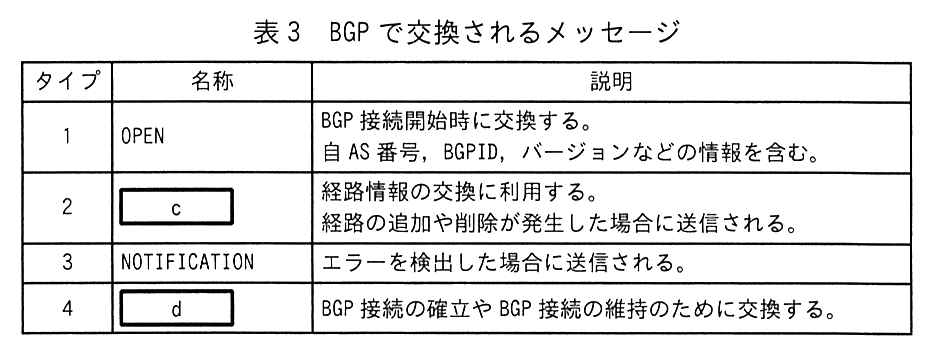
RFC 4271 で規定されている BGP は, a 間の経路交換のために作られたプロトコルで,TCP ポート 179 番を利用して接続し,経路交換を行う。経路交換を行う隣接のルータを b と呼ぶ。BGP で交換されるメッセージは 4 タイプあり,表3に示す。
表3 BGP で交換されるメッセージ
経路制御は, c メッセージに含まれる BGP パスアトリビュートの一つである LOCAL_PREF を利用して行うとの説明を D 社担当者から受けた。LOCAL_PREF は,iBGP ピアに対して通知する,外部の AS に存在する宛先ネットワークアドレスの優先度を定義する。BGP では,ピアリングで受信した経路情報を BGP テーブルとして構成し,最適経路選択アルゴリズムによって経路情報を一つだけ選択し,ルータの e に反映する。LOCAL_PREF の場合では,最も f 値をもつ経路情報が選択される。
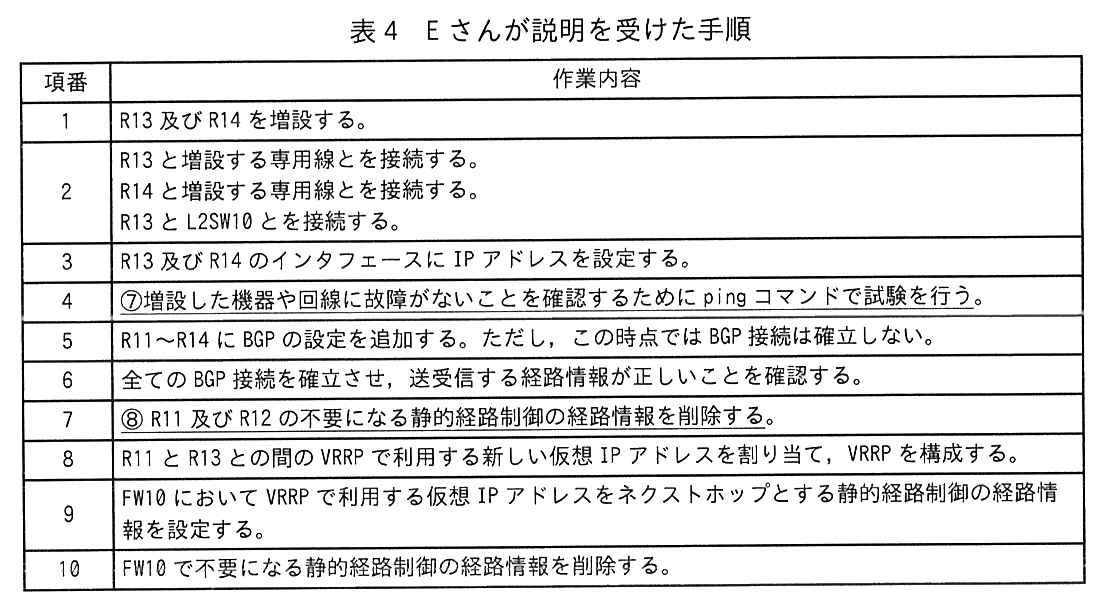
また,E さんは,D 社担当者から静的経路制御から BGP による動的経路制御に構成変更する手順の説明を受けた。この時,⑥BGP の導入を行った後に VRRP の導入を行う必要がある との説明だった。E さんが説明を受けた手順を表4に示す。
表4 E さんが説明を受けた手順
E さんは,設計どおりにマルチホームによる可用性向上が実現できたかどうかを確認するための障害試験を行うことにし,⑨想定する障害の発生箇所と内容を障害一覧としてまとめた 。
〔インターネット接続の切替え〕
次に,E さんはインターネット接続を本社経由から D 社閉域 NW 経由へ切り替えることについて検討した。
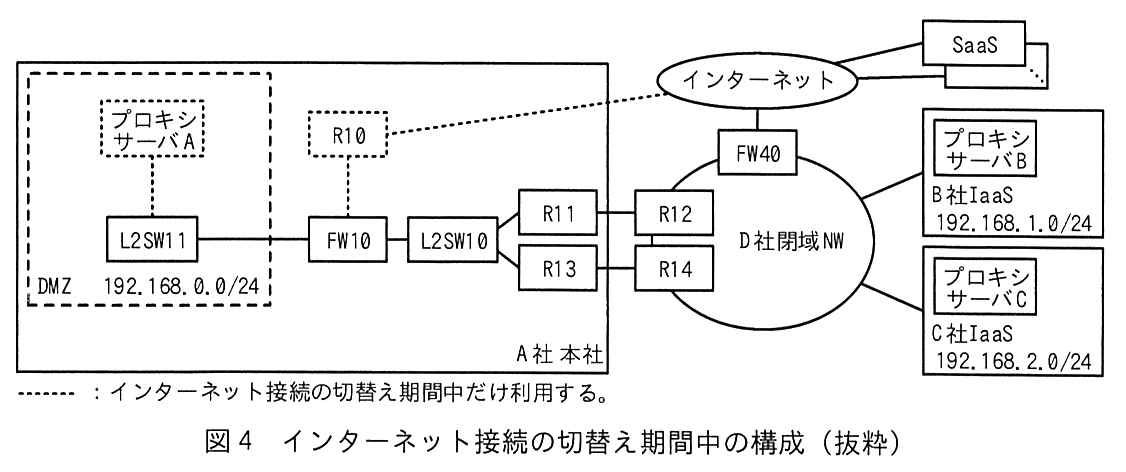
インターネット接続の切替え期間中の構成を図4に示す。
図4 インターネット接続の切替え期間中の構成(抜粋)
FW40 を使ってインターネット接続する。FW40 は D 社からネットワークサービスとして提供される。FW40 には新たにグローバル IP アドレスが割り当てられる。FW40 を経由するインターネット宛ての通信は NAPT 機能によって IP アドレスとポート番号の変換が行われる。A 社とインターネットとの通信を,R10 経由から FW40 経由になるようにインターネット接続を切り替える。
E さんは,設定変更の作業影響による通信断時間を極力短くするために,⑩FW10 の設定変更は D 社閉域 NW の設定変更とタイミングを合わせて実施する必要がある と考えた。
E さんは,⑪インターネット接続の切替えを行うと一部の部門で業務に影響がある と考えた。対策として,全てのインターネット宛ての通信は FW40 経由へと切り替えるが,⑫一定期間,プロキシサーバA からのインターネット宛ての通信だけは既存の R10 経由になるようにする 。あわせて,E さんは,業務に影響がある一部の部門には切替え期間中はプロキシサーバA が利用可能なことを案内するとともに,⑬恒久対応として設定変更の依頼 を事前に行うことにした。
E さんは,プロキシサーバA のログを定期的に調査し,利用がなくなったことを確認した後に,プロキシサーバA を廃止することにした。
E さんが検討した可用性向上の検討案は承認され,システム部では可用性向上プロジェクトを開始した。
出題趣旨(IPA)
オンプレミスからクラウドサービスへの移行が進み,クラウドサービスを利用する企業はますます増えている。業務環境の可用性についてクラウド事業者に依存する傾向が強くなり,事業継続性の観点から対策が必要となっている。また,企業の情報システム部門が,企業内部のクラウドサービス利用を全て把握することが困難なケースも想定される。本問では,マルチクラウド利用による可用性向上を題材として,BGPやVRRPを利用した可用性向上,これらを組み合わせたネットワーク構成の考慮点及びインターネット接続の変更に伴うグローバルIPアドレスの変更による影響と対策について問う。
設問と解答例
設問1(1)
表2中の案2の初期設定について,負荷分散を目的として一つのドメイン名に対して複数の IP アドレスを割り当てる方式名を答えよ。
解答例
解説
本文の根拠
表2 案2の初期設定
proxy.a-sha.co.jp. IN A 192.168.1.145 ; 従業員が指定するホスト,proxy.a-sha.co.jp. IN A 192.168.2.145 ; 従業員が指定するホスト
〔プロキシサーバの利用方法の検討〕
プロキシサーバの負荷分散ができること,及びプロキシサーバの有効活用ができることから案2の方が優れていると考え
同じドメイン名に A レコードを複数登録すると,DNS サーバは問合せのたびに応答の中のレコードの並び順を変えて返す。クライアントは多くの場合先頭のアドレスに接続するので,接続先が複数のサーバに散らばる。これを DNS ラウンドロビンという。
表2の案2の初期設定では,従業員が指定する proxy.a-sha.co.jp. に 192.168.1.145(プロキシサーバB)と 192.168.2.145(プロキシサーバC)の二つの A レコードが並んでいる。本文も案2の利点を「負荷分散ができること」としており,平常時から両方のプロキシサーバを使う案2の仕組みがこれに当たる。
間違えやすい点。DNS ラウンドロビンは応答の順番を変えるだけで,サーバの死活は見ていない。止まったサーバのアドレスも返し続けるので,本文は障害時に DNS ゾーンファイルを書き換える手順(下線②)を別に考えている。負荷分散装置(LB)による振分けとは別物である。
設問1(2)
40字以内
本文中の下線①について,ping 監視では不十分な理由を 40 字以内で答えよ。
解答例
プロキシサーバのアプリケーションプロセスが停止した場合に検知できないから
解説
本文の根拠
図1の概要
監視サーバは,ICMP を利用する死活監視(以下,ping 監視という)を用いて DMZ や IaaS にあるサーバの監視を行っている。
〔プロキシサーバの利用方法の検討〕
①ping 監視では不十分だと考え,新たに TCP 監視機能を追加し,プロキシサーバのアプリケーションプロセスが動作するポート番号に TCP 接続可能か監視することにした。
ping は ICMP Echo Request を送り,Echo Reply が返るかを見る(ICMP は RFC 792)。Echo Reply を返すのは OS の IP 処理なので,サーバの OS が動いていれば,その上のプロキシのアプリケーションプロセスが停止していても応答は返る。ping 監視ではサーバは正常に見えたまま,従業員はプロキシを使えなくなる。
本文は,ping 監視の代わりに「アプリケーションプロセスが動作するポート番号に TCP 接続可能か」を監視すると述べている。追加した監視が確かめているのはプロセスが待ち受けているかどうかであり,その裏返しが ping 監視では足りない理由になる。
字数の詰め方。解答例は36字。「アプリケーションプロセスが停止した場合」と「検知できない」の2点を残す。「OS は応答するので」のような仕組みの説明は字数が許せば足してよいが,止まったのがアプリケーションだという点を落とすと答えにならない。
設問1(3)
本文中の下線②について,表2の案1の初期設定を対象に,ドメイン名 proxy.a-sha.co.jp. の書換え後の IP アドレスを答えよ。
解答例
解説
本文の根拠
表1 案1
平常時はプロキシサーバB を利用し,プロキシサーバB に障害が発生した際にはプロキシサーバC を利用するように切り替える。
表2 案1の初期設定
proxy.a-sha.co.jp. IN A 192.168.1.145 ; 従業員が指定するホスト
表2 案1の初期設定
proxyc.a-sha.co.jp. IN A 192.168.2.145 ; プロキシサーバC のホスト
案1の初期設定では,従業員が指定する proxy.a-sha.co.jp. はプロキシサーバB の 192.168.1.145 を指している。下線②は監視サーバがプロキシサーバB の異常を検知したときの復旧方法なので,表1の案1のとおり,利用先をプロキシサーバC に切り替える。proxy.a-sha.co.jp. の A レコードを,proxyc.a-sha.co.jp. と同じ 192.168.2.145 に書き換えればよい。
図2でも C 社 IaaS のネットワークは 192.168.2.0/24 であり,プロキシサーバC のアドレスとして矛盾しない。
間違えやすい点。192.168.0.145 はプロキシサーバA のアドレスで,切替え期間が終われば廃止する予定のサーバである(〔インターネット接続の切替え〕)。案2なら 192.168.1.145 のレコードを消すだけでよいが,問われているのは案1である。
設問1(4)
40字以内
本文中の下線③について,TTL の値を小さくする目的を 40 字以内で答えよ。
解答例
キャッシュDNSサーバがキャッシュを保持する時間を短くするため
解説
本文の根拠
〔プロキシサーバの利用方法の検討〕
③平常時から proxy.a-sha.co.jp に関するリソースレコードの TTL の値を小さくすることにした。
図1の概要
キャッシュ DNS サーバは,PC やサーバからの問合せを受け,ほかの DNS サーバへ問い合わせた結果を応答する。
TTL(Time To Live)は,リソースレコードをキャッシュしてよい秒数である(RFC 1035)。キャッシュ DNS サーバは,コンテンツ DNS サーバから得た応答を TTL の間キャッシュし,その間は問合せを受けても古い結果を返す。障害時にゾーンファイルを書き換えても,TTL が長いと PC やサーバは故障したプロキシサーバのアドレスを引き続け,切替えが遅れる。
A 社ではキャッシュ DNS サーバが PC やサーバからの問合せを受けて結果を応答しており,ここにキャッシュが残る。TTL を小さくしておけばキャッシュがすぐ切れ,書き換えた A レコードが早く行き渡る。「平常時から」小さくするのは,障害が起きてから TTL を下げても,すでにキャッシュされたレコードは元の長い TTL のまま残るからである。
字数の詰め方。解答例は31字。「キャッシュ DNS サーバ」「キャッシュを保持する時間を短くする」を残す。「切替え後のアドレスが早く反映されるようにするため」のように目的の側から書いてもよい。
設問1(5)
解答欄2つ
本文中の下線④について,DNS とは異なる方法を 20 字以内で答えよ。また,その方法の制限事項を,プロキシサーバを利用する側の環境に着目して 25 字以内で答えよ。
解説
本文の根拠
〔プロキシサーバの利用方法の検討〕
④DNS とは異なる方法で従業員が利用するプロキシサーバを切り替える方法も検討した。
〔プロキシサーバの利用方法の検討〕
プロキシサーバを利用する側の環境に依存することから,DNS ゾーンファイルの書換えによる切替えと併用することにした。
図1の概要
従業員はプロキシサーバとして proxy.a-sha.co.jp を PC の Web ブラウザやサーバに指定している。
プロキシ自動設定(PAC:Proxy Auto-Config)は,Web ブラウザや OS に PAC ファイルの URL を設定しておき,そのファイルに書かれた JavaScript の関数でどのプロキシを使うかを決めさせる仕組みである。関数の戻り値には "PROXY proxyb…; PROXY proxyc…" のように複数のプロキシを並べられ,ブラウザは先頭のプロキシにつながらなければ次を試す。DNS を書き換えなくても,利用する側が自動で切り替える。
本文は,その方法が「プロキシサーバを利用する側の環境に依存する」と書いている。PAC を解釈できるのは対応した Web ブラウザや OS の機能だけで,A 社でプロキシを指定しているサーバ上のソフトウェアには,プロキシのホスト名を固定で指定するだけで PAC を読めないものがある。だから DNS による切替えと併用する。
字数の詰め方。方法は解答例16字で,「プロキシ自動設定」の名前があれば足りる(PAC ファイル,WPAD でも趣旨は同じ)。制限事項は解答例20字で,「対応する PC やサーバでしか」と対象を限る形にする。
採点講評(IPA)
設問1では,(5)の正答率が低かった。従業員が行う業務において,Webアプリケーションソフトウェアを利用する機会は増えており,Web閲覧の可用性向上は重要である。プロキシ自動設定機能は是非知っておいてもらいたい。
設問2(1)
解答欄6つ
本文中及び表3中の a 〜 f に入れる適切な字句を答えよ。
解説
本文の根拠
〔マルチホーム接続〕
RFC 4271 で規定されている BGP は, a 間の経路交換のために作られたプロトコルで,TCP ポート 179 番を利用して接続し,経路交換を行う。経路交換を行う隣接のルータを b と呼ぶ。
表3
タイプ2 c :経路情報の交換に利用する。経路の追加や削除が発生した場合に送信される。
表3
タイプ4 d :BGP 接続の確立や BGP 接続の維持のために交換する。
〔マルチホーム接続〕
最適経路選択アルゴリズムによって経路情報を一つだけ選択し,ルータの e に反映する。LOCAL_PREF の場合では,最も f 値をもつ経路情報が選択される。
a:BGP は AS(自律システム:一つの管理主体が経路制御の方針を決めるネットワークの単位)の間で経路を交換するためのプロトコルである。本文の LOCAL_PREF の説明にも「外部の AS」とある。b:TCP 179 番で接続して経路を交換する相手を BGP ピア(ネイバー)と呼ぶ。本文でも「iBGP ピア」「ピアリング」と使っている。
c・d:RFC 4271 が定めるメッセージは,タイプ1 OPEN,タイプ2 UPDATE,タイプ3 NOTIFICATION,タイプ4 KEEPALIVE の4つである。経路の追加(NLRI)や削除(Withdrawn Routes)を運ぶのが UPDATE,接続を保つために定期的に送るのが KEEPALIVE である。パスアトリビュート(LOCAL_PREF など)も UPDATE に入る。
e:BGP テーブルから選んだ最適経路を,実際のパケット転送に使うルーティングテーブルに載せる。f:LOCAL_PREF は値の大きい経路を優先する(既定値は多くの実装で100)。間違えやすい点として,MED は逆に小さい方が優先される。AS 内の優先度が LOCAL_PREF,隣の AS に伝える希望が MED と区別しておく。
設問2(2)
15字以内
本文中の下線⑤について,next-hop-self 設定を行うと,iBGP で広告する経路情報のネクストホップの IP アドレスには何が設定されるか。15 字以内で答えよ。
解答例
解説
本文の根拠
図3の概要
R11 と R12 との間,R13 と R14 との間は eBGP で接続する。⑤R11 と R13 との間は iBGP で接続し,あわせて next-hop-self 設定を行う。
BGP では,eBGP で受け取った経路を iBGP ピアに広告するとき,NEXT_HOP アトリビュートを書き換えずにそのまま渡すのが原則である。R11 が R12 から受け取った経路を R13 に渡すと,ネクストホップは R12 のアドレスのままになる。R13 は R12 と直接つながっておらず,そのアドレスへの経路を持たなければ,この経路を使えない。
next-hop-self を設定すると,iBGP で広告する経路のネクストホップを広告するルータ自身のアドレスに書き換える。R11 と R13 は同じ L2SW10 のセグメントにいるので,R13 から見ればネクストホップ R11 には直接届く。どちらか一方の専用線が切れても,もう一方のルータを経由して D 社閉域 NW に抜けられる。
字数の詰め方。解答例は9字。「自身の IP アドレス」だけでよい。「R11 の IP アドレス」のように特定のルータ名を書くと,R13 側の設定に当てはまらなくなる。
設問2(3)
解答欄2つ
表3について,BGP ピア間で定期的にやり取りされるメッセージを一つ選び,タイプで答えよ。また,そのメッセージが一定時間受信できなくなるとどのような動作をするか。30 字以内で答えよ。
解説
本文の根拠
表3
タイプ4 d :BGP 接続の確立や BGP 接続の維持のために交換する。
表3
タイプ2 c :経路情報の交換に利用する。経路の追加や削除が発生した場合に送信される。
BGP ピア間で定期的にやり取りされるのはタイプ4の KEEPALIVE である。UPDATE は経路の追加や削除が起きたときにしか送られないので,変化が無ければ流れない。そこで,ピアが生きていることを KEEPALIVE で確かめる。RFC 4271 では,OPEN で合意したホールドタイムの間に KEEPALIVE も UPDATE も届かなければ,ホールドタイマが満了したとして NOTIFICATION を送り,BGP 接続を閉じる。その相手から受け取っていた経路は無効になり,BGP テーブルから消える。
表3で「BGP 接続の維持のために交換する」とあるのが KEEPALIVE である。経路が消えれば最適経路選択がやり直され,もう一方の専用線の経路に切り替わる。これがマルチホームの切替えの仕組みになる。
字数の詰め方。動作は解答例22字。「BGP 接続を切断する」と「経路情報がクリアされる(削除される)」の2点を入れる。接続の切断だけでは,経路の切替えにつながる点が抜ける。
設問2(4)
50字以内
本文中の下線⑥について,BGP の導入を行った後に VRRP の導入を行うべき理由を,R13 が何らかの理由で VRRP マスターになったときの R13 の経路情報の状態を想定し,50 字以内で答えよ。
解答例
VRRPマスターになったR13が経路情報を保持していないと受信したパケットを転送できないから
解説
本文の根拠
〔マルチホーム接続〕
⑥BGP の導入を行った後に VRRP の導入を行う必要がある
図3の概要
R11 と R13 との間では VRRP を利用する。FW10 は VRRP で定義する仮想 IP アドレスをネクストホップとして静的経路設定を行う。
表4 項番3
R13 及び R14 のインタフェースに IP アドレスを設定する。
VRRP を構成すると,FW10 が仮想 IP アドレスに送ったパケットは,そのときのマスターが受け取る。増設したばかりの R13 は,BGP を導入する前は D 社閉域 NW 向けの経路を持っていない(表4 項番3までで設定したのはインタフェースのアドレスだけ)。この状態で R13 が何らかの理由でマスターになると,R13 は受け取ったパケットの宛先への経路が無く,捨ててしまう。
先に BGP を導入すれば,R13 は R14 との eBGP と R11 との iBGP で経路を受け取っている。どちらのルータがマスターになっても転送できる状態を作ってから VRRP を入れる,という順序である。
字数の詰め方。解答例は46字。「VRRP マスターになった R13」「経路情報を保持していない」「受信したパケットを転送できない」の3つを因果の順につなぐ。経路が無いことだけ書いて,パケットが落ちるという結果を書かないと理由として弱い。
採点講評(IPA)
設問2では,(4)の正答率がやや低かった。BGPやVRRPといったプロトコルを導入する過程において,ルータの経路情報がどのように変化するか,具体的にイメージできるようしっかり理解をしてほしい。
設問2(5)
解答欄3つ
表4中の下線⑦について,ping コマンドの試験で確認すべき内容を 20 字以内で答えよ。また,ping コマンドの試験で確認すべき送信元と宛先の組合せを二つ 挙げ,図3中の機器名で答えよ。
〔①〕解答例
送信元 R13,宛先 FW10 送信元 FW10,宛先 R13 送信元 R13,宛先 R11 送信元 R11,宛先 R13
〔②〕解答例
送信元 R13,宛先 R14 送信元 R14,宛先 R13
〔備考〕①と②は順不同
解説
本文の根拠
表4 項番4
⑦増設した機器や回線に故障がないことを確認するために ping コマンドで試験を行う。
表4 項番2
R13 と増設する専用線とを接続する。R14 と増設する専用線とを接続する。R13 と L2SW10 とを接続する。
項番2で増設した接続は,R13 と R14 を結ぶ専用線と,R13 と L2SW10 の間の2本である。ping で故障の有無を確かめるなら,それぞれを通る組合せで試す。専用線は R13 と R14 の間(どちら向きでもよい)。R13 と L2SW10 の間は,同じセグメントにいる FW10 か R11 と R13 の間で試す。これで R13・R14 と2本の回線を全部通る。
確認すべき内容は,応答が返ることだけでなく,パケットロスが発生しないことである。回線の品質不良やインタフェースの不調は,応答は返るが一部が落ちるという形で現れることが多い。ある程度の回数を送ってロスが無いことを見る。
字数の詰め方。確認すべき内容は解答例14字。「パケットロスが発生しない」と言い切る。組合せの①②は順不同で,送信元と宛先を逆にしてもよい。R11 と FW10 のように,増設した機器を通らない組合せは答えにならない。
設問2(6)
40字以内
表4中の下線⑧について,R11 及び R12 では静的経路制御の経路情報を削除することで同じ宛先ネットワークの BGP の経路情報が有効になる。その理由を 40 字以内で答えよ。
解答例
経路情報は,BGPと比較して静的経路制御の方が優先されるから
解説
本文の根拠
表4 項番7
⑧R11 及び R12 の不要になる静的経路制御の経路情報を削除する。
図3の概要
既存の R11 と R12 は,静的経路制御から BGP による動的経路制御に変更する。
ルータは,同じ宛先への経路を複数の経路制御の方法(静的経路,OSPF,BGP など)から知ったとき,方法ごとに決めた優先度で一つを選んでルーティングテーブルに載せる。この優先度は実装ごとの値で(アドミニストレーティブディスタンスなどと呼ばれる),多くのルータで静的経路は BGP より優先される。R11 と R12 に静的経路が残っていると,項番6で BGP 接続を確立しても,同じ宛先の BGP の経路はテーブルに入らない。
項番6で BGP の経路が正しく送受信されていることを確かめてから,項番7で静的経路を消す。消した時点で BGP の経路がテーブルに反映される。この順にすることで,経路の無い時間を作らずに切り替えられる。
字数の詰め方。解答例は30字。「BGP と比較して静的経路制御の方が優先される」が核心で,「経路情報は」の主語も添える。「静的経路の方が信頼できるから」のような理由付けは,優先順位の仕組みを言っていないので避ける。
設問2(7)
解答欄6つ
本文中の下線⑨について,想定する障害を六つ 挙げ,それぞれの障害発生箇所を答えよ。ただし,R12 と R14 については D 社で障害試験実施済みとする。
解説
本文の根拠
〔マルチホーム接続〕
⑨想定する障害の発生箇所と内容を障害一覧としてまとめた。
図3の概要
増設する専用線の契約帯域幅は既設の専用線と同じにし,平常時は既設の専用線を利用し,障害発生時には増設する専用線を利用する。
図3
A 社本社で FW10 が L2SW10 に接続し,L2SW10 が R11 と R13 に接続している。
マルチホームで冗長化したのは,図3の R11 と R13 から先の2系統である。1系統は L2SW10-R11-(既設の専用線)-R12,もう1系統は L2SW10-R13-(増設の専用線)-R14 になっている。障害試験では,この2系統の上で壊れうる箇所を一つずつ止め,もう一方に切り替わることを確かめる。
2系統の構成要素を並べると,機器は R11,R12,R13,R14,回線は R11-R12,R13-R14,R11-L2SW10,R13-L2SW10 の各回線である。このうち R12 と R14 は D 社で試験済みとされているので除く。残る R11,R13 と4本の回線の計六つが答えになる。FW10 と L2SW10 は1台ずつで冗長化されていないので,マルチホームの試験の対象ではない。
間違えやすい点。回線は「R11 と R12 とを接続する回線」のように両端を書いて特定する。「専用線」だけでは既設か増設かが分からない。L2SW10 側の回線は VRRP の切替え(マスターの交代)を確かめる試験になり,専用線側は BGP の経路の切替えを確かめる試験になる。六つはどの順で書いてもよい。
設問3(1)
25字以内
本文中の下線⑩について,D 社閉域 NW の設定変更より前に FW10 のデフォルトルートの設定変更を行うとどのような状況になるか。25 字以内で答えよ。
解答例
解説
本文の根拠
〔インターネット接続の切替え〕
⑩FW10 の設定変更は D 社閉域 NW の設定変更とタイミングを合わせて実施する必要がある
図1の概要
A 社は,本社設置の R10 を経由してインターネットに接続している。
〔インターネット接続の切替え〕
A 社とインターネットとの通信を,R10 経由から FW40 経由になるようにインターネット接続を切り替える。
切替え前は,A 社のインターネット接続の出口は本社の R10 である。営業所や IaaS からインターネットに向かうパケットも本社を通るので,D 社閉域 NW のデフォルトルートは A 社本社(R11 や R13)を向いている。一方,切替え後の FW10 のデフォルトルートは,R10 ではなく D 社閉域 NW 側(R11 と R13 の VRRP の仮想 IP アドレス)を向く。
D 社閉域 NW の設定を変える前に FW10 だけを切り替えると,FW10 はインターネット宛てのパケットを D 社閉域 NW に送り,D 社閉域 NW はそれを本社に送り返す。パケットは FW10 と D 社閉域 NW の間を TTL が尽きるまで往復し,インターネットに出られない。これがルーティングのループである。だから D 社閉域 NW のデフォルトルートを FW40 に向ける変更と同時に行う。
字数の詰め方。解答例は16字。「ルーティングのループが発生する」と現象の名前で言い切る。「通信できなくなる」だけでは,なぜタイミングを合わせるのかが伝わらない。
採点講評(IPA)
設問3では,(1)の正答率がやや低かった。設定変更に伴うネットワークに対する影響を問う問題であるが,インターネットが利用不可になるなどの解答が散見された。ネットワーク技術者として根本の原因を突き止め,インターネットが利用不可になるのはなぜなのか,技術的な内容を解答してほしい。
設問3(2)
20字以内
本文中の下線⑪について,業務に影響が発生する理由を 20 字以内で答えよ。
解答例
解説
本文の根拠
〔インターネット接続の切替え〕
⑪インターネット接続の切替えを行うと一部の部門で業務に影響がある
図1の概要
これらの SaaS では送信元 IP アドレスによってアクセス制限をしているものもある。
〔インターネット接続の切替え〕
FW40 には新たにグローバル IP アドレスが割り当てられる。FW40 を経由するインターネット宛ての通信は NAPT 機能によって IP アドレスとポート番号の変換が行われる。
今は,インターネット宛ての通信は FW10 の NAPT で FW10 のグローバル IP アドレスに変換されてから出ていく。切替え後は FW40 の NAPT で,FW40 に新たに割り当てられたグローバル IP アドレスに変換される。SaaS から見た A 社の送信元 IP アドレスが変わる。
一部の部門が独自に契約した SaaS には,送信元 IP アドレスでアクセスを制限しているものがある。そうした SaaS は FW10 のアドレスだけを許可しているので,切替え後は A 社からのアクセスを拒否する。影響が「一部の部門」に限られるのはこのためで,全部門で使う SaaS には送信元の制限の話は出てこない。
字数の詰め方。解答例は15字。「送信元 IP アドレスが変わる」が核心である。アクセス制限で拒否されるという結果まで書ければよりよいが,20字に収めるなら原因を優先する。
設問3(3)
70字以内
本文中の下線⑫について,FW10 にどのようなポリシーベースルーティング設定が必要か。70 字以内で答えよ。
解答例
送信元IPアドレスがプロキシサーバAで宛先IPアドレスがインターネットであった場合にネクストホップをR10とする設定
解説
本文の根拠
〔インターネット接続の切替え〕
⑫一定期間,プロキシサーバA からのインターネット宛ての通信だけは既存の R10 経由になるようにする。
〔インターネット接続の切替え〕
業務に影響がある一部の部門には切替え期間中はプロキシサーバA が利用可能なことを案内する
図4
A 社本社では,FW10 に DMZ(192.168.0.0/24)の L2SW11,R10,L2SW10 が接続している。
ポリシーベースルーティングは,宛先だけで経路を決める通常のルーティングと違い,送信元などの条件に合うパケットだけ別のネクストホップに送る機能である。切替え後の FW10 のデフォルトルートは D 社閉域 NW 側を向くが,プロキシサーバA が送るインターネット宛てのパケットだけは R10 に送りたい。条件は「送信元がプロキシサーバA」かつ「宛先がインターネット」,動作は「ネクストホップを R10 にする」である。
こうしておけば,送信元 IP アドレスで制限された SaaS を使う部門は,切替え期間中もプロキシサーバA 経由で,これまでと同じ FW10 のグローバル IP アドレスからアクセスできる。図4で R10 とプロキシサーバA が点線(切替え期間中だけ利用)になっているのはこのためである。
字数の詰め方。解答例は58字。送信元の条件,宛先の条件,ネクストホップの3つを全部入れる。宛先の条件を落とすと,プロキシサーバA から社内や IaaS への通信まで R10 に向かってしまう。
設問3(4)
40字以内
本文中の下線⑬について,どのような設定変更を依頼すればよいか。40 字以内で答えよ。
解答例
SaaSの送信元IPアドレスによるアクセス制限の設定変更
解説
本文の根拠
〔インターネット接続の切替え〕
⑬恒久対応として設定変更の依頼を事前に行うことにした。
図1の概要
A 社の一部の部門では,担当する業務に応じてインターネット上の SaaS を独自に契約し,利用している。これらの SaaS では送信元 IP アドレスによってアクセス制限をしているものもある。
プロキシサーバA 経由の迂回は,切替え期間中だけの暫定策である。プロキシサーバA はいずれ廃止するので,恒久的には SaaS 側で許可する送信元 IP アドレスを,FW10 のアドレスから FW40 に割り当てられたグローバル IP アドレスに変えてもらう必要がある。
これらの SaaS は一部の部門が独自に契約しているので,システム部が直接設定を変えることはできない。そこで該当部門に,SaaS の送信元 IP アドレスによるアクセス制限の設定変更を事前に依頼する。本文でも,プロキシサーバA のログで利用が無くなったことを確かめてから廃止するとしており,各部門の設定変更が済んだかを確かめる手順になっている。
字数の詰め方。解答例は28字。「SaaS の」「送信元 IP アドレスによるアクセス制限の」「設定変更」を残す。字数に余裕があれば「FW40 のグローバル IP アドレスを許可するように」と変更の中身を足してよい。
出典:令和5年度 春期 ネットワークスペシャリスト試験 午後Ⅱ 問1(表記を一部改変)
問2 EC サーバの増強
EC サーバの増強に関する次の記述を読んで,設問に答えよ。
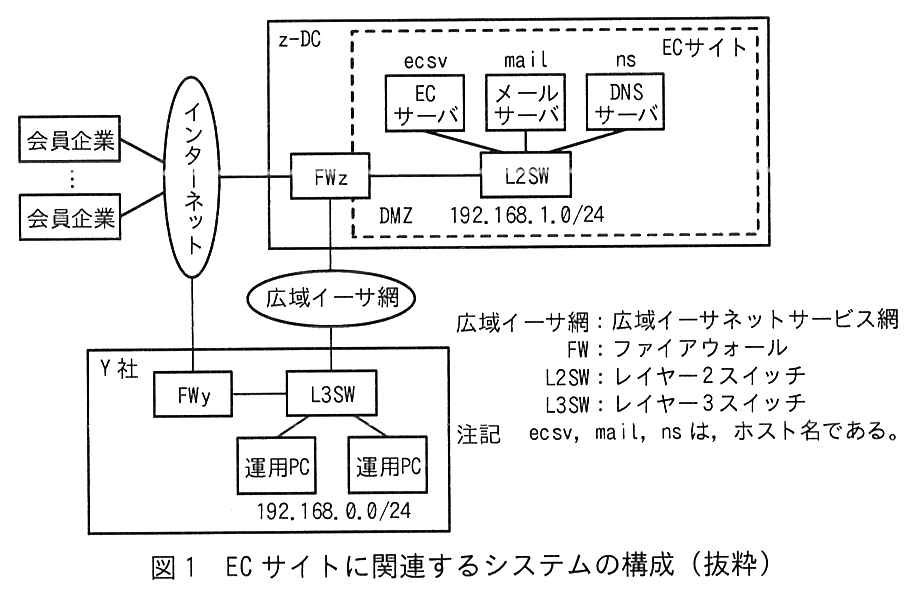
Y 社は,従業員 300 名の事務用品の販売会社であり,会員企業向けにインターネットを利用して通信販売を行っている。EC サイトは,Z 社のデータセンター(以下,z-DC という)に構築されており,Y 社の運用 PC を使用して運用管理を行っている。
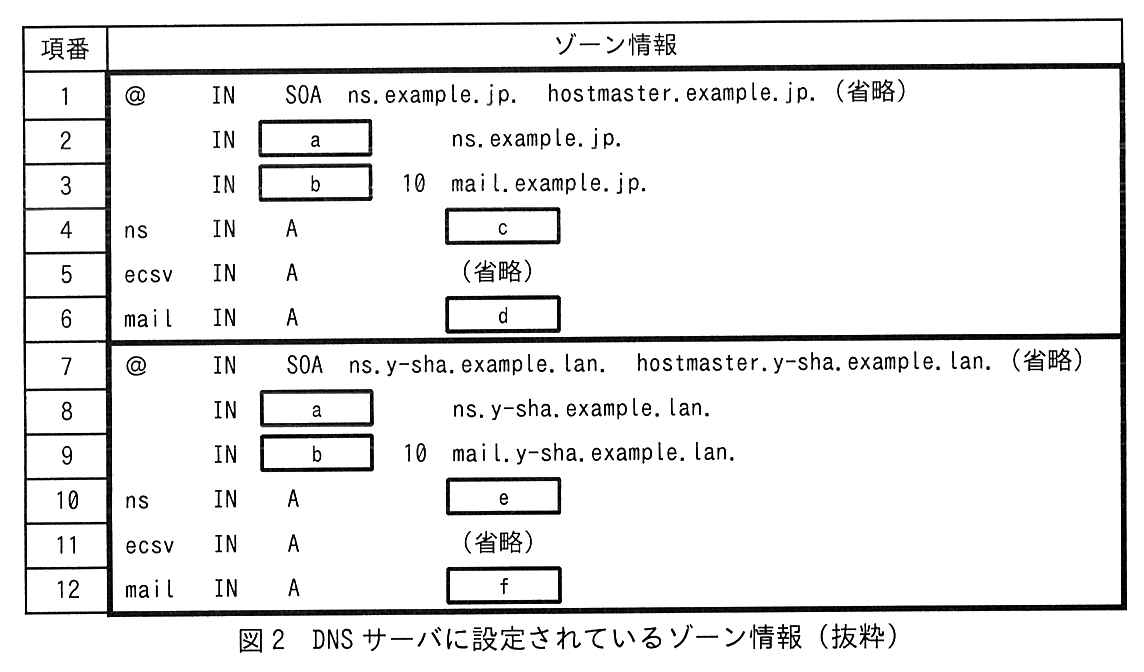
EC サイトに関連するシステムの構成を図1に示し,DNS サーバに設定されているゾーン情報を図2に示す。
図1 EC サイトに関連するシステムの構成(抜粋)
図2 DNS サーバに設定されているゾーン情報(抜粋)
〔EC サイトに関連するシステムの構成,運用及びセッション管理方法〕
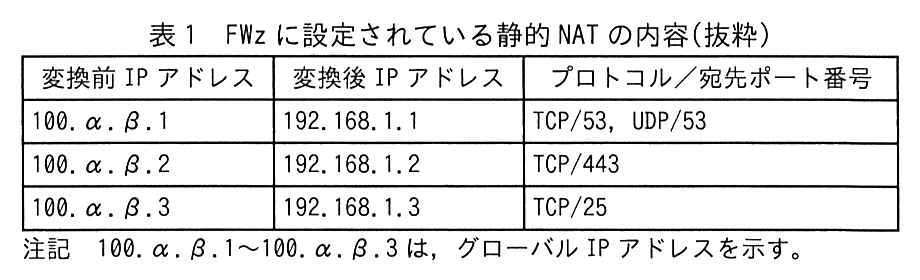
会員企業の事務用品購入の担当者(以下,購買担当者という)は,Web ブラウザで https://ecsv.example.jp/ を指定して EC サーバにアクセスする。 運用担当者は,運用 PC の Web ブラウザで https://ecsv.y-sha.example.lan/ を指定して,広域イーサ網経由で EC サーバにアクセスする。 EC サーバに登録されているサーバ証明書は一つであり,マルチドメインに対応していない。 EC サーバは,アクセス元の IP アドレスなどをログとして管理している。 DMZ の DNS サーバは,EC サイトのインターネット向けドメイン example.jp と,社内向けドメイン y-sha.example.lan の二つのドメインのゾーン情報を管理する。 L3SW には,DMZ への経路とデフォルトルートが設定されている。 運用 PC は,DMZ の DNS サーバで名前解決を行う。 FWz には,表1に示す静的 NAT が設定されている。
表1 FWz に設定されている静的 NAT の内容(抜粋)
EC サーバは,次の方法でセッション管理を行っている。
Web ブラウザから最初にアクセスを受けたときに,ランダムな値のセッション ID を生成する。 Web ブラウザへの応答時に,Cookie にセッション ID を書き込んで送信する。 Web ブラウザによる EC サーバへのアクセスの開始から終了までの一連の通信を,セッション ID を基に,同一のセッションとして管理する。 〔EC サイトの応答速度の低下〕
最近,購買担当者から,EC サイト利用時の応答が遅くなったというクレームが入るようになった。そこで,Y 社の情報システム部(以下,情シスという)のネットワークチームの X 主任は,運用 PC を使用して次の手順で原因究明を行った。
(1) 購買担当者と同じ URL でアクセスし,応答が遅いことを確認した。 (2) ecsv.example.jp 及び ecsv.y-sha.example.lan 宛てに,それぞれ ping コマンドを発行して応答時間を測定したところ,両者の測定結果に大きな違いはなかった。 (3) FWz のログからはサイバー攻撃の兆候は検出されなかった。 (4) ssh コマンドで①ecsv.y-sha.example.lan にアクセス して CPU 使用率を調べたところ,設計値を大きく超えていた。 この結果から,X 主任は,EC サーバが処理能力不足になったと判断した。
〔EC サーバの増強構成の設計〕
X 主任は,EC サーバの増強が必要になったことを上司の W 課長に報告し,W 課長から EC サーバの増強構成の設計指示を受けた。
EC サーバの増強策としてスケール g 方式とスケール h 方式を比較検討し,EC サイトを停止せずに EC サーバの増強を行える,スケール h 方式を採用することを考えた。
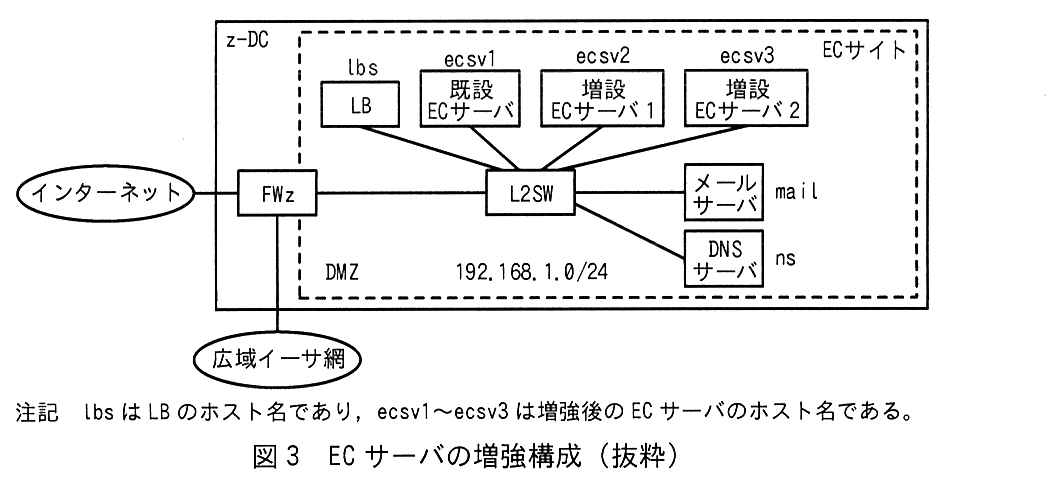
X 主任は,②EC サーバを 2 台にすれば EC サイトは十分な処理能力をもつことになるが,2 台増設して 3 台にし ,負荷分散装置(以下,LB という)によって処理を振り分ける構成を設計した。EC サーバの増強構成を図3に示し,DNS サーバに追加する社内向けドメインのリソースレコードを図4に示す。
図3 EC サーバの増強構成(抜粋)
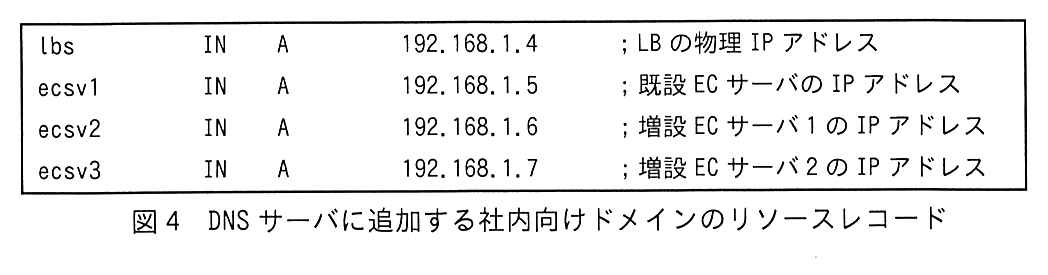
図4 DNS サーバに追加する社内向けドメインのリソースレコード
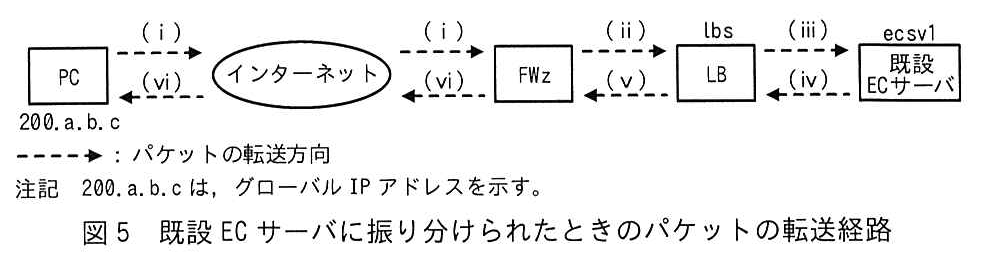
EC サーバ増強後,購買担当者が Web ブラウザで https://ecsv.example.jp/ を指定して EC サーバにアクセスし,アクセス先が既設 EC サーバに振り分けられたときのパケットの転送経路を図5に示す。
図5 既設 EC サーバに振り分けられたときのパケットの転送経路
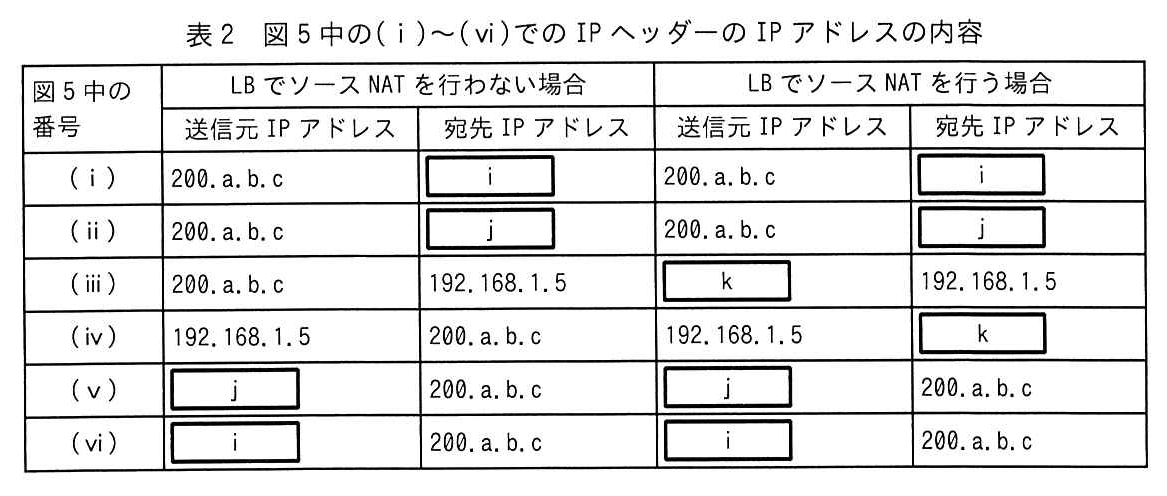
導入する LB には,負荷分散用の IP アドレスである仮想 IP アドレスで受信したパケットを EC サーバに振り分けるとき,送信元 IP アドレスを変換する方式(以下,ソース NAT という)と変換しない方式の二つがある。図5中の(ⅰ)〜(ⅵ)での IP ヘッダーの IP アドレスの内容を表2に示す。
表2 図5中の(ⅰ)〜(ⅵ)での IP ヘッダーの IP アドレスの内容
〔EC サーバの増強構成と LB の設定〕
X 主任が設計した内容を W 課長に説明したときの,2 人の会話を次に示す。
X 主任:LB を利用して EC サーバを増強する構成を考えました。購買担当者が EC サーバにアクセスするときの URL の変更は不要です。 W 課長:DNS サーバに対しては,図4のレコードを追加するだけで良いのでしょうか。 X 主任:そうです。EC サーバの増強後も,図2で示したゾーン情報の変更は不要ですが,③図2中の項番5と項番11のリソースレコードは,図3の構成では図1とは違う機器の特別な IP アドレスを示す ことになります。また,④図4のリソースレコードの追加に対応して,既設 EC サーバに設定されている二つの情報を変更します 。 W 課長:分かりました。LB ではソース NAT を行うのでしょうか。 X 主任:現在の EC サーバの運用を変更しないために,ソース NAT は行わない予定です。この場合,パケットの転送を図5の経路にするために,⑤既設 EC サーバでは,デフォルトゲートウェイの IP アドレスを変更します 。 W 課長:次に,EC サーバのメンテナンス方法を説明してください。 X 主任:はい。まず,メンテナンスを行う EC サーバを負荷分散の対象から外し,その後に,運用 PC から当該 EC サーバにアクセスして,メンテナンス作業を行います。 W 課長:X 主任が考えている設定では,運用 PC から EC サーバとは通信できないと思いますが,どうでしょうか。 X 主任:うっかりしていました。導入予定の LB はルータとしては動作しませんから,ご指摘の問題が発生してしまいます。対策方法として,EC サーバに設定するデフォルトゲートウェイを図1の構成時のままとし,LB ではソース NAT を行うとともに,⑥EC サーバ宛てに送信する HTTP ヘッダーに X-Forwarded-For フィールドを追加する ようにします。 W 課長:それで良いでしょう。ところで,図3の構成では,増設 EC サーバにもサーバ証明書をインストールすることになるのでしょうか。 X 主任:いいえ。増設 EC サーバにはインストールせずに⑦既設 EC サーバ内のサーバ証明書の流用で対応できます 。 W 課長:分かりました。負荷分散やセッション維持などの方法は設計済みでしょうか。 X 主任:構成が決まりましたので,これから LB の制御方式について検討します。 〔LB の制御方式の検討〕
X 主任は,導入予定の LB がもつ負荷分散機能,セッション維持機能,ヘルスチェック機能の三つについて調査し,次の方式を利用することにした。
アクセス元であるクライアントからのリクエストを,負荷分散対象のサーバに振り分ける機能である。Y 社の EC サーバは,リクエストの内容によってサーバに掛かる負荷が大きく異なるので,EC サーバにエージェントを導入し,エージェントが取得した情報を基に,EC サーバに掛かる負荷の偏りを小さくすることが可能な動的振分け方式を利用する。
同一のアクセス元からのリクエストを,同一セッションの間は同じサーバに転送する機能である。アクセス元の識別は,IP アドレス,IP アドレスとポート番号との組合せ,及び Cookie に記録された情報によって行う,三つの方式がある。IP アドレスでアクセス元を識別する場合,インターネットアクセス時に送信元 IP アドレスが同じアドレスになる会員企業では,複数の購買担当者がアクセスする EC サーバが同一になってしまう問題が発生する。⑧IP アドレスとポート番号との組合せでアクセス元を識別する場合は,TCP コネクションが切断されると再接続時にセッション維持ができなくなる問題が発生する 。そこで,⑨Cookie 中のセッション ID と振分け先のサーバから構成されるセッション管理テーブルを LB が作成 し,このテーブルを使用してセッションを維持する方式を利用する。
振分け先のサーバの稼働状態を定期的に監視し,障害が発生したサーバを負荷分散の対象から外す機能である。⑩ヘルスチェックは,レイヤー3,4 及び 7 の各レイヤーで稼働状態を監視する方式があり,ここではレイヤー7 方式を利用する 。
X 主任が,LB の制御方式の検討結果を W 課長に説明した後,W 課長から新たな検討事項の指示を受けた。そのときの,2 人の会話を次に示す。
W 課長:運用チームから,EC サイトのアカウント情報の管理負荷が大きくなってきたので,管理負荷の軽減策の検討要望が挙がっています。会員企業からは,自社で管理しているアカウント情報を使って EC サーバにログインできるようにして欲しいとの要望があります。これらの要望に応えるために,EC サーバの SAML2.0(Security Assertion Markup Language 2.0)への対応について検討してください。 X 主任:分かりました。検討してみます。 〔SAML2.0 の調査と EC サーバへの対応の検討〕
X 主任が SAML2.0 について調査して理解した内容を次に示す。
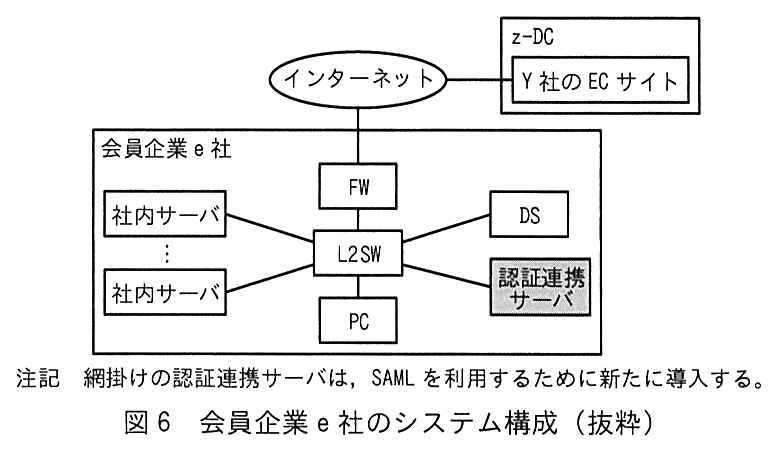
SAML は,認証・認可の要求/応答のプロトコルとその情報を表現するための標準規格であり,一度の認証で複数のサービスが利用できるシングルサインオン(以下,SSO という)を実現することができる。 SAML では,利用者にサービスを提供する SP(Service Provider)と,利用者の認証・認可の情報を SP に提供する IdP(Identity Provider)との間で,情報の交換を行う。 IdP は,SAML アサーションと呼ばれる XML ドキュメントを作成し,利用者を介して SP に送信する。SAML アサーションには,次の三つの種類がある。 (a) 利用者が IdP にログインした時刻,場所,使用した認証の種類などの情報が記述される。 (b) 利用者の名前,生年月日など利用者を識別する情報が記述される。 (c) 利用者がもつサービスを利用する権限などの情報が記述される。 SP は,IdP から提供された SAML アサーションを基に,利用者にサービスを提供する。 IdP,SP 及び利用者間の情報の交換方法は,SAML プロトコルとしてまとめられており,メッセージの送受信には HTTP などが使われる。 z-DC で稼働する Y 社の EC サーバが SAML の SP に対応すれば,購買担当者は,自社内のディレクトリサーバ(以下,DS という)などで管理するアカウント情報を使って,EC サーバに安全に SSO でアクセスできる。 X 主任は,ケルベロス認証を利用して社内のサーバに SSO でアクセスしている会員企業 e 社を例として取り上げ,e 社内の PC が SAML を利用して Y 社の EC サーバにも SSO でアクセスする場合のシステム構成及び通信手順について考えた。
会員企業 e 社のシステム構成を図6に示す。
図6 会員企業 e 社のシステム構成(抜粋)
図6で示した会員企業 e 社のシステムの概要を次に示す。
e 社ではケルベロス認証を利用し,社内サーバに SSO でアクセスしている。 e 社内の DS は,従業員のアカウント情報を管理している。 PC 及び社内サーバは,それぞれ自身の共通鍵を保有している。 DS は,PC 及び社内サーバそれぞれの共通鍵の管理を行うとともに,チケットの発行を行う鍵配布センター(以下,KDC という)機能をもっている。 KDC が発行するチケットには,PC の利用者の身分証明書に相当するチケット(以下,TGT という)と PC の利用者がアクセスするサーバで認証を受けるためのチケット(以下,ST という)の 2 種類がある。 認証連携サーバは IdP として働き,ケルベロス認証と SAML との間で認証連携を行う。 X 主任は,e 社内の PC から Y 社の EC サーバに SAML を利用して SSO でアクセスするときの通信手順と処理の概要を,次のようにまとめた。
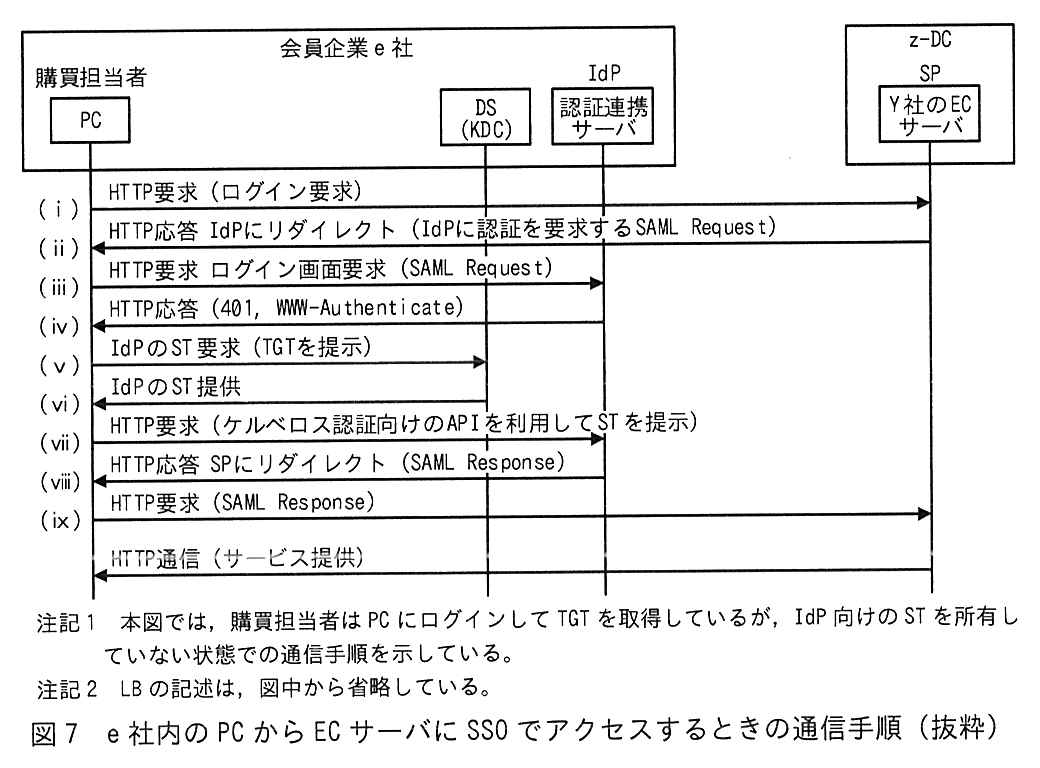
e 社内の PC から EC サーバに SSO でアクセスするときの通信手順を図7に示す。
図7 e 社内の PC から EC サーバに SSO でアクセスするときの通信手順(抜粋)
図7中の,(ⅰ)〜(ⅸ)の処理の概要を次に示す。
(ⅰ) 購買担当者が PC を使用して EC サーバにログイン要求を行う。 (ⅱ) SP である EC サーバは,⑪SAML 認証要求(SAML Request)を作成し IdP である認証連携サーバにリダイレクトを要求する応答を行う 。ここで,EC サーバには,⑫IdP が作成するデジタル署名の検証に必要な情報 などが設定され,IdP との間で信頼関係が構築されている。 (ⅲ) PC は SAML Request を IdP に転送する。 (ⅳ) IdP は PC に認証を求める。 (ⅴ) PC は,KDC に TGT を提示して IdP へのアクセスに必要な ST の発行を要求する。 (ⅵ) KDC は,TGT を基に,購買担当者の身元情報やセッション鍵が含まれた ST を発行し,IdP の鍵で ST を暗号化する。さらに,KDC は,暗号化した ST にセッション鍵などを付加し,全体を PC の鍵で暗号化した情報を PC に払い出す。 (ⅶ) PC は,⑬受信した情報の中から ST を取り出し ,ケルベロス認証向けの API を利用して,ST を IdP に提示する。 (ⅷ) IdP は,ST の内容を基に購買担当者を認証し,デジタル署名付きの SAML アサーションを含む SAML 応答(SAML Response)を作成して,SP にリダイレクトを要求する応答を行う。 (ⅸ) PC は,SAML Response を SP に転送する。SP は,SAML Response に含まれる⑭デジタル署名を検証 し,検証結果に問題がない場合,SAML アサーションを基に,購買担当者が正当な利用者であることの確認,及び購買担当者に対して提供するサービス範囲を定めた利用権限の付与の,二つの処理を行う。 X 主任は,EC サーバの SAML2.0 対応の検討結果を基に,SAML2.0 に対応する場合の EC サーバプログラムの改修作業の概要を W 課長に説明した。
W 課長は,X 主任の設計した EC サーバの増強案,及び SAML2.0 対応のための EC サーバの改修などについて,経営会議で提案して承認を得ることができた。
出題趣旨(IPA)
インターネット上でサービスを提供するシステムは,顧客数の変化に対応して適切な処理能力をもつ構成を維持することが重要である。また,登録する顧客数の増加によって,顧客のアカウント情報の管理負荷も増大するので,異なるドメイン間で認証,認可情報の交換が可能な認証連携技術の活用も求められる。このような状況を基に,本問では,サーバ負荷分散装置(以下,LBという)によってシステムの処理能力を増強させる構成設計と,SAML2.0を利用するための方式検討を事例として取り上げた。本問では,ECサーバの増強を題材として,LB導入に伴う構成設計及びSAML2.0を利用するための方式検討において,受験者が習得した技術が活用できる水準かどうかを問う。
設問と解答例
設問1
解答欄6つ
図2中の a ,b に入れる適切なリソースレコード名を, c 〜 f に入れる適切な IP アドレスを,それぞれ答えよ。
解説
本文の根拠
図2 項番2〜6
項番2:IN a ns.example.jp.。項番3:IN b 10 mail.example.jp.。項番4:ns IN A c 。項番5:ecsv IN A(省略)。項番6:mail IN A d 。
図2 項番10〜12
項番10:ns IN A e 。項番11:ecsv IN A(省略)。項番12:mail IN A f 。
表1
100.α.β.1 → 192.168.1.1,TCP/53,UDP/53。100.α.β.2 → 192.168.1.2,TCP/443。100.α.β.3 → 192.168.1.3,TCP/25。
〔EC サイトに関連するシステムの構成,運用及びセッション管理方法〕
DMZ の DNS サーバは,EC サイトのインターネット向けドメイン example.jp と,社内向けドメイン y-sha.example.lan の二つのドメインのゾーン情報を管理する。
a・b:ゾーンの権威 DNS サーバを示すのが NS レコード,メールの配送先を示すのが MX レコードである(RFC 1035)。項番3の「10」は MX レコードにだけある優先度(プリファレンス)の値で,これが MX だと決める手掛かりになる。項番8・9も同じ形なので,a と b は二つのゾーンで同じ字句が入る。
c・d:項番1〜6はインターネット向けの example.jp のゾーンなので,インターネットから届くグローバル IP アドレスを書く。表1の静的 NAT で,DNS(TCP/UDP 53)は 100.α.β.1,SMTP(TCP 25)は 100.α.β.3 が受けている。したがって ns は 100.α.β.1,mail は 100.α.β.3 になる。e・f:項番7〜12は社内向けの y-sha.example.lan で,運用 PC は広域イーサ網経由で DMZ に直接届くので,NAT 変換後のプライベートアドレス 192.168.1.1(ns)と 192.168.1.3(mail)を書く。
間違えやすい点。同じホストでもゾーンによって書くアドレスが違う。表1の「変換前」がインターネット向け,「変換後」が社内向けと対応させれば取り違えない。ecsv が 100.α.β.2/192.168.1.2 であることも同じ表から読める。
設問2(1)
25字以内
URL を https://ecsv.y-sha.example.lan/ に設定して EC サーバにアクセスすると,TLS のハンドシェイク中にエラーメッセージが Web ブラウザに表示される。その理由を,サーバ証明書のコモン名に着目して,25 字以内で答えよ。
解答例
解説
本文の根拠
〔EC サイトに関連するシステムの構成,運用及びセッション管理方法〕
会員企業の事務用品購入の担当者(以下,購買担当者という)は,Web ブラウザで https://ecsv.example.jp/ を指定して EC サーバにアクセスする。
〔EC サイトに関連するシステムの構成,運用及びセッション管理方法〕
EC サーバに登録されているサーバ証明書は一つであり,マルチドメインに対応していない。
TLS のハンドシェイクでは,サーバがサーバ証明書を送り,Web ブラウザはその証明書に書かれたドメイン名と,自分がアクセスしようとした URL のホスト名が一致するかを確かめる(RFC 2818,RFC 6125)。一致しなければ,なりすましの疑いがあるとして警告を出す。
EC サーバの証明書は一つだけで,マルチドメインに対応していない。購買担当者がインターネットから使う https://ecsv.example.jp/ 向けに作られているので,コモン名は ecsv.example.jp である。運用 PC から https://ecsv.y-sha.example.lan/ でアクセスすると,URL のホスト名と証明書のコモン名が食い違い,エラーになる。
字数の詰め方。解答例は20字。「コモン名」と「URL のドメイン」が「異なる」の3語で足りる。なお,現在のブラウザは主に証明書の SAN(サブジェクト代替名)を照合するが,設問はコモン名に着目せよと指定しているので,コモン名で書く。
設問2(2)
本文中の下線①でアクセスしたとき,運用 PC が送信したパケットが EC サーバに届くまでに経由する機器を,図1中の機器名で全て 答えよ。
解答例
解説
本文の根拠
〔EC サイトの応答速度の低下〕
(4) ssh コマンドで①ecsv.y-sha.example.lan にアクセスして CPU 使用率を調べたところ,設計値を大きく超えていた。
〔EC サイトに関連するシステムの構成,運用及びセッション管理方法〕
L3SW には,DMZ への経路とデフォルトルートが設定されている。
図1
z-DC では,インターネットに FWz が接続し,FWz は DMZ(192.168.1.0/24)の L2SW と広域イーサ網に接続している。
運用 PC は DMZ の DNS サーバで名前解決するので,ecsv.y-sha.example.lan は社内向けゾーンのプライベートアドレス 192.168.1.2 に解決される。宛先がプライベートアドレスなのでインターネットは通らず,本文の説明どおり広域イーサ網を経由する。
図1で経路をたどると,運用 PC は L3SW につながり,L3SW は DMZ への経路に従って広域イーサ網に送る。広域イーサ網の先は z-DC の FWz で,FWz から DMZ の L2SW を経て EC サーバに届く。経由する機器は L3SW,FWz,L2SW の3台である。
間違えやすい点。FWy は運用 PC からインターネットへの出口で,この通信では通らない。広域イーサ網はサービス網であり,図1中の機器名ではないので答えに含めない。「全て」とあるので一つでも欠けると誤りになる。
設問3(1)
解答欄2つ
本文中の g ,h に入れる適切な字句を答えよ。
解説
本文の根拠
〔EC サーバの増強構成の設計〕
EC サーバの増強策としてスケール g 方式とスケール h 方式を比較検討し,EC サイトを停止せずに EC サーバの増強を行える,スケール h 方式を採用することを考えた。
スケールアップは,サーバ1台の CPU やメモリを増やして性能を上げる方式である。部品の交換やより大きなサーバへの移行の間,そのサーバを止める必要がある。スケールアウトは,同じ役割のサーバの台数を増やし,負荷分散装置などで処理を振り分けて全体の性能を上げる方式である。既存のサーバを動かしたまま台数を足せる。
本文は「EC サイトを停止せずに」増強できる方を採用しており,その後に EC サーバを増設して LB で振り分ける構成を設計している。停止しないで済み,台数を増やすのが h のスケールアウト,比較の相手が g のスケールアップになる。
間違えやすい点。g と h を逆に書くと両方誤りになる。後の文で h が2回出てくるので,採用した方を h に置く。
設問3(2)
35字以内
本文中の下線②について,2 台ではなく 3 台構成にする目的を,35 字以内で答えよ。ここで,将来のアクセス増加については考慮しないものとする。
解答例
1台故障時にも,ECサイトの応答速度の低下を発生させないため
解説
本文の根拠
〔EC サーバの増強構成の設計〕
②EC サーバを 2 台にすれば EC サイトは十分な処理能力をもつことになるが,2 台増設して 3 台にし
〔EC サーバの増強構成と LB の設定〕
はい。まず,メンテナンスを行う EC サーバを負荷分散の対象から外し,その後に,運用 PC から当該 EC サーバにアクセスして,メンテナンス作業を行います。
〔LB の制御方式の検討〕
振分け先のサーバの稼働状態を定期的に監視し,障害が発生したサーバを負荷分散の対象から外す機能である。
2台で必要な処理能力をちょうど満たす構成では,1台が故障すると残り1台に全部の処理が掛かり,今と同じ処理能力不足に戻る。1台余分に持っておけば(いわゆる N+1 構成),1台が止まっても残りの2台で必要な能力を保てる。
本文では,ヘルスチェックで障害が起きたサーバを負荷分散の対象から外し,メンテナンスのときもサーバを対象から外すとしている。どちらの場合も1台が抜けた状態で運転が続くので,抜けても応答速度が落ちない台数が要る。設問は将来のアクセス増加を考えないとしているので,余裕の目的は故障時に絞られる。
字数の詰め方。解答例は30字。「1台故障時にも」と「応答速度の低下を発生させない」を残す。「可用性を高めるため」だけでは,2台でも1台故障時にサービス自体は続くので,3台にする理由として足りない。
設問3(3)
解答欄3つ
表2中の i 〜 k に入れる適切な IP アドレスを答えよ。
解説
本文の根拠
表2
(ⅰ):行わない場合 送信元 200.a.b.c,宛先 i 。
表2
(ⅲ):行わない場合 送信元 200.a.b.c,宛先 192.168.1.5。行う場合 送信元 k ,宛先 192.168.1.5。
図4
lbs IN A 192.168.1.4 ;LB の物理 IP アドレス。ecsv1 IN A 192.168.1.5 ;既設 EC サーバの IP アドレス。
表1
100.α.β.2 → 192.168.1.2,TCP/443。
i:購買担当者の PC は ecsv.example.jp を名前解決し,図2の項番5(インターネット向けゾーン)から得たアドレスに送る。表1で HTTPS(TCP/443)を受けているのは 100.α.β.2 なので,(ⅰ)の宛先は 100.α.β.2 である。j:FWz の静的 NAT で宛先が 192.168.1.2 に変換され,(ⅱ)で LB に届く。増強後は 192.168.1.2 が LB の仮想 IP アドレスになる(設問4(1))。LB が宛先を既設 EC サーバの 192.168.1.5 に変えて(ⅲ)で送る。
戻りは逆に,LB が送信元を 192.168.1.5 から 192.168.1.2 に戻して(ⅴ)で送り,FWz が 100.α.β.2 に戻して(ⅵ)で PC に届く。表2の(ⅴ)が j,(ⅵ)が i になっているのはこのためで,行きと戻りで同じ値になることが検算になる。k:ソース NAT を行う場合,LB は送信元を自分のアドレスに変える。図4で LB の物理 IP アドレスは 192.168.1.4 である。戻りの(ⅳ)では既設 EC サーバがこのアドレスに返す。
間違えやすい点。k に仮想 IP アドレスの 192.168.1.2 を書かない。仮想 IP アドレスは購買担当者から見た負荷分散用の宛先で,ソース NAT に使うのは LB 自身の物理アドレスである。
採点講評(IPA)
設問3では,(3)jの正答率が低かった。図5の構成では,PCはLBに設定された仮想IPアドレス宛てにパケットを送信するが,ファイアウォールに設定されたNATは変更されないことから,表1を基に正答を導き出してほしい。
設問4(1)
解答欄2つ
本文中の下線③について,どの機器を示すことになるかを,図3中の機器名で答えよ。また,下線③の特別な IP アドレスは何と呼ばれるかを,本文中の字句で答えよ。
解説
本文の根拠
〔EC サーバの増強構成と LB の設定〕
③図2中の項番5と項番11のリソースレコードは,図3の構成では図1とは違う機器の特別な IP アドレスを示すことになります。
〔EC サーバの増強構成の設計〕
導入する LB には,負荷分散用の IP アドレスである仮想 IP アドレスで受信したパケットを EC サーバに振り分けるとき
〔EC サーバの増強構成と LB の設定〕
LB を利用して EC サーバを増強する構成を考えました。購買担当者が EC サーバにアクセスするときの URL の変更は不要です。
項番5と項番11は ecsv の A レコードで,図1の構成では EC サーバのアドレス(インターネット向けは 100.α.β.2,社内向けは 192.168.1.2)を示していた。増強後も URL とゾーン情報を変えないので,ecsv.example.jp も ecsv.y-sha.example.lan も同じアドレスを指したままである。ところが既設 EC サーバは図4のとおり ecsv1(192.168.1.5)に移るので,192.168.1.2 は LB が引き継ぐ。
LB はこの 192.168.1.2 で受けたパケットを3台の EC サーバに振り分ける。本文はこれを「負荷分散用の IP アドレスである仮想 IP アドレス」と呼んでいる。図4の lbs(192.168.1.4)は LB の物理 IP アドレスで,これとは別に持つアドレスである。
間違えやすい点。呼称は「本文中の字句で」とあるので,VIP やバーチャル IP ではなく「仮想 IP アドレス」と書く。機器は図3中の機器名で「LB」とする。
設問4(2)
本文中の下線④について,ホスト名のほかに変更する情報を答えよ。
解答例
解説
本文の根拠
〔EC サーバの増強構成と LB の設定〕
また,④図4のリソースレコードの追加に対応して,既設 EC サーバに設定されている二つの情報を変更します。
図4
ecsv1 IN A 192.168.1.5 ;既設 EC サーバの IP アドレス。
図4で既設 EC サーバには,ホスト名 ecsv1 と IP アドレス 192.168.1.5 が割り当てられる。これまで既設 EC サーバはホスト名 ecsv,IP アドレス 192.168.1.2 で動いていた。DNS に新しいレコードを足すだけではサーバ自身の設定は変わらないので,サーバ側でホスト名を ecsv1 に,自身の IP アドレスを 192.168.1.5 に変える。
192.168.1.2 は LB の仮想 IP アドレスとして使う(設問4(1))。既設 EC サーバがそのアドレスを持ったままだと,同じセグメントで IP アドレスが重複してしまう。この点からも IP アドレスの変更が欠かせない。
間違えやすい点。デフォルトゲートウェイは下線⑤で別に変更するとしているので,下線④の二つの情報には入らない。解答例の「(自身の)」は省いてもよい。
設問4(3)
本文中の下線⑤について,どの機器からどの機器の IP アドレスに変更するのかを,図3中の機器名で答えよ。
解答例
解説
本文の根拠
〔EC サーバの増強構成と LB の設定〕
現在の EC サーバの運用を変更しないために,ソース NAT は行わない予定です。この場合,パケットの転送を図5の経路にするために,⑤既設 EC サーバでは,デフォルトゲートウェイの IP アドレスを変更します。
図5
戻りのパケットは,既設 EC サーバから LB へが (ⅳ),LB から FWz へが (ⅴ)
ソース NAT を行わないと,既設 EC サーバに届くパケットの送信元は PC のグローバルアドレス 200.a.b.c のままである。既設 EC サーバの応答はインターネット宛てになるので,デフォルトゲートウェイに送られる。図1の構成では EC サーバのデフォルトゲートウェイは FWz だった。そのままだと応答は LB を通らずに FWz に直接届き,送信元が 192.168.1.5 のまま出ていく。LB で宛先を変換した通信の戻りが LB を通らないので,PC は応答を受け取れない。
図5では,戻りのパケット(ⅳ)が既設 EC サーバから LB に向かっている。そのためには既設 EC サーバのデフォルトゲートウェイを LB に向け,LB で送信元を仮想 IP アドレスに戻してから FWz に渡す必要がある。
間違えやすい点。この設定をすると,運用 PC(広域イーサ網側)への応答も LB に向かう。LB はルータとして動作しないので,W 課長の指摘どおり運用 PC から EC サーバと通信できなくなる。これが後のソース NAT への方針変更につながる。
設問4(4)
35字以内
本文中の下線⑥について,X-Forwarded-For フィールドを追加する目的を,35 字以内で答えよ。
解答例
ECサーバに,アクセス元PCのIPアドレスを通知するため
解説
本文の根拠
〔EC サーバの増強構成と LB の設定〕
対策方法として,EC サーバに設定するデフォルトゲートウェイを図1の構成時のままとし,LB ではソース NAT を行うとともに,⑥EC サーバ宛てに送信する HTTP ヘッダーに X-Forwarded-For フィールドを追加するようにします。
〔EC サイトに関連するシステムの構成,運用及びセッション管理方法〕
EC サーバは,アクセス元の IP アドレスなどをログとして管理している。
LB でソース NAT を行うと,EC サーバに届くパケットの送信元 IP アドレスは,すべて LB の 192.168.1.4 になる。EC サーバからはアクセス元の PC が区別できなくなる。X-Forwarded-For は,プロキシや LB が中継するときに元のクライアントの IP アドレスを書き込む HTTP ヘッダーのフィールドである(広く使われている慣習で,同じ目的を標準化したものに RFC 7239 の Forwarded ヘッダーがある)。
EC サーバはアクセス元の IP アドレスをログとして管理している。ソース NAT の後もこの運用を続けるために,LB が元の送信元アドレス 200.a.b.c を X-Forwarded-For に入れて EC サーバに渡す。EC サーバはこのフィールドをログに記録すればよい。
字数の詰め方。解答例は28字。「EC サーバに」「アクセス元 PC の IP アドレスを」「通知する」を残す。字数が余れば「ログに記録するため」と目的を足してもよい。
設問4(5)
50字以内
本文中の下線⑦について,対応するための作業内容を,50 字以内で答えよ。
解答例
既設ECサーバにインストールされているサーバ証明書と秘密鍵のペアを,LBに移す。
解説
本文の根拠
〔EC サーバの増強構成と LB の設定〕
いいえ。増設 EC サーバにはインストールせずに⑦既設 EC サーバ内のサーバ証明書の流用で対応できます。
〔EC サーバの増強構成と LB の設定〕
⑥EC サーバ宛てに送信する HTTP ヘッダーに X-Forwarded-For フィールドを追加する
LB が HTTP ヘッダーに X-Forwarded-For を足すには,HTTPS の暗号を LB で解いて HTTP の中身を読み書きする必要がある。つまり TLS の終端は EC サーバではなく LB になる。購買担当者の Web ブラウザと TLS のハンドシェイクをするのは LB なので,サーバ証明書は LB に置けばよく,3台の EC サーバにはそれぞれ要らない。
購買担当者がアクセスする URL は https://ecsv.example.jp/ のまま変わらないので,既設 EC サーバが使っているサーバ証明書(コモン名 ecsv.example.jp)がそのまま使える。ただし TLS で自分を証明するには証明書と対になる秘密鍵が要るので,証明書と秘密鍵のペアを LB に移す。
字数の詰め方。解答例は40字。「サーバ証明書と秘密鍵のペア」と「LB に移す」の2点が必須である。証明書だけでは TLS の鍵交換や署名ができない。
採点講評(IPA)
設問4では,(5)の正答率が低かった。サーバ証明書は,サーバの公開鍵の正当性をCAが保証するものであり,秘密鍵とサーバ証明書とが一緒に管理されることで,TLSでは,サーバの認証及びデータの暗号化に用いられる共通鍵の安全な配送が可能になることを理解してほしい。
設問5(1)
50字以内
本文中の下線⑧について,セッション維持ができなくなる理由を,50 字以内で答えよ。
解答例
TCPコネクションが再設定されるたびに,ポート番号が変わる可能性があるから
解説
本文の根拠
〔LB の制御方式の検討〕
⑧IP アドレスとポート番号との組合せでアクセス元を識別する場合は,TCP コネクションが切断されると再接続時にセッション維持ができなくなる問題が発生する。
〔EC サイトに関連するシステムの構成,運用及びセッション管理方法〕
Web ブラウザによる EC サーバへのアクセスの開始から終了までの一連の通信を,セッション ID を基に,同一のセッションとして管理する。
クライアントが TCP コネクションを張るとき,送信元ポート番号には OS がその都度空いている番号(エフェメラルポート)を選ぶ。コネクションが切れて張り直すと,同じ PC からでも別のポート番号になることが多い。途中に会員企業側の NAPT があれば,変換後のポート番号も張り直しのたびに変わる。
EC サーバのセッションは,アクセスの開始から終了までの一連の通信を Cookie のセッション ID で束ねたもので,その間に TCP コネクションは何度も張り直されうる。LB が IP アドレスとポート番号の組でアクセス元を見分けると,張り直した後の通信を別のアクセス元とみなし,別の EC サーバに振り分けることがある。振り分けられたサーバはそのセッションを知らないので,ログイン状態やカートの中身が引き継がれない。
字数の詰め方。解答例は37字。「TCP コネクションが再設定されるたびに」と「ポート番号が変わる(可能性がある)」を残す。IP アドレスは変わらないので,ポート番号の側に絞って書く。
設問5(2)
60字以内
本文中の下線⑨について,LB がセッション管理テーブルに新たなレコードを登録するのは,どのような場合か。60 字以内で答えよ。
解答例
サーバからの応答に含まれるCookie中のセッションIDが,セッション管理テーブルに存在しない場合
解説
本文の根拠
〔LB の制御方式の検討〕
⑨Cookie 中のセッション ID と振分け先のサーバから構成されるセッション管理テーブルを LB が作成し,このテーブルを使用してセッションを維持する方式を利用する。
〔EC サイトに関連するシステムの構成,運用及びセッション管理方法〕
Web ブラウザから最初にアクセスを受けたときに,ランダムな値のセッション ID を生成する。
〔EC サイトに関連するシステムの構成,運用及びセッション管理方法〕
Web ブラウザへの応答時に,Cookie にセッション ID を書き込んで送信する。
セッション ID を作るのは LB ではなく EC サーバである。Web ブラウザが最初にアクセスしたとき,リクエストにはまだセッション ID が無いので,LB は負荷分散機能で振分け先を決める。振り分けられた EC サーバがセッション ID を生成し,応答の Cookie に書き込んで返す。LB はこの応答を中継するときに,初めて見るセッション ID と,応答を返してきたサーバの組を記録する。
以後,同じ Web ブラウザからのリクエストには Cookie でそのセッション ID が付いてくるので,LB はテーブルを引いて同じサーバに送る。テーブルに新しいレコードが加わるのは,サーバの応答に含まれるセッション ID がまだテーブルに無いときだけである。
字数の詰め方。解答例は49字。「サーバからの応答に含まれる」「Cookie 中のセッション ID が」「テーブルに存在しない」の3つを残す。「リクエストに Cookie が無い場合」と書くと,その時点ではまだセッション ID も振分け先の組も決まっていないので,登録の条件としてずれる。
採点講評(IPA)
設問5では,(2)の正答率が低かった。本文中の記述から,サーバがセッションIDを生成する条件,cookieにセッションIDを書き込む条件,及び導入予定のLBがセッション管理テーブルを作成する条件が分かるので,これら三つの条件を基に,セッション管理テーブルに新たなレコードが登録される場合を導き出してほしい。
設問5(3)
25字以内
本文中の下線⑩について,レイヤー3 及びレイヤー4 方式では適切な監視が行われない。その理由を 25 字以内で答えよ。
解答例
解説
本文の根拠
〔LB の制御方式の検討〕
⑩ヘルスチェックは,レイヤー3,4 及び 7 の各レイヤーで稼働状態を監視する方式があり,ここではレイヤー7 方式を利用する。
〔LB の制御方式の検討〕
振分け先のサーバの稼働状態を定期的に監視し,障害が発生したサーバを負荷分散の対象から外す機能である。
レイヤー3 方式は ICMP Echo(ping)でサーバの IP 層が応答するかを,レイヤー4 方式は TCP の 443 番などに接続してポートが待ち受けているかを見る。どちらも,EC サイトのアプリケーションが正しく処理を返せるかまでは確かめない。アプリケーションが異常終了していたり,内部エラーを返していたりしても,OS が動いていれば ping は通り,プロセスが残っていれば TCP 接続もできることがある。
レイヤー7 方式は,実際に HTTP のリクエストを送り,ステータスコードや応答の中身が期待どおりかを確かめる。サービスとして使える状態かを見るので,使えないサーバを負荷分散の対象から確実に外せる。問1の設問1(2)で ping 監視では不十分だった理由と同じ考え方である。
字数の詰め方。解答例は22字。「サービスが稼働しているかどうか」を「検査しない」と言う。「アプリケーションの異常を検知できないから」のように書いても趣旨は同じである。
設問6(1)
30字以内
本文中の下線⑪について,ログイン要求を受信した EC サーバがリダイレクト応答を行うために必要とする情報を,購買担当者の認証・認可の情報を提供する IdP が会員企業によって異なることに着目して,30 字以内で答えよ。
解答例
アクセス元の購買担当者が所属している会員企業の情報
解説
本文の根拠
図7中の(ⅰ)〜(ⅸ)の処理の概要
(ⅱ) SP である EC サーバは,⑪SAML 認証要求(SAML Request)を作成し IdP である認証連携サーバにリダイレクトを要求する応答を行う。
〔SAML2.0 の調査と EC サーバへの対応の検討〕
z-DC で稼働する Y 社の EC サーバが SAML の SP に対応すれば,購買担当者は,自社内のディレクトリサーバ(以下,DS という)などで管理するアカウント情報を使って,EC サーバに安全に SSO でアクセスできる。
SP である EC サーバは,ログイン要求を受けると,購買担当者を認証してもらう IdP へリダイレクトさせる応答を返す。そのためには,リダイレクト先の IdP の URL を決めなければならない。
IdP は会員企業ごとに別々で,e 社なら e 社内の認証連携サーバである。購買担当者はそれぞれ自社の DS で管理するアカウント情報で認証を受けるので,EC サーバは要求してきた購買担当者がどの会員企業に所属しているかが分からないと,リダイレクト先を選べない。ログイン画面で会員企業を選ばせる,会員企業ごとに URL を分けるなどの方法で,この情報を得る。
字数の詰め方。解答例は25字。「アクセス元の購買担当者が所属している」「会員企業の情報」を残す。「IdP の URL」と書くと,その URL をどうやって決めるのかという問いの答えにならない。
設問6(2)
15字以内
本文中の下線⑫について,図7の手順の処理を行うために,EC サーバに登録すべき情報を,15 字以内で答えよ。
解答例
解説
本文の根拠
図7中の(ⅰ)〜(ⅸ)の処理の概要
ここで,EC サーバには,⑫IdP が作成するデジタル署名の検証に必要な情報などが設定され,IdP との間で信頼関係が構築されている。
図7中の(ⅰ)〜(ⅸ)の処理の概要
IdP は,ST の内容を基に購買担当者を認証し,デジタル署名付きの SAML アサーションを含む SAML 応答(SAML Response)を作成して
デジタル署名は,署名者の秘密鍵で作り,対になる公開鍵で検証する。IdP は SAML アサーションに自分の秘密鍵で署名するので,SP である EC サーバは IdP の公開鍵を持っていなければ署名を検証できない。公開鍵は,それが確かにその IdP のものであることを示す公開鍵証明書の形で登録するのが普通である(SAML では IdP のメタデータに証明書を含めてやり取りする)。
本文は,EC サーバに IdP のデジタル署名の検証に必要な情報を設定して「IdP との間で信頼関係が構築されている」とする。どの IdP の署名を信用するかは,事前に登録した証明書で決まる。会員企業ごとに IdP が違うので,会員企業ごとに登録する。
字数の詰め方。解答例は10字。「IdP の公開鍵証明書」で足りる。「公開鍵」だけでも検証はできるが,誰の鍵かを明示するため「IdP の」を落とさない。EC サーバ自身のサーバ証明書や秘密鍵ではない。
設問6(3)
20字以内
本文中の下線⑬について,取り出した ST を PC は改ざんすることができない。その理由を 20 字以内で答えよ。
解答例
解説
本文の根拠
図7中の(ⅰ)〜(ⅸ)の処理の概要
(ⅵ) KDC は,TGT を基に,購買担当者の身元情報やセッション鍵が含まれた ST を発行し,IdP の鍵で ST を暗号化する。さらに,KDC は,暗号化した ST にセッション鍵などを付加し,全体を PC の鍵で暗号化した情報を PC に払い出す。
図6で示した会員企業 e 社のシステムの概要
PC 及び社内サーバは,それぞれ自身の共通鍵を保有している。
ケルベロス認証(RFC 4120)では,サービスチケット(ST)はそのサービスの秘密鍵で暗号化されている。この鍵を知っているのはサービス自身と KDC だけである。PC は KDC から受け取った情報の外側を自分の鍵で復号し,中からセッション鍵と ST を取り出すが,ST 自体は IdP の鍵で暗号化されたままなので中身を読めない。
PC が ST の中の身元情報を書き換えようとしても,IdP の鍵が無いので正しく暗号化し直せない。書き換えた ST は IdP で復号や完全性の確認に失敗する。本文でも,PC と社内サーバはそれぞれ自身の共通鍵を保有し,DS(KDC)がそれらを管理するとしており,IdP の鍵は PC の手元に無い。
字数の詰め方。解答例は15字。「IdP の鍵を所有していない」で足りる。「暗号化されているから」だけでは,PC が鍵を持っていれば復号できてしまうので,誰の鍵かまで書く。
設問6(4)
解答欄2つ
本文中の下線⑭について,受信した SAML アサーションに対して検証できる内容を二つ 挙げ,それぞれ 25 字以内で答えよ。
解説
本文の根拠
図7中の(ⅰ)〜(ⅸ)の処理の概要
SP は,SAML Response に含まれる⑭デジタル署名を検証し,検証結果に問題がない場合,SAML アサーションを基に,購買担当者が正当な利用者であることの確認
図7中の(ⅰ)〜(ⅸ)の処理の概要
ここで,EC サーバには,⑫IdP が作成するデジタル署名の検証に必要な情報などが設定され,IdP との間で信頼関係が構築されている。
デジタル署名の検証で分かることは二つある。一つは,事前に登録した IdP の公開鍵で検証できたのだから,その IdP の秘密鍵で作られたこと,つまり信頼関係のある IdP が生成したアサーションであること(真正性)。もう一つは,署名した後で内容が一文字でも変わればハッシュ値が合わなくなるので,SAML アサーションが改ざんされていないこと(完全性)である。
SAML アサーションは利用者の PC を経由して SP に届く(図7の(ⅷ)(ⅸ))。PC や途中の経路で書き換えられたり,偽の IdP が作ったりしたものを受け入れると,他人になりすまして EC サーバを使われてしまう。だから SP は署名を検証してから,アサーションを基に利用者の確認と権限の付与を行う。
字数の詰め方。解答例はそれぞれ22字。①は「信頼関係のある IdP が生成した」,②は「改ざんされていない」を核にする。①②は順不同。「利用者が正当であること」は検証の後にアサーションの中身で行う処理なので,署名の検証で分かることではない。
出典:令和5年度 春期 ネットワークスペシャリスト試験 午後Ⅱ 問2(表記を一部改変)