問1 業務システムの再構築
業務システムの再構築に関する次の記述を読んで,設問1〜6に答えよ。
T 社は,コンピュータ関連製品の卸売会社である。従業員数は400名で,東京に本社が,大阪,福岡に営業所がある。T 社の営業員200名及び技術員100名は,外出先で活動することが多い。営業員は,担当する販売代理店への営業活動を行い,技術員は,自社の取扱商品の技術サポートを行っている。営業員と技術員は,外出先にデータ通信カードを装着した PC を携帯し,インターネット経由で SSL-VPN 装置に接続して,T 社内のシステムを利用している。
T 社では,販売,購買,会計などの業務システムを運用している。現在のネットワークシステム構成を,図1に示す。
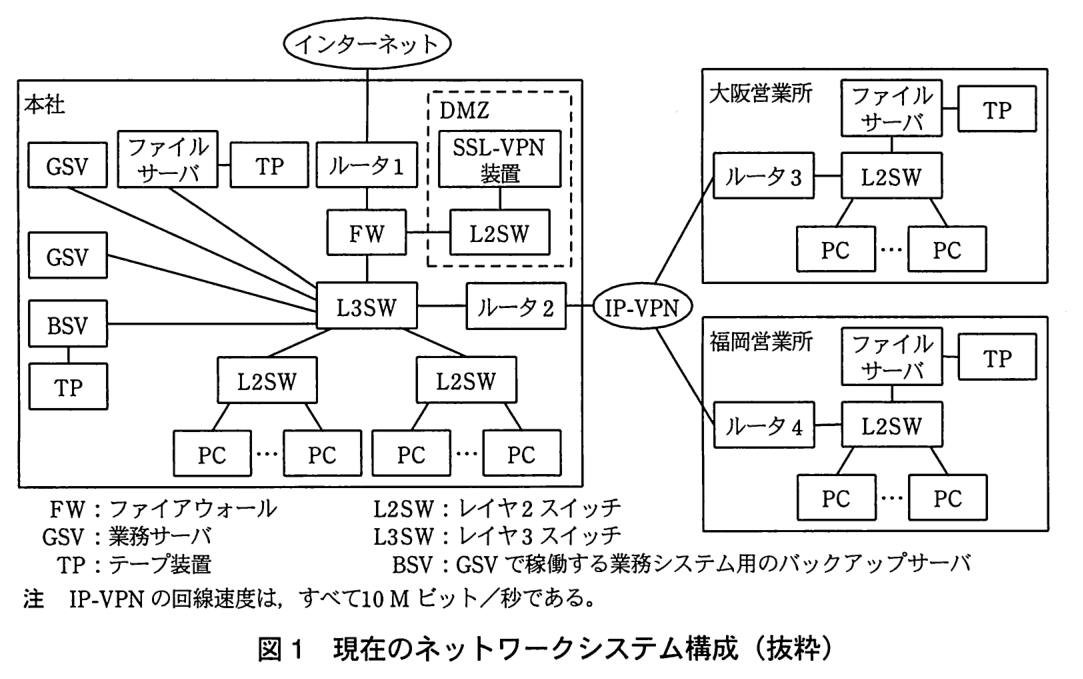
T 社では,業務システムの機能強化を目的に,システムの再構築を行うことにした。機能強化策の一つとして,取扱商品を大幅に増やすために,商品マスタを50万レコードに拡大する。併せて,以前から改善が求められていた,ファイルサーバのデータバックアップの見直しも行う。これらを推進するためのプロジェクトマネージャとして,情報システム部の W 部長が任命された。W 部長は,販売,購買,会計などの業務の責任者及びシステム基盤設計,構築,運用の責任者を選出して,新業務システム開発プロジェクトを発足させた。
新業務システムの概要設計完了後,W 部長は,部下の Y 課長に対してシステム基盤と運用管理方式の設計を指示した。Y 課長は,環境の変化に柔軟に対応できるようにすることと,運用負荷を抑えるために,新業務システムを稼働させるシステム基盤に,サーバ仮想化技術を活用することにした。
〔システム基盤の設計〕
サーバの仮想化を実現させる仕組み(以下,仮想化機構という)を動作させるサーバのことを,物理サーバという。仮想化機構によって,物理サーバ上に作成されるサーバ機能を,仮想サーバという。仮想サーバは,物理サーバ上に複数作成できる。仮想サーバが使用するディスクは,物理サーバのローカルディスクと SAN に接続されたディスク装置(以下,SAN ストレージという)に作成することができる。仮想サーバが使用するディスクを SAN ストレージに作成すると,複数の仮想サーバで共用できる。
SAN には,FC-SAN と a がある。a を構成する代表的な技術が iSCSI(internet SCSI)である。最近は,iSCSI プロトコルが PC とサーバ OS に実装されているので,iSCSI を容易に利用できるようになった。iSCSI は,信頼性のあるデータ通信を行うために b プロトコルを使用する。iSCSI では,サーバで稼働し,c コマンドを発行して処理を要求するイニシエータと,ストレージ装置で稼働して,その処理を実行する d 間で,ブロックデータの入出力を実現させている。今回は,稼働実績を重視して,FC-SAN を利用することにした。
新業務システムは,アプリケーションサーバ(以下,AP サーバという),データベースサーバ(以下,DB サーバという)及び SAN ストレージで構成する。AP サーバは,仮想サーバで稼働させる。DB サーバは,AP サーバのアプリケーションプログラムから使用される。T 社では,仮想化機構を活用したシステム構築は初めての経験だったので,DB サーバは,2台でアクティブスタンバイ型のクラスタシステムを構成し,仮想化機構を利用しないことにした。クラスタシステムでは,ハートビートパケットで各サーバの生存を確認するが,①各サーバが稼働しているにもかかわらず,ハートビートパケットを受信できなくなると,サービスを正常に提供できなくなる危険性がある。この障害を避けるために,②各サーバの生存確認を確実に行うための対応策を実施する。
仮想化機構には,物理サーバの障害時や負荷増大時の対策機能が備わっている。しかし,この機能だけでは不十分なので,負荷分散装置(以下,LB という)を利用して,AP サーバの冗長性を高めるとともに,e も向上させることにした。利用する LB には,負荷分散時に送信元 IP アドレスを LB のものに付け替えるソース NAT 機能があるが,AP サーバを使用する PC を特定するために,この機能は利用しない。また,LB による AP サーバの稼働状態管理を確実に行うために,AP サーバからの返送パケットは,LB を経由させることにする。
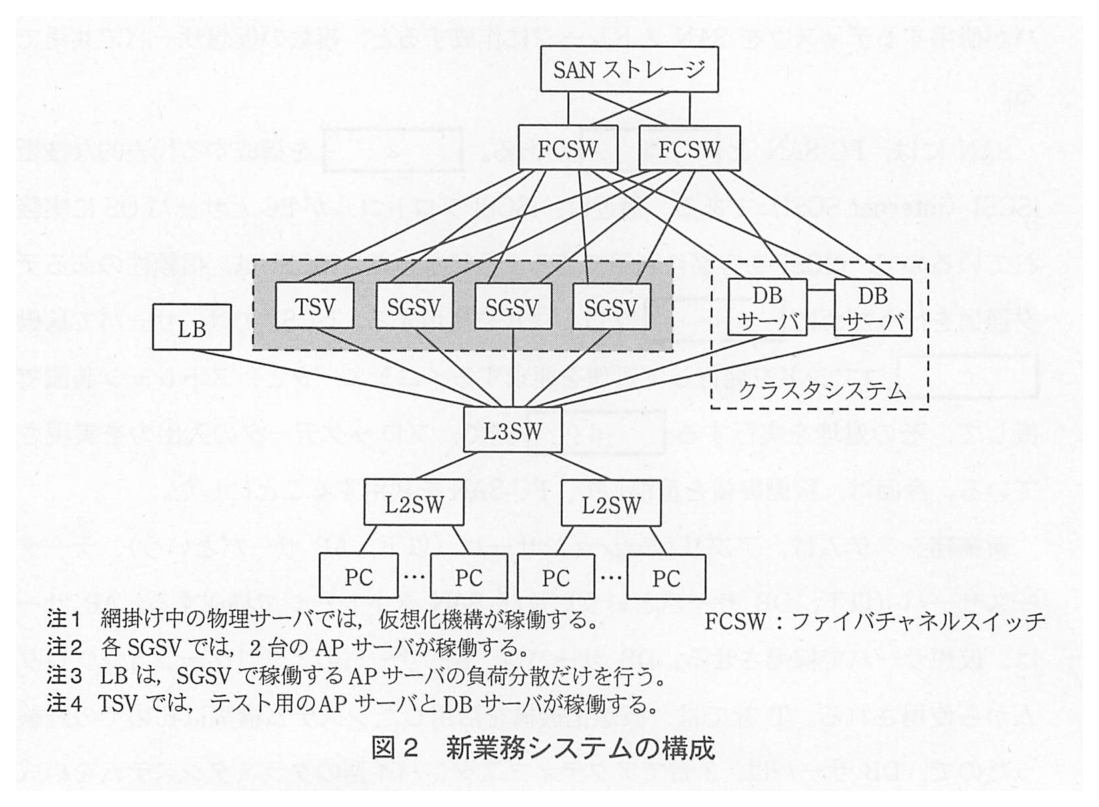
AP サーバを稼働させる物理サーバ(以下,SGSV という)は,障害時の影響を低減させるために,3台構成にする。各 SGSV では,AP サーバを2台ずつ,全体で6台を稼働させて,能力面で余裕をもった構成にする。そのほかに,テスト用の物理サーバ(以下,TSV という)も用意する。新業務システムの構成を,図2に示す。
〔データバックアップの検討〕
現在,営業所ごとにファイルサーバのデータを TP にバックアップしており,テープの管理やエラー時の対応などで,営業所員に負担を強いている。この問題を解決するために,TP へのバックアップを止め,すべての営業所のバックアップデータを本社に集めて,新業務システムのデータバックアップと統合するのが効果的と判断した。
遠隔地にバックアップする場合は,バックアップとリストアを高速化するために,通信帯域の確保が必要になる。そこで,通信帯域をあまり必要としないバックアップ方式を調査したところ,重複除外機能をもつバックアップシステムを利用すれば,バックアップデータ量を飛躍的に削減できることが分かった。
重複除外機能は,サーバデータをブロックに分割し(以下,ブロックデータという),更新されたブロックデータが既にバックアップサーバに存在した場合,そのブロックデータをバックアップしない働きをもつ。重複除外機能をもつバックアップシステムは,バックアップ対象のデータをもつサーバに導入されるエージェントと,バックアップデータを保存するバックアップサーバから構成される。バックアップ対象のサーバでの重複除外処理の概要を,図3に示す。
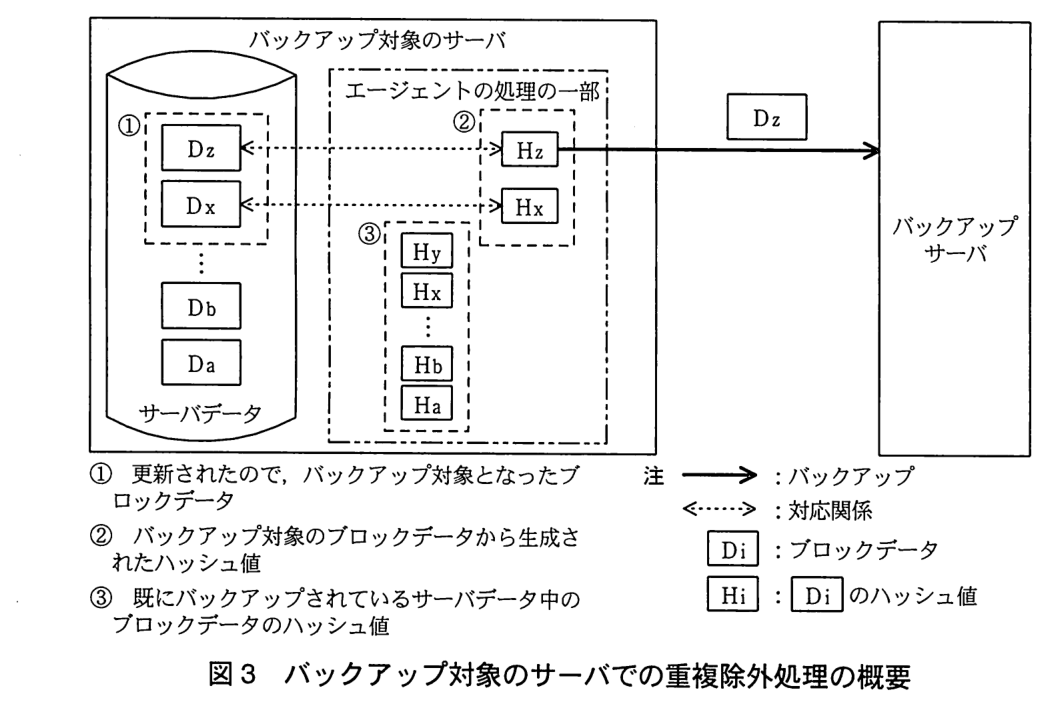
エージェントは,ハッシュ値同士の比較によって,更新されたブロックデータがバックアップ済かどうかをチェックする。図3中に示した②の Hx と Hz のうち,Hx は,③のハッシュ値の中に存在するので,Dx はバックアップされない。Hz は,③のハッシュ値の中に存在しないので,Dz がバックアップサーバに送られて,バックアップされる。このように,更新されたブロックデータから生成された Hx と Hz が,③のサーバデータのハッシュ値に存在するかどうかをチェックすることで,Dx と Dz が,既にバックアップされたブロックデータと重複しているかどうか判断される。
ハッシュ値は,低い確率ではあるが,③ハッシュ値の衝突が発生するので,発生確率を更に低くするために,様々な対応策が考えられている。今回使用する重複除外機能をもつバックアップシステムでは,独自の対応策が実施されている。
〔セキュリティ強化策と回線の検討〕
外出先から T 社内のシステムを利用するときの認証は,ログイン ID と固定パスワードだけで行われているので,セキュリティ上の問題を洗い出し,強化策を検討することにした。
調査した結果,ワンタイムパスワード方式の認証システムを導入し,既設の SSL-VPN 装置の代わりに,PC のセキュリティチェック機能をもち,認証システムと連携も可能な SSL-VPN 装置(以下,新 SSL-VPN 装置という)を導入すれば,少ない変更でセキュリティを強化できることが分かった。認証システムは,認証受付サーバと認証サーバで構成される。認証システムと新 SSL-VPN 装置の構成を,図4に示す。
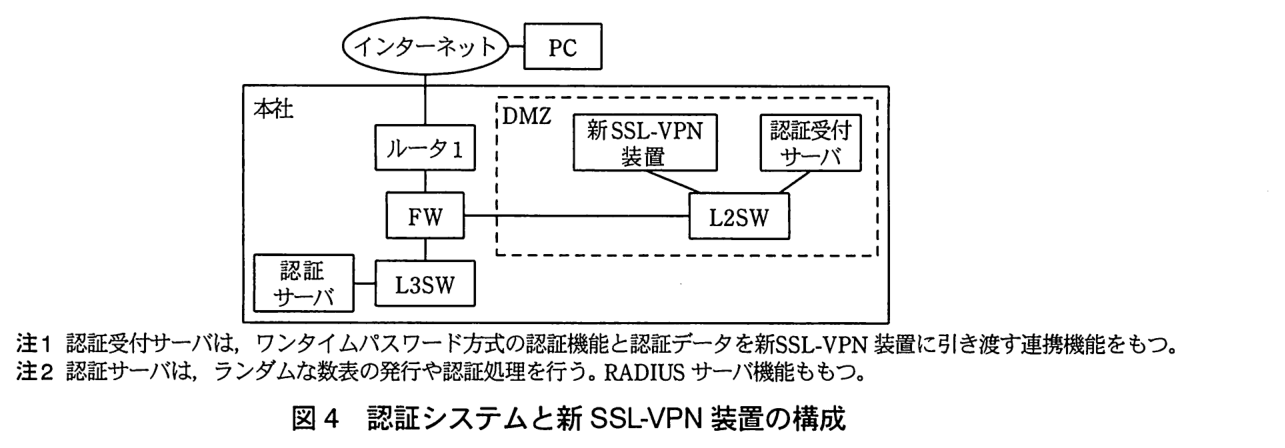
新 SSL-VPN 装置と認証システムとの連携処理手順を,次に示す。
- (ⅰ) 利用者は,PC のブラウザで,新 SSL-VPN 装置に接続する。
- (ⅱ) 新 SSL-VPN 装置は,セキュリティポリシに従って,PC をチェックする。チェック項目には,セキュリティパッチ,稼働プロセス,ウイルス対策ソフトなどが設定できる。チェック結果が正常のときには,認証受付サーバにリダイレクトされる。チェック結果が異常のときには,PC との接続が切断される。
- (ⅲ) 認証受付サーバによって,ログイン ID 入力画面が PC に表示される。利用者が,ログイン ID を入力すると,認証受付サーバは,ログイン ID を基に,ランダムな数表を取得し,次の処理に移る。
- (ⅳ) 認証受付サーバによって,認証画面が表示される。利用者は,PC に表示されたランダムな数値で構成される数表から,事前に決めた数表の位置に表示されている数値をパスワードとして入力する。入力された数値がチェックされ,正しければ,新 SSL-VPN 装置にリダイレクトされ,ログイン ID とパスワードが,新 SSL-VPN 装置に送信される。
- (ⅴ) 新 SSL-VPN 装置は,受信したログイン ID とパスワードを基に,RADIUS プロトコルで,認証サーバに対し認証を要求する。認証後,接続可能なサーバ一覧などを PC に表示する。
- (ⅵ) 利用者が,サーバ一覧の中から接続したいサーバを指定すると,PC と新 SSL-VPN 装置間で VPN が設定され,本社のサーバに接続できる。
次に,本社と各営業所間の回線が,継続して利用できるかどうかを検討した。
ルータ2 のログから送受信データ量を確認したところ,本社と営業所間で発生するトラフィックは,日中最大となり,7M ビット/秒であった。このうち,既存の業務システム利用のトラフィックが40%である。このトラフィックは,新業務システムの利用で,1.3倍になることが見込まれる。これらの条件から,本社と営業所間の最大トラフィックは,[ ア ] M ビット/秒であり,増加量は少ないことが判明した。
各営業所のデータバックアップは,夜間に行う。各営業所のファイルサーバのデータ量は1T バイトである。2回目以降のバックアップデータ量は,ベンダの情報によれば,重複除外機能によって全体の0.5%以下に削減される。これらの条件から,許容時間内にバックアップを完了できる見込みである。
以上の検討によって,本社と各営業所間の回線が,継続して利用可能と判断した。
〔システムの運用管理方式の設計〕
新業務システムでは,統合監視システムを利用して,ネットワーク機器とサーバの稼働状態の監視を行う。
- (1) ネットワーク機器の監視
統合監視システムには,④監視対象機器を発見して,接続構成図を自動作図する機能があるので,管理者は,接続構成図の中から,監視するネットワーク機器を選択することができる。ネットワーク機器の監視は SNMP で行われ,ネットワーク機器の稼働状態を,MIB 情報の定期的な収集によって監視するとともに,Trap の受信によって異常を検知する。
- (2) サーバの監視
サーバの監視は,あらかじめ設定された間隔で,各サーバから監視対象の情報を収集して行う。収集した情報の中に異常が発見されたときには,その内容がメッセージ表示画面に表示される。監視項目には,CPU,メモリなどの使用率,サービスとプロセスの稼働状態及びイベントログの内容がある。仮想サーバを活用したシステムでは,仮想サーバの稼働状態監視だけでは十分でないので,⑤通常のサーバ監視よりも複雑な監視が必要になる。イベントログの監視では,フィルタ機能の活用が必要になり,フィルタの条件設定には,⑥運用後のチューニングが必要になる。
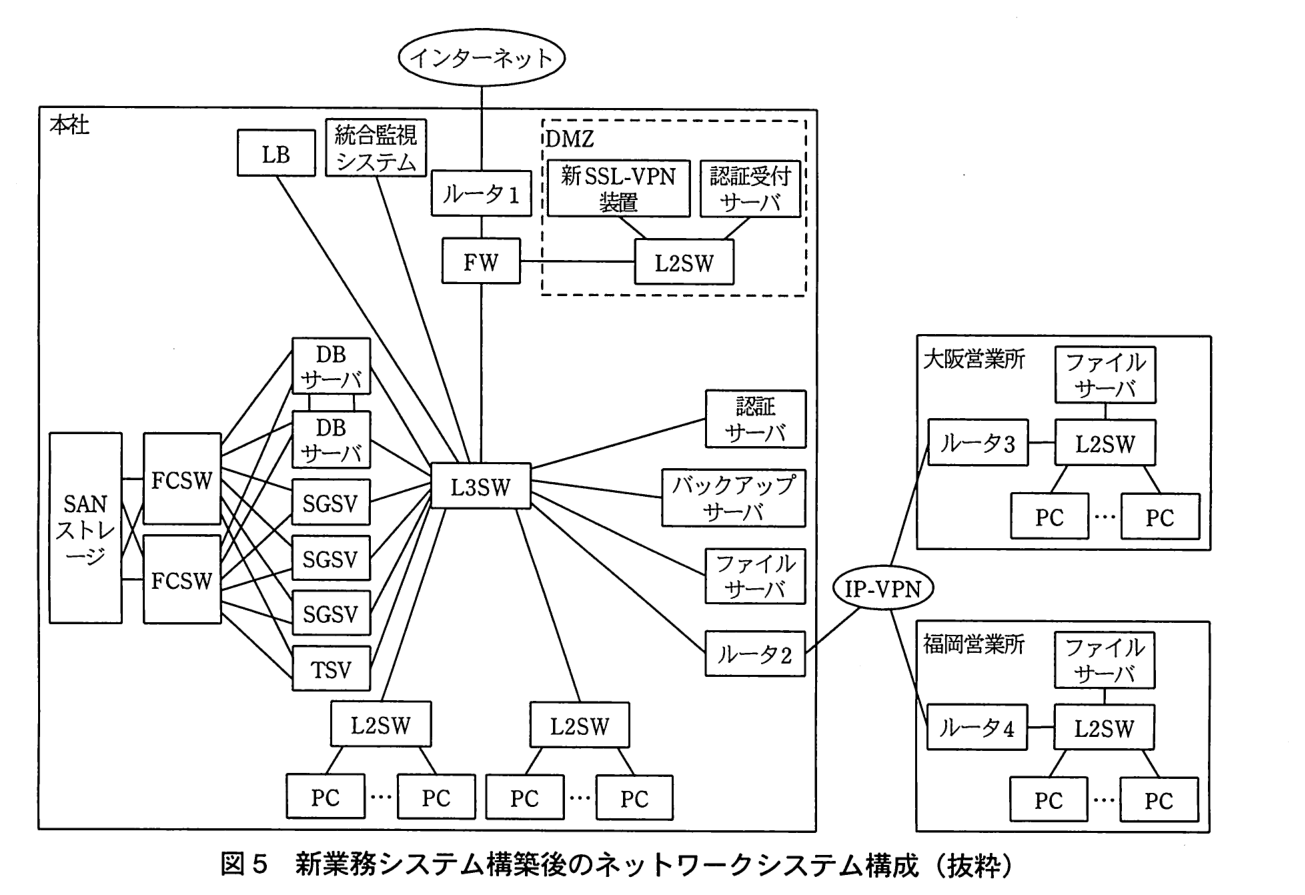
新業務システム構築後のネットワークシステム構成を,図5に示す。
〔システムの切替え〕
W 部長は,プロジェクトメンバと共同で,システム切替えまでの準備作業のスケジュールと,切替時の作業スケジュール(以下,システム切替スケジュールという)を立案した。そして,W 部長は,プロジェクトメンバを各作業の責任者として,システム切替えまでの準備作業を実施させた。
各種テストの終了後,受注から代金回収までの,一連の業務の流れに沿って処理を進める方式で,総合テストを実施し,問題なく完了した。
負荷テストは,Y 課長が担当した。負荷テストでは,新業務システムの処理能力を確認するために,本番と同じ6台の AP サーバを稼働させて実施した。LB には,処理を平均的に分散させるために,ラウンドロビン方式が設定されている。
負荷テストは,11:00から12:00までの間に,主要業務の販売と購買のシステムを利用する社員に,日常的に行われる業務を処理してもらって行った。負荷テストは順調に進み,ほぼ期待どおりの結果が得られ完了した。負荷テストにおける,ある時間内での CPU 使用率を,表に示す。
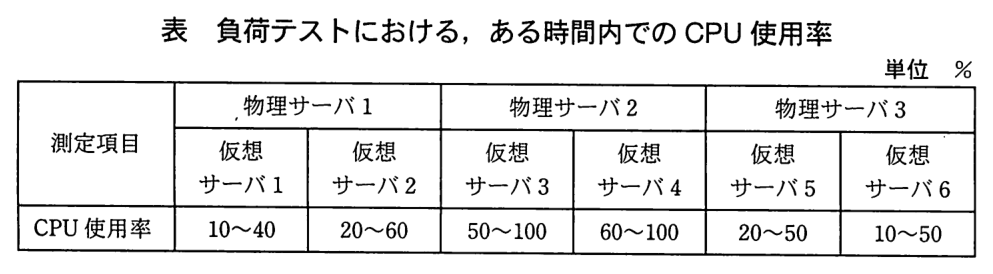
負荷テストで,6台の仮想サーバに処理が振り分けられたことを確認できた。しかし,CPU 使用率の高い状態が続いた仮想サーバが存在していた。振り分けられた処理との関係を調べたところ,メモリに読み込んだ商品マスタの大量のデータに対して,検索を伴う処理を実行した仮想サーバが,高負荷になることが判明した。新業務システムの中には,仮想サーバに大きな負荷を与えるプログラムがあるので,このようなプログラムを実行するサーバに負荷を集中させることなく,負荷を平準化するために,負荷分散方式の見直しを行うことにした。
データ移行テストでは,既存の業務システムから新業務システムへのトランザクションデータの移行が,正しく行えるかどうかを確認する。データ移行は,移行データの作成,移行データの取込み,及び移行データの確認の3段階で行われる。移行データは,既存の業務システムからトランザクションデータを抽出し,各種マスタとテーブルを参照して,加工処理が施されて作成される。移行データの取込みでは,取込みプログラムで,移行データを新業務システムに取り込む。移行データの確認では,新業務システムに取り込まれたデータの正当性を,新業務システムのプログラムでチェックする。データ移行テストを何回か繰り返した結果,問題なくデータ移行を行えることが確認できた。
以上の準備作業を行った後,システム切替え当日,システム切替スケジュールに従って,作業を実施した。システム切替スケジュールを,図6に示す。
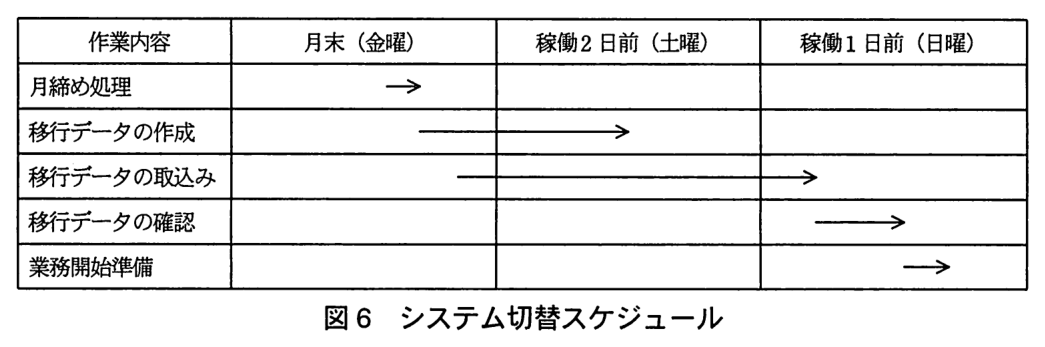
システムの切替えは,月末の金曜日から3日間掛けて実施した。金曜日の業務終了後に,月末の締め処理を行い,その後にデータ移行作業を開始した。移行データの確認後,月曜日の業務開始のための準備作業を行い,システム切替作業を終了した。データ移行作業の途中で問題が幾つか発生したが,必要な対応措置をとり,無事に新業務システムを稼働させることができた。
出題趣旨(IPA)
仮想化技術を適用したシステム構築が急速に拡大している。仮想化技術を適用したシステムは,その延長上にクラウドコンピューティングへの発展が予想でき,クラウドシステム構築においては,ネットワーク技術者が果たすべき役割は大きいものがある。本問では,仮想化技術を適用した基幹システムの再構築事例を取り上げて,ネットワーク技術者が保有すべき,サーバの冗長化や負荷分散方式の設計技術や,インターネット経由でのシステム利用法の改善,システム運用管理などの技術分野について問う。さらに,ネットワーク技術者の直接の業務ではないが,業務システム開発時には直面することが多いデータ移行やシステム切替えなど,プロジェクト推進のために理解していることが望まれる技術分野について,幅広く問う。
設問と解答例
本文中の a 〜 e に入れる適切な字句を答えよ。
〔a〕解答例
- IP-SAN
〔b〕解答例
- TCP
〔c〕解答例
- SCSI
〔d〕解答例
- ターゲット
〔e〕解答例
- スケーラビリティ
- 拡張性
解説
本文の根拠
〔システム基盤の設計〕
SAN には,FC-SAN と a がある。a を構成する代表的な技術が iSCSI(internet SCSI)である。
〔システム基盤の設計〕
iSCSI は,信頼性のあるデータ通信を行うために b プロトコルを使用する。
〔システム基盤の設計〕
iSCSI では,サーバで稼働し,c コマンドを発行して処理を要求するイニシエータと,ストレージ装置で稼働して,その処理を実行する d 間で,ブロックデータの入出力を実現させている。
〔システム基盤の設計〕
負荷分散装置(以下,LB という)を利用して,AP サーバの冗長性を高めるとともに,e も向上させることにした。
a:SAN はファイバチャネルで組む FC-SAN と,IP ネットワーク(イーサネット)の上に組む IP-SAN に分かれる。IP-SAN の代表的なプロトコルが iSCSI である。b:iSCSI は SCSI のコマンドとデータを TCP のコネクションに載せて運ぶ(RFC 7143,旧 RFC 3720)。再送や順序制御を TCP に任せることで“信頼性のあるデータ通信”を得ている。c:サーバ側のイニシエータは SCSI コマンドを発行してディスクの読み書きを要求する。d:その要求を受けて実行するストレージ側の相手をターゲットという(SCSI の用語をそのまま引き継いでいる)。e:LB の配下に AP サーバを足せば処理能力を増やせるので,冗長性と並べて挙がる効果はスケーラビリティ(拡張性)である。
根拠は各空欄の前後である。a は“FC-SAN と”並ぶものであり,iSCSI で構成されるもの。b は“信頼性のあるデータ通信”,c は“コマンドを発行して処理を要求する”,d は“イニシエータ”と対になる語である。e は LB の効果として“冗長性”と並べて書かれている。
間違えやすい点。b を IP とすると,IP 自体は信頼性を提供しないので合わない。d を“ストレージ”や“サーバ”とすると,iSCSI の役割名を答えていない。e を“可用性”とすると冗長性とほぼ同じ意味になり,“も向上させる”という追加の効果にならない。e はスケーラビリティ,拡張性のどちらでもよい。講評によると d,e の正答率が極端に低く,e の拡張性は LB が生み出す基本的な効果として知っておいてほしい,とされている。
採点講評(IPA)
設問1は,d,eの正答率が極端に低かった。eの拡張性は,負荷分散装置が生み出す基本的な効果なので,知識としてもっていてほしい。
本文中の下線①の状況の発生で,サービスが正常に提供できなくなる DB サーバの状態を,40字以内で述べよ。また,下線②の対応策の内容を,25字以内で述べよ。
〔状態〕解答例
- 一つのサービスが,クラスタシステム内の複数のノードで同時に起動する。
〔対応策〕解答例
- ハートビートのやり取りの回線を複数にする。
解説
本文の根拠
〔システム基盤の設計〕
DB サーバは,2台でアクティブスタンバイ型のクラスタシステムを構成し,仮想化機構を利用しないことにした。
〔システム基盤の設計〕
クラスタシステムでは,ハートビートパケットで各サーバの生存を確認するが,①各サーバが稼働しているにもかかわらず,ハートビートパケットを受信できなくなると,サービスを正常に提供できなくなる危険性がある。
図2
DB サーバ2台は互いに接続し,“クラスタシステム”の破線の枠で囲まれている。
アクティブスタンバイ型のクラスタでは,待機系はハートビートが途絶えたら“稼働系が停止した”と判断して,自分がサービスを引き継ぐ。ところが両方のサーバが動いているのにハートビートの経路だけが切れると,待機系も稼働系も“相手が止まった”と判断し,同じサービスが二つのノードで同時に起動してしまう(スプリットブレインと呼ばれる状態)。共有の SAN ストレージに両方から書き込めばデータが壊れる。対応策は,ハートビートをやり取りする回線を複数にして,1本が切れただけでは生存確認が途絶えないようにすることである。
根拠は下線①の“各サーバが稼働しているにもかかわらず”という条件と,図2で DB サーバ2台が互いに直接つながれていることである。この1本がハートビートの経路であり,ここが単一障害点になっている。
字数の詰め方。状態は“一つのサービスが”“複数のノードで同時に起動する”の2点を残す(解答例は34字)。“スプリットブレイン”という名称だけでは状態の説明にならないので,何が起きるかを書く。対応策は“ハートビートの回線を複数にする”が核で,解答例は21字である。
図2で,PC からの処理要求が AP サーバと DB サーバで処理されて,処理結果が PC に転送されてくる経路を,次の【転送経路】に示す。(a),(b)に入れるサーバと機器を,図2中の名称を用いて,【転送経路】の表記方法に従い,すべて記述せよ。【転送経路】PC→[ (a) ]→AP サーバ→L3SW→DB サーバ→L3SW→AP サーバ→[ (b) ]→PC
〔(a)〕解答例
- L2SW→L3SW→LB→L3SW
〔(b)〕解答例
- L3SW→LB→L3SW→L2SW
解説
本文の根拠
〔システム基盤の設計〕
利用する LB には,負荷分散時に送信元 IP アドレスを LB のものに付け替えるソース NAT 機能があるが,AP サーバを使用する PC を特定するために,この機能は利用しない。
〔システム基盤の設計〕
また,LB による AP サーバの稼働状態管理を確実に行うために,AP サーバからの返送パケットは,LB を経由させることにする。
図2
LB,TSV,SGSV 3台,DB サーバ2台はそれぞれ L3SW に接続している。L3SW の下に L2SW が2台あり,それぞれに複数の PC が接続している。
図2で LB は L3SW に1本だけでつながっている。PC からの要求は PC→L2SW→L3SW と上がり,負荷分散のために L3SW から LB へ渡され,LB が振り分け先を決めて L3SW に戻し,AP サーバへ届く。したがって (a) は L2SW→L3SW→LB→L3SW である。AP サーバは L3SW を経て DB サーバに問い合わせ,結果を受け取る。PC への返送は,本文の指定どおり LB を経由させるので,AP サーバ→L3SW→LB→L3SW→L2SW→PC となり,(b) は L3SW→LB→L3SW→L2SW である。
根拠は,LB が L3SW にしか接続していないこと(図2)と,“返送パケットは,LB を経由させる”という記述である。ソース NAT を使わないので,AP サーバから見た送信元は PC のアドレスのままであり,何もしなければ返送は LB を通らず L3SW から直接 PC へ向かってしまう。だから経由させる設定がわざわざ書かれている。
間違えやすい点。(b) で LB を省くと,“返送パケットは,LB を経由させる”という条件を落としている。また LB は L3SW にしかつながっていないので,LB と L2SW を直接つなぐ経路は書けない。“すべて記述せよ”とあるので,L3SW を2回通ることも省かずに書く。
重複除外処理にハッシュ関数を利用する利点を,30字以内で述べよ。
解答例
- データが同一かどうかのチェックが高速化できる。
解説
本文の根拠
〔データバックアップの検討〕
エージェントは,ハッシュ値同士の比較によって,更新されたブロックデータがバックアップ済かどうかをチェックする。
〔データバックアップの検討〕
このように,更新されたブロックデータから生成された Hx と Hz が,③のサーバデータのハッシュ値に存在するかどうかをチェックすることで,Dx と Dz が,既にバックアップされたブロックデータと重複しているかどうか判断される。
ハッシュ関数は,どんな長さのデータからも短い固定長の値を作る。ブロックデータそのものを既存の全ブロックと突き合わせるには大量のデータを読んで比べなければならないが,ハッシュ値同士なら短い値を比べるだけで済み,同一かどうかのチェックが高速になる。既存ブロックのハッシュ値の一覧(図3の③)もデータ本体より小さく,エージェント側で持っておける。
根拠は,エージェントが“ハッシュ値同士の比較によって”バックアップ済かどうかをチェックするという記述と,図3で③のハッシュ値の一覧がエージェントの処理の中に置かれていることである。
字数の詰め方。何が良くなるか(チェックが高速化できる)を主語に書く。“データが同一かどうかのチェック”と比較の対象を明示すると伝わる(解答例は23字)。“データ量が減る”は重複除外そのものの効果であり,ハッシュ関数を使う利点とは別なので避ける。講評では,設問3は予想以上の正答率だったとされている。
採点講評(IPA)
設問3の,ハッシュ関数をデータ照合に利用する利点,問題点及び改善策については,予想以上の正答率だった。ハッシュ関数が利用される分野が広がっていることもあり,よく理解されていた。
本文中の下線③の衝突によって引き起こされる問題を,30字以内で述べよ。
解答例
- 異なったデータを同じデータと判断してしまう問題
解説
本文の根拠
〔データバックアップの検討〕
ハッシュ値は,低い確率ではあるが,③ハッシュ値の衝突が発生するので,発生確率を更に低くするために,様々な対応策が考えられている。
〔データバックアップの検討〕
Hx は,③のハッシュ値の中に存在するので,Dx はバックアップされない。
ハッシュ値の衝突とは,異なるデータから同じハッシュ値が生成されることである。重複除外では“ハッシュ値が一致すれば同じデータ”とみなしてバックアップを省くので,衝突が起きると,実際には新しい内容のブロックを既存のブロックと同じと判断してしまい,そのブロックはバックアップされない。リストアすると別の内容が戻ることになる。
根拠は,“Hx は,③のハッシュ値の中に存在するので,Dx はバックアップされない”という判定の仕組みである。ハッシュ値が一致しただけでデータ本体は比べていないので,衝突がそのまま誤判定になる。
字数の詰め方。“異なったデータを同じデータと判断してしまう”が核である(解答例は23字)。余裕があれば“その結果バックアップされない”まで書いてもよいが,30字に収めるには判断の誤りだけを書けば足りる。
採点講評(IPA)
設問3の,ハッシュ関数をデータ照合に利用する利点,問題点及び改善策については,予想以上の正答率だった。ハッシュ関数が利用される分野が広がっていることもあり,よく理解されていた。
上記(2)の問題の発生確率を更に低くする方法について,考えられる方法を,50字以内で述べよ。
解答例(2通り)
- ブロックデータのCRCも合わせて生成し,ハッシュ値とCRCの両方を比較して判断する。
- ブロックデータを2分割し,それぞれのハッシュ値を生成して,それらをつなぎ合わせて比較する。
解説
本文の根拠
〔データバックアップの検討〕
ハッシュ値は,低い確率ではあるが,③ハッシュ値の衝突が発生するので,発生確率を更に低くするために,様々な対応策が考えられている。
図3
② バックアップ対象のブロックデータから生成されたハッシュ値。
1種類のハッシュ値だけで判定すると,その値が偶然一致したときに誤る。そこで,同じブロックから性質の違う検査値を別に作り,両方が一致したときだけ同一とみなせば,誤判定の確率は更に下がる。解答例の一つは CRC を併せて生成し,ハッシュ値と CRC の両方を比べる方法である。もう一つは,ブロックを2分割してそれぞれのハッシュ値を作り,つなぎ合わせて比べる方法で,比べる値が長くなるぶん偶然の一致が起きにくくなる。どちらも“比較に使う情報を増やす”という考え方である。
根拠は下線③の“発生確率を更に低くするために”である。衝突をなくすことはできないので,確率を下げる工夫を答える。
字数の詰め方。何を追加で作り,何と何を比べるかの2点を書く。解答例はそれぞれ42字,45字である。“ハッシュ値を長くする”“別のハッシュ関数を使う”のような書き方でも,何をどう比べるかまで書けば同じ考え方になる。どちらの解答例でも正解になる。
採点講評(IPA)
設問3の,ハッシュ関数をデータ照合に利用する利点,問題点及び改善策については,予想以上の正答率だった。ハッシュ関数が利用される分野が広がっていることもあり,よく理解されていた。
手順(ⅱ)の PC のチェックは,すべての PC に対して行われる。新 SSL-VPN 装置が PC に対して行う処理を,25字以内で述べよ。また,認証受付サーバと認証サーバ間の通信が発生する箇所を,連携処理手順(ⅰ)〜(ⅵ)の中から,すべて選んで答えよ。
〔PCに対して行う処理〕解答例
- 検疫のためのプログラムをダウンロードする。
〔通信が発生する箇所〕解答例
- (ⅲ),(ⅳ)
解説
本文の根拠
〔セキュリティ強化策と回線の検討〕
(ⅱ) 新 SSL-VPN 装置は,セキュリティポリシに従って,PC をチェックする。チェック項目には,セキュリティパッチ,稼働プロセス,ウイルス対策ソフトなどが設定できる。
〔セキュリティ強化策と回線の検討〕
利用者が,ログイン ID を入力すると,認証受付サーバは,ログイン ID を基に,ランダムな数表を取得し,次の処理に移る。
〔セキュリティ強化策と回線の検討〕
入力された数値がチェックされ,正しければ,新 SSL-VPN 装置にリダイレクトされ,ログイン ID とパスワードが,新 SSL-VPN 装置に送信される。
図4
注2 認証サーバは,ランダムな数表の発行や認証処理を行う。RADIUS サーバ機能ももつ。
PC のセキュリティパッチや稼働プロセス,ウイルス対策ソフトの状態は,PC の内部を調べないと分からない。ブラウザで接続してきただけの PC を外から調べることはできないので,新 SSL-VPN 装置はまず検疫(チェック)用のプログラムを PC にダウンロードさせ,それを PC 上で動かして結果を受け取る。これが“PC に対して行う処理”である。
認証受付サーバと認証サーバの間の通信は,認証サーバの役目(図4 注2:“ランダムな数表の発行や認証処理”)を認証受付サーバが使う場面で起きる。(ⅲ) では認証受付サーバがランダムな数表を“取得”し,これは発行元の認証サーバから受け取る。(ⅳ) では入力された数値が“チェックされ”,この照合も数表を持つ認証サーバが行う。(ⅴ) の RADIUS による認証要求は新 SSL-VPN 装置から認証サーバへの通信で,認証受付サーバは関わらない。したがって (ⅲ),(ⅳ) である。
字数の詰め方。処理は“検疫のためのプログラムをダウンロードする”のように,PC に対して何をするかを書く(解答例は21字)。“PC をチェックする”では設問文の言い換えにとどまる。箇所は“すべて”とあるので (ⅲ) と (ⅳ) の両方を挙げ,(ⅴ) を入れないこと。
セキュリティ強化策によって,セキュリティ面で改善される点を二つ挙げ,それぞれ25字以内で述べよ。
〔①〕解答例
- パスワードの安全性が高まる。
- PCのセキュリティチェックが行われる。
〔②〕解答例
- パスワードの安全性が高まる。
- PCのセキュリティチェックが行われる。
〔備考〕二つの点を①②に一つずつ答える(順不同)
解説
本文の根拠
〔セキュリティ強化策と回線の検討〕
外出先から T 社内のシステムを利用するときの認証は,ログイン ID と固定パスワードだけで行われているので,セキュリティ上の問題を洗い出し,強化策を検討することにした。
〔セキュリティ強化策と回線の検討〕
調査した結果,ワンタイムパスワード方式の認証システムを導入し,既設の SSL-VPN 装置の代わりに,PC のセキュリティチェック機能をもち,認証システムと連携も可能な SSL-VPN 装置(以下,新 SSL-VPN 装置という)を導入すれば,少ない変更でセキュリティを強化できることが分かった。
強化策は二つの部品でできている。一つはワンタイムパスワード方式の認証システムで,毎回ランダムな数表から読み取った値を入力するので,固定パスワードのように盗み見や漏えいで使い回されることがなく,パスワードの安全性が高まる。もう一つは新 SSL-VPN 装置の PC チェック機能で,パッチ未適用やウイルス対策ソフトの無い PC を接続させないようにできる。
根拠は,現状が“ログイン ID と固定パスワードだけ”であることと,強化策として“ワンタイムパスワード方式の認証システム”と“PC のセキュリティチェック機能をもち”の二つが挙がっていることである。
字数の詰め方。それぞれ“何がどう良くなるか”を1文で書く(解答例は14字,19字)。導入する機器名だけ(“ワンタイムパスワードの導入”)では,改善される点になっていない。①②の順はどちらでもよい。
認証システムを導入したときに,FW に新たに許可設定すべき通信を二つ挙げ,それぞれ送信元とあて先を明確にして,25字以内で答えよ。
〔①〕解答例
- 認証受付サーバから認証サーバへの通信
- 新SSL-VPN装置から認証サーバへの通信
- インターネットから認証受付サーバへの通信
〔②〕解答例
- 認証受付サーバから認証サーバへの通信
- 新SSL-VPN装置から認証サーバへの通信
- インターネットから認証受付サーバへの通信
〔備考〕解答例は3項目を挙げている。①②には,このうち異なる二つを答える(順不同)
解説
本文の根拠
図4
本社では,インターネットにルータ1 が接続し,ルータ1 の下に FW,FW の下に L3SW がある。L3SW には認証サーバが接続している。FW には DMZ の L2SW が接続し,DMZ の L2SW には新 SSL-VPN 装置と認証受付サーバが接続している。
〔セキュリティ強化策と回線の検討〕
チェック結果が正常のときには,認証受付サーバにリダイレクトされる。
〔セキュリティ強化策と回線の検討〕
(ⅴ) 新 SSL-VPN 装置は,受信したログイン ID とパスワードを基に,RADIUS プロトコルで,認証サーバに対し認証を要求する。
図4で認証受付サーバと新 SSL-VPN 装置は DMZ に,認証サーバは FW の内側(L3SW 配下)にある。認証システムの導入で新しく生まれる通信のうち,FW を通るものを拾う。一つ目は,数表の取得と数値のチェック(設問4(1)の (ⅲ)(ⅳ))のための,DMZ の認証受付サーバから内部の認証サーバへの通信。二つ目は,(ⅴ) で新 SSL-VPN 装置が RADIUS で認証を要求する,DMZ の新 SSL-VPN 装置から内部の認証サーバへの通信(RADIUS は UDP を使う。RFC 2865)。三つ目は,PC がリダイレクトされて認証受付サーバの画面を開く,インターネットから DMZ の認証受付サーバへの通信である。解答例はこの三つを挙げており,このうち二つを答えればよい。
根拠は図4の機器の配置(どの機器が FW のどちら側にあるか)と,連携処理手順で誰が誰と通信するかである。インターネットから新 SSL-VPN 装置への通信は既設の SSL-VPN 装置でも許可されていたので,“新たに”には当たらない。
字数の詰め方。“○○から○○への通信”の形で送信元とあて先を両方書く(解答例は18〜21字)。機器名は図4の名称どおりに書く。①②の順はどちらでもよい。
本文中の [ ア ] に入れる数値を求めよ。答えは,小数点以下を切り上げて整数で求めよ。
〔ア〕解答例
- 8
解説
本文の根拠
〔セキュリティ強化策と回線の検討〕
本社と営業所間で発生するトラフィックは,日中最大となり,7M ビット/秒であった。このうち,既存の業務システム利用のトラフィックが40%である。このトラフィックは,新業務システムの利用で,1.3倍になることが見込まれる。
〔セキュリティ強化策と回線の検討〕
これらの条件から,本社と営業所間の最大トラフィックは,[ ア ] M ビット/秒であり,増加量は少ないことが判明した。
7M ビット/秒のうち業務システムのトラフィックは 7×0.4=2.8M ビット/秒,それ以外が 7−2.8=4.2M ビット/秒である。業務システム分だけが1.3倍になるので 2.8×1.3=3.64M ビット/秒。合計は 3.64+4.2=7.84M ビット/秒で,小数点以下を切り上げて 8 になる。
根拠は,日中最大 7M ビット/秒,そのうち業務システムが 40%,それが 1.3 倍という三つの数値である。図1の注にある IP-VPN の回線速度 10M ビット/秒に対しても収まるので,“継続して利用可能”という結論と合う。
間違えやすい点。全体を1.3倍にして 7×1.3=9.1(切り上げで 10)とすると,1.3倍になるのは業務システム分だけという条件を落としている。また 7.84 を四捨五入ではなく切り上げるので 8 である(この場合はどちらでも 8 になる)。
本文中の下線④の発見方法を,50字以内で述べよ。
解答例
- 指定された範囲内のIPアドレスあてにpingを発行し,応答の有無でホストの存在を判断する。
解説
本文の根拠
〔システムの運用管理方式の設計〕
統合監視システムには,④監視対象機器を発見して,接続構成図を自動作図する機能があるので,管理者は,接続構成図の中から,監視するネットワーク機器を選択することができる。
〔システムの運用管理方式の設計〕
ネットワーク機器の監視は SNMP で行われ,ネットワーク機器の稼働状態を,MIB 情報の定期的な収集によって監視するとともに,Trap の受信によって異常を検知する。
監視システムがまだ知らない機器を見つけるには,あり得るアドレスに片端から問い合わせて,返事の有無で存在を判断すればよい。代表的なのが,指定した範囲の IP アドレスに ping(ICMP エコー要求,RFC 792)を順に送り,エコー応答が返ってきたアドレスにホストが存在すると判断する方法である。見つけた機器には SNMP で MIB を問い合わせて,機器の種類や接続先を調べ,接続構成図を作る。
根拠は下線④の“監視対象機器を発見して”である。監視を始める前の段階なので,機器の一覧はまだ無い。この状況で機器を知る方法を答える。
字数の詰め方。“どこに”(指定された範囲内の IP アドレス),“何を送り”(ping),“どう判断するか”(応答の有無)の3点を入れる(解答例は45字)。講評は,ping や arp のユニキャストとブロードキャストの動作,arp テーブルから何が分かるかも改めて考えてほしいとしている。
採点講評(IPA)
設問5(1)は,ノード発見の方法について問うた。プロトコルの基本動作を理解することは重要なので,ping,arpのユニキャストとブロードキャストの動作に加えて,arpテーブルから何が分かるかなどを,改めてじっくり考えてほしい。
本文中の下線⑤の監視では,性能管理を効果的に行うために,どのような監視方法が必要か。50字以内で述べよ。
解答例
- 仮想サーバと,仮想サーバが稼働する物理サーバの稼働状態とを対比して監視できるようにする。
解説
本文の根拠
〔システムの運用管理方式の設計〕
監視項目には,CPU,メモリなどの使用率,サービスとプロセスの稼働状態及びイベントログの内容がある。
〔システムの運用管理方式の設計〕
仮想サーバを活用したシステムでは,仮想サーバの稼働状態監視だけでは十分でないので,⑤通常のサーバ監視よりも複雑な監視が必要になる。
図2
注2 各 SGSV では,2台の AP サーバが稼働する。
仮想サーバは1台の物理サーバの CPU やメモリを複数で分け合っている。ある仮想サーバの性能が落ちたとき,その仮想サーバの使用率だけを見ても,原因が自分の処理なのか,同じ物理サーバ上の別の仮想サーバが資源を使っているのかは分からない。そこで,仮想サーバの稼働状態と,それが動いている物理サーバの稼働状態を対比して監視できるようにする。
根拠は下線⑤の直前の“仮想サーバの稼働状態監視だけでは十分でない”と,図2の注2(1台の SGSV の上で2台の AP サーバが動く)である。
字数の詰め方。“仮想サーバ”と“それが稼働する物理サーバ”の両方を挙げ,“対比して”監視することを書く(解答例は44字)。“物理サーバも監視する”だけでは,二つを結び付けて見るという要点が抜ける。
本文中の下線⑥のチューニング内容を,25字以内で述べよ。
解答例
- 障害に結びつくログだけを検出するようにする。
解説
本文の根拠
〔システムの運用管理方式の設計〕
収集した情報の中に異常が発見されたときには,その内容がメッセージ表示画面に表示される。
〔システムの運用管理方式の設計〕
イベントログの監視では,フィルタ機能の活用が必要になり,フィルタの条件設定には,⑥運用後のチューニングが必要になる。
イベントログには通常の動作を記録しただけのものも大量に含まれる。すべてを異常としてメッセージ表示すると,本当に対応すべきものが埋もれてしまう。逆に絞り過ぎると障害の兆候を見逃す。どのログが障害に結びつくかは実際に運用してみないと分からないので,運用しながらフィルタ条件を見直し,障害に結びつくログだけを検出するように調整する。これがチューニングの内容である。
根拠は下線⑥の“フィルタの条件設定には”と,異常が“メッセージ表示画面に表示される”という監視の流れである。
字数の詰め方。チューニングの目標(障害に結びつくログだけを検出する)を書く(解答例は22字)。“フィルタ条件を変更する”だけでは,何のために変えるかが抜ける。
負荷テストで判明した状況を基に,負荷分散効果をより高められる負荷分散方式を,30字以内で答えよ。
解答例
- CPU使用率の低いAPサーバに処理を振り分ける。
解説
本文の根拠
〔システムの切替え〕
LB には,処理を平均的に分散させるために,ラウンドロビン方式が設定されている。
表
物理サーバ2:仮想サーバ3 は50〜100,仮想サーバ4 は60〜100。
〔システムの切替え〕
このようなプログラムを実行するサーバに負荷を集中させることなく,負荷を平準化するために,負荷分散方式の見直しを行うことにした。
ラウンドロビン方式は要求を順番に振り分けるだけで,各サーバが今どれだけ忙しいかは見ない。重い検索処理を受けた仮想サーバにも,次の順番が来れば新しい要求が送られるので,負荷の偏りが続く。負荷テストの表でも,仮想サーバ3・4 が 50〜100%,60〜100% と高く,ほかは 10〜60% にとどまっている。そこで,各 AP サーバの CPU 使用率を LB が把握し,使用率の低いサーバに処理を振り分ける方式にすれば,負荷が平準化される。
根拠は,ラウンドロビン方式が設定されていることと,表で CPU 使用率が仮想サーバによって大きく異なること,“負荷を平準化するために”という見直しの目的である。
字数の詰め方。振り分けの基準(CPU 使用率の低い AP サーバ)を具体的に書く(解答例は24字)。“負荷の低いサーバ”とだけ書くと何で負荷を測るのかが伝わらないので,負荷テストで測った CPU 使用率を基準として書く。
データ移行テストの目的を,25字以内で述べよ。
解答例(3通り)
- データ抽出,加工ロジックの正当性の確認
- 新業務システムにおけるマスタデータの完全性の確認
- データ移行に要する時間の確認
解説
本文の根拠
〔システムの切替え〕
データ移行は,移行データの作成,移行データの取込み,及び移行データの確認の3段階で行われる。
〔システムの切替え〕
移行データは,既存の業務システムからトランザクションデータを抽出し,各種マスタとテーブルを参照して,加工処理が施されて作成される。
図6
移行データの取込み:移行データの作成の開始より少し後の月末(金曜)の終わり近くから,稼働1日前(日曜)の初めまで。
データ移行テストで確かめることは,本番の移行が正しく,時間内に終わるかどうかである。解答例は三つを挙げており,どれか一つを書けばよい。一つ目は,トランザクションデータを抽出し加工するロジックが正しいかの確認。二つ目は,加工で参照する新業務システムのマスタデータがそろっているか(完全性)の確認。三つ目は,移行に要する時間の確認で,図6のように金曜夜から日曜までの限られた時間に収まるかを見積もるために要る。
根拠は,移行データが“抽出し,各種マスタとテーブルを参照して,加工処理が施されて作成される”という記述(ロジックとマスタ)と,図6で移行作業が週末の限られた期間に組まれていること(時間)である。
字数の詰め方。“何の確認か”を名詞で締める形にすると25字に収まる(解答例は14〜24字)。“データ移行が正しく行えるかどうかを確認する”は本文の言い換えにとどまるので,何を確かめるのかまで具体的に書く。
システム切替スケジュールの立案において明確にすべき事項を,問題発生時の措置の面から二つ挙げ,それぞれ40字以内で述べよ。
〔①〕解答例
- データ移行時に予測できる問題を事前に明確化して,対応策を作っておく。
- システム切替えを断念するときの判断基準と,それを決定する時間を明確化する。
〔②〕解答例
- データ移行時に予測できる問題を事前に明確化して,対応策を作っておく。
- システム切替えを断念するときの判断基準と,それを決定する時間を明確化する。
〔備考〕二つの事項を①②に一つずつ答える(順不同)
解説
本文の根拠
〔システムの切替え〕
移行データの確認後,月曜日の業務開始のための準備作業を行い,システム切替作業を終了した。
〔システムの切替え〕
データ移行作業の途中で問題が幾つか発生したが,必要な対応措置をとり,無事に新業務システムを稼働させることができた。
図6
列は作業内容,月末(金曜),稼働2日前(土曜),稼働1日前(日曜)。
切替えは金曜の業務終了後から日曜までに終え,月曜には業務を始めなければならない。途中で問題が起きたときに慌てないよう,スケジュールの立案時に二つを決めておく。一つは,データ移行時に起こり得る問題をあらかじめ洗い出し,それぞれの対応策を用意しておくこと。もう一つは,問題が解決できないときにシステム切替えを断念し,既存システムで月曜の業務を続ける判断をするための基準と,その判断を下す時刻を決めておくことである。
根拠は,切替えが月末の金曜から3日間という期限付きの作業であること(図6)と,“データ移行作業の途中で問題が幾つか発生した”という実績である。
字数の詰め方。一つ目は“予測できる問題を事前に明確化し,対応策を作っておく”,二つ目は“断念するときの判断基準と,決定する時間を明確化する”が核である(解答例は34字,37字)。二つ目は基準だけでなく“いつ決めるか”まで書くと,期限のある切替えに即した答えになる。①②の順はどちらでもよい。講評では,必要事項を的確に指摘した解答が過半数を占め,予想以上の正答率だったとされている。
採点講評(IPA)
設問6(3)は,システム切替え時に明確化すべき事項について問うた。本文で記述したシステム切替えは,アプリケーション技術者寄りの分野だったが,ネットワーク技術者としての体験や学んだ知識を生かして,必要事項を的確に指摘した解答が過半数を占め,予想以上の正答率だった。
出典:平成22年度 秋期 ネットワークスペシャリスト試験 午後Ⅱ 問1(表記を一部改変)