令和6年度 春期に実施されたITサービスマネージャ試験
午後Ⅰの全3問(記述式)です。事例本文・設問・解答例と解説をそのまま読めます。
この年度を解いてみる
問1 サービスの予算業務及び会計業務
サービスの予算業務及び会計業務に関する次の記述を読んで,設問に答えよ。
Q 社は,個人投資家を対象とした証券会社で,東京の本社にサービス事業本部と情報システム本部があり,全国に営業店がある。サービス事業本部には T 事業部と U 事業部があり,情報システム本部にはシステム開発部と IT インフラ部がある。システム開発部は,システムの開発と保守を担当している。IT インフラ部は,システム運用を担当し,サーバやストレージなどのハードウェア及びソフトウェア(以下,これらを IT インフラ群という)を管理している。IT インフラ部は,サービス事業本部に対して,運用しているシステムを IT サービスとして提供している。
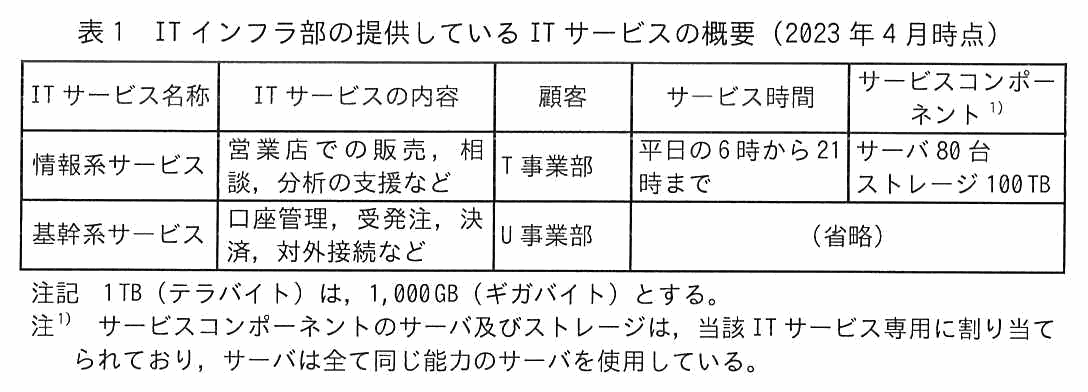
Q 社の IT インフラ群は,V 社が運営するデータセンター(以下,DC という)にハウジングされている。Q 社は,DC の施設・設備をハウジングサービスとして利用している。IT インフラ部の提供している IT サービスの概要を表1に示す。
表1 IT インフラ部の提供している IT サービスの概要(2023 年 4 月時点)
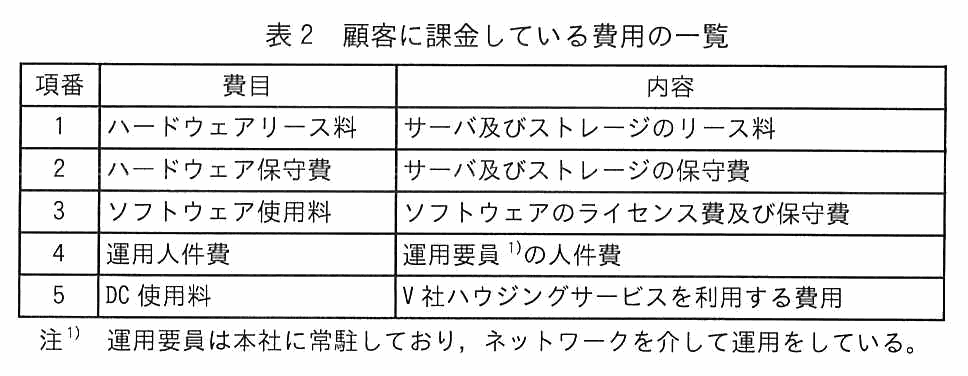
IT インフラ部は,IT サービスを運用するために掛かる費用を算出し,顧客に課金している。現在,顧客に課金している費用の一覧を表2に示す。
表2 顧客に課金している費用の一覧
IT インフラ部は,表2の費用を次のように管理している。特定事業部の IT サービスで専用に使用されている費用を,直接費として当該事業部に割り当てる。直接費にはハードウェアリース料,ハードウェア保守費及びソフトウェア使用料がある。運用人件費及び DC 使用料は,費用の総額を各事業部に按分し,間接費として配賦している。なお,DC 使用料は固定料金制の長期契約となっており,2026 年 3 月まで費用の変動はない。
〔情報系サービスの移行計画〕
2023 年度末である 2024 年 3 月に,情報系サービスを構成するサービスコンポーネントの IT インフラ群が保守期限切れになる。これに伴い,IT インフラ部は,2023 年 6 月までに IT インフラ群の移行方針を策定することになり,IT サービスマネージャ S 氏が担当となった。Q 社を利用する個人投資家は年々増加しており,情報系サービスが対象とするデータ量も増加している。2023 年 4 月,S 氏は,今後の情報系サービスの需要見込みについて T 事業部と協議した。S 氏は,協議した需要見込みを基に,2024 年度期初に 2023 年度期初に比べて 20%の容量・能力増加が必要で,その後も順次容量・能力の増加が必要となると予測した。IT インフラ部は,需要の変化に対応する迅速な容量・能力変更の必要性及び費用の抑制を考慮し,情報系サービスで専用に使用する IT インフラ群を外部のクラウドサービスに移行し,2024 年 3 月から利用を開始する移行方針を立てた。なお,運用要員は IT サービスのシステム運用業務を行っており,移行後も運用業務量の変動はない予定である。
S 氏は,複数のクラウド事業者に提供サービスについてヒアリングした上で評価し,R 社のクラウドサービス(以下,R クラウドという)を候補として選定した。R クラウドでは,利用者の要求に応じて,サーバとストレージのリソース使用量を動的に割り当てること(以下,リソースオンデマンドという)ができる。R 社から管理ツールとその使用権限が与えられ,これによってリソースオンデマンドの機能を使うことができる。
〔R クラウド利用料の見積り〕
S 氏は,IT インフラ部における情報系サービスの予算管理者としての役割を担っている。S 氏は,クラウドサービス移行後の予算案策定に向け,R クラウド利用料の見積りを行うことにした。まず,ソフトウェア使用料については,移行後も費用の変動がないことを確認した。次に,R クラウドには,サーバとストレージのリソースに対応したサービスがあり,それぞれ次の価格モデルがあることを確認した。
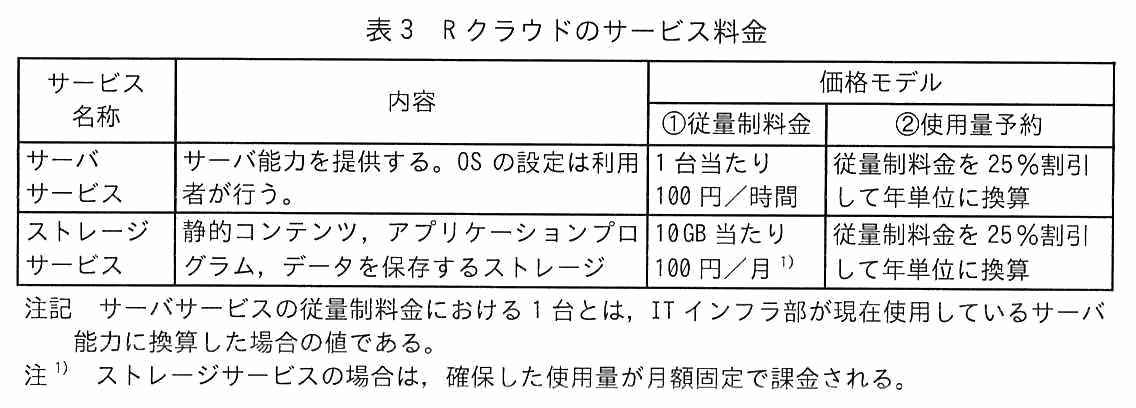
① 従量制料金:サーバは時間単位,ストレージは月単位に割り当てたリソース使用量に応じて課金額が決まる方式 ② 使用量予約:一定のリソース使用量を,1 日 24 時間で 365 日分年間予約することで,予約した年単位のリソース使用量分の従量制料金に年間割引を適用する。 R クラウドのサービス料金を,表3に示す。
表3 R クラウドのサービス料金
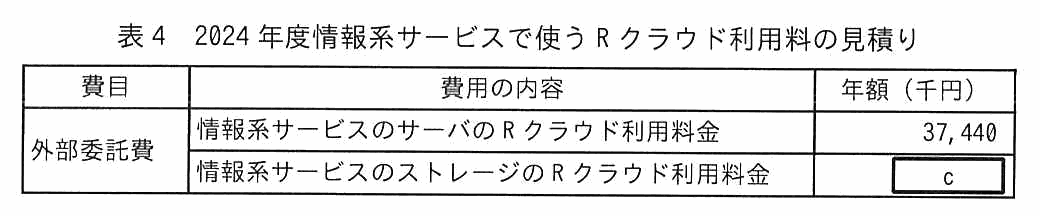
情報系サービスのサーバは,“①従量制料金”の価格モデルの場合,サービス時間だけ利用するので,1 台当たりの年間リソース使用時間は a 時間となる。したがって,価格モデルとして b を適用した方が,他方の価格モデルよりも低額となる。また,情報系サービスのストレージは,価格モデルとして“②使用量予約”を適用し,予算案を策定する方針とした。S 氏は,2024 年度に情報系サービスで使う R クラウドの利用料を外部委託費として見積もり,表4にまとめた。ここで,2024 年度は,期初の需要見込みに対応した容量・能力を確保し,2024 年度中は,容量・能力に変動がないものとした。
表4 2024 年度情報系サービスで使う R クラウド利用料の見積り
IT インフラ部は,S 氏の見積りをレビューし,費用を抑制できると評価した。そこで,IT インフラ部は,クラウドサービス移行についてシステム開発部及びサービス事業本部と協議を開始した。
〔サービス事業本部への費用の提示〕
S 氏は,クラウドサービス移行後の T 事業部への情報系サービスの課金額を検討した。S 氏は,表4で示す費用以外に,表2の費目のうち,クラウドサービス移行後もソフトウェア使用料,運用人件費及び DC 使用料は継続して発生するとの前提をおいて,課金すべき直接費と間接費を算出した。
IT インフラ部では,直接費は実績に基づき各事業部に課金している。その際に,関連する作業負荷,容量・能力の情報も報告し,予算及び需要見込みに対して実績が適切かどうかを各事業部も把握できるようにしている。S 氏は,(ア)新たに割り当てる直接費についても関連するリソース実績を T 事業部に報告する ことにした。
次に S 氏は,移行後の間接費について,配賦額を検討し,IT インフラ部内でレビューをした。R クラウドに移行した場合,“(イ)現在の間接費の配賦の方法では問題がある ”との指摘があり,S 氏は,配賦の方法の見直しを検討し,2024 年度に T 事業部が支払う費用の見込み案(以下,2024 年度課金案という)を作成した。
IT インフラ部は,2024 年度課金案をサービス事業本部に提示し,合意を得た。その後,IT インフラ部は,Q 社の変更管理プロセスに従い,R クラウドへの移行について変更要求を提出した。変更要求は規定に従って審査され,R クラウドへの移行が決定された。Q 社では,R クラウドを使って情報系サービスが正常に稼働することを,機能面・性能面から確認する必要があるので,システム開発部を中心として関連部署からメンバーが招集され,移行プロジェクトが発足し,2023 年 8 月から 2024 年 3 月まで活動を行うことになった。なお,2024 年 3 月までの R クラウドの利用料・移行作業費などは,移行プロジェクトの費用とする予算措置がとられた。
また,2024 年度課金案は,移行プロジェクトの結果を反映して見直しを行い,2024 年度の予算を策定することになった。策定された予算は,規定に従って承認された後,2024 年 3 月に利害関係者に通知される。
〔予算と費用実績の管理に向けた検討〕
S 氏は,予算管理者として,予算がどのように執行されるかを監視する責任がある。S 氏は,移行後の R クラウドを含む予算と費用実績の管理について,検討を開始した。
2024 年 1 月に,S 氏は,移行プロジェクトの状況をヒアリングした。ヒアリングの結果は,次のとおりである。
システム開発部と IT インフラ部のプロジェクト担当者が,R クラウド上で情報系サービスが正常に稼働することを,機能面と性能面で確認できた段階である。 Q 社では,2024 年度後半に個人投資家向けに,新商品の販売キャンペーンを行う計画があり,計画の実施に当たって情報系サービスの需要が急増する見込みがある。T 事業部と IT インフラ部のプロジェクト担当者は,リソースオンデマンドを使って迅速にリソース拡張を行うことで,急増する需要に対応できることを確認している。 S 氏は,販売キャンペーンを行う計画を織り込んで情報系サービスの需要を見直し,2024 年度予算に反映することにした。しかし,2024 年 3 月時点で,販売キャンペーンの規模などは不透明で,販売キャンペーンの規模を拡大して実施することになった場合に,現時点の販売キャンペーンの計画よりも需要は増加することが考えられる。S 氏は,このような事業環境の中で本番運用を開始した場合,(ウ)予算管理上のリスク があると認識した。S 氏は,リスクが顕在化することを想定し,事業環境変化に対応してタイムリーにリソースオンデマンドを活用できるように(エ)必要な対策 を検討し,本番運用開始までに利害関係者に徹底することにした。
出題趣旨(IPA)
クラウドサービスの利用が進み,クラウドサービスの料金体系と特徴を踏まえた予算化を行うこと,及び予算と発生する費用を管理することが重要になる。本問では,ITサービスの予算業務及び会計業務を題材として,費用の分類と費目ごとに費用を明確にする能力,予算を策定する能力,予算が適切に実行されているか監視し管理する能力などを問う。
設問と解答例
設問1(1)
本文中の a に入れる適切な数値を答えよ。ここで,情報系サービスにおける 1 年間の平日は 260 日とする。
解答例
解説
本文の根拠
表1
情報系サービスは,営業店での販売,相談,分析の支援などを内容とし,顧客は T 事業部,サービス時間は平日の 6 時から 21 時まで,サービスコンポーネントはサーバ 80 台とストレージ 100TB。
〔Rクラウド利用料の見積り〕
情報系サービスのサーバは,“①従量制料金”の価格モデルの場合,サービス時間だけ利用するので
サービス時間は平日の6時から21時までなので,1日15時間。1年の平日は260日と設問に与えられている。
15 × 260 = 3,900時間。
「サービス時間だけ利用する」と本文が断っているので,24時間ではなく15時間で数える。ここを24時間にすると,次の設問の価格モデルの比較まで狂う。
設問1(2)
本文中の b に入れる表3中の価格モデルの記号①又は②を答えよ。
解答例
解説
本文の根拠
表3 サーバサービス
①従量制料金は 1 台当たり 100 円/時間,②使用量予約は従量制料金を 25%割引して年単位に換算。
〔Rクラウド利用料の見積り〕
② 使用量予約:一定のリソース使用量を,1 日 24 時間で 365 日分年間予約することで,予約した年単位のリソース使用量分の従量制料金に年間割引を適用する。
サーバ1台の年額を,2つの価格モデルで出して比べる。
①従量制は,使った時間だけ払う。100円 × 3,900時間 = 390,000円。
②使用量予約は,1日24時間で365日分をまとめて予約する。時間数は 24 × 365 = 8,760時間。25%引きなので 100円 × 8,760 × 0.75 = 657,000円。
①のほうが安い。割引率は25%あるが,予約では動かさない夜間や休日のぶんまで払うことになり,時間数が3,900時間に対して8,760時間と2倍以上になる。25%の割引では埋まらない。
平日の日中しか動かさないサービスでは,予約より従量制が有利になる,という形で覚えておくとよい。
設問1(3)
表4中の c に入れる適切な数値を答えよ。
解答例
解説
本文の根拠
表1
サービスコンポーネントはサーバ 80 台とストレージ 100TB
〔情報系サービスの移行計画〕
2024 年度期初に 2023 年度期初に比べて 20%の容量・能力増加が必要で
表3 ストレージサービス
①従量制料金は 10GB 当たり 100 円/月,②使用量予約は従量制料金を 25%割引して年単位に換算。
表1 注記
1TB(テラバイト)は 1,000GB(ギガバイト)とする。
落とし穴は容量の増加である。表1の100TBは2023年4月時点の値で,2024年度期初には20%増やす必要がある。
100TB × 1.2 = 120TB = 120,000GB。
従量制は10GB当たり100円/月なので,月額は 120,000 ÷ 10 × 100 = 1,200,000円。年額は 14,400,000円。
ストレージは“②使用量予約”を適用する方針なので25%引き。14,400,000 × 0.75 = 10,800,000円,つまり10,800千円。
表4のサーバ側で検算できる。サーバも20%増で 80台 × 1.2 = 96台。①従量制なので 100円 × 3,900時間 × 96台 = 37,440,000円。表4に書かれている37,440千円と一致する。20%増を忘れていればここが合わないので,見積りの前に必ず突き合わせる。
採点講評(IPA)
設問1(3)は,正答率が低かった。予算の見積りでは,需要の変化,容量・能力の変化を考慮して見積りを行い,予算化することが必要であることを理解してほしい。
設問2(1)
30字以内
本文中の下線(ア)について,IT サービスの需要見込みに対する実績の差異を把握する観点で,報告すべきリソース実績は何か。30 字以内で答えよ。
解答例
解説
本文の根拠
〔サービス事業本部への費用の提示〕
直接費は実績に基づき各事業部に課金している。その際に,関連する作業負荷,容量・能力の情報も報告し,予算及び需要見込みに対して実績が適切かどうかを各事業部も把握できるようにしている。
〔Rクラウド利用料の見積り〕
① 従量制料金:サーバは時間単位,ストレージは月単位に割り当てたリソース使用量に応じて課金額が決まる方式
「新たに割り当てる直接費」は,移行後のRクラウド利用料である。移行前のハードウェアリース料などに代わって,表4のとおり外部委託費として直接費に入る。
Rクラウドの料金は,サーバなら時間単位,ストレージなら月単位の使用量で決まる。つまり費用の裏付けになる実績は,使用量そのものである。
金額だけを渡しても,T事業部は需要見込みとの差を追えない。見込みより使ったから増えたのか,使用量は見込みどおりなのかが分かれるからである。使用量を並べて初めて差異の原因が見える。
30字。解答例は「Rクラウドのサーバとストレージの使用量」で18字。サーバとストレージの両方を挙げる。
設問2(2)
30字以内
本文中の下線(イ)について,指摘された問題の内容を,30 字以内で答えよ。
解答例(2通り)
Rクラウド移行後もDC使用料を間接費として配賦すること DCを利用しないT事業部にもDC使用料が按分されること
解説
本文の根拠
冒頭
運用人件費及び DC 使用料は,費用の総額を各事業部に按分し,間接費として配賦している。なお,DC 使用料は固定料金制の長期契約となっており,2026 年 3 月まで費用の変動はない。
〔情報系サービスの移行計画〕
情報系サービスで専用に使用する IT インフラ群を外部のクラウドサービスに移行し,2024 年 3 月から利用を開始する移行方針を立てた。なお,運用要員は IT サービスのシステム運用業務を行っており,移行後も運用業務量の変動はない予定である。
冒頭
Q 社の IT インフラ群は,V 社が運営するデータセンター(以下,DC という)にハウジングされている。
間接費は運用人件費とDC使用料の2つしかない。移行後どうなるかを1つずつ見る。
運用人件費は,本文に「移行後も運用業務量の変動はない」とあるので,これまでどおり按分してよい。
DC使用料は事情が違う。情報系サービスのITインフラ群はDCから出ていくので,T事業部はDCを使わなくなる。それでも総額を按分し続ければ,使っていない設備の費用をT事業部が負担することになる。しかもDC使用料は2026年3月まで固定で総額は下がらないので,移行して費用を抑えたはずのT事業部にそのしわ寄せが行く。
30字。設問が聞いているのは間接費の配賦である。Rクラウド利用料は直接費なので,ここで答えるものではない。
採点講評(IPA)
設問2(2)は,正答率が低かった。直接費であるクラウド利用料金について誤って解答した受験者も見受けられた。ITサービスを移行した場合,直接費だけでなく間接費の配賦方法にも着目することが必要なことを,是非知っておいてもらいたい。
設問3(1)
35字以内
本文中の下線(ウ)の予算管理上のリスクを,35 字以内で答えよ。
解答例
急増する需要に対応してリソースを拡張し,予算を超過する。
解説
本文の根拠
〔予算と費用実績の管理に向けた検討〕
2024 年 3 月時点で,販売キャンペーンの規模などは不透明で,販売キャンペーンの規模を拡大して実施することになった場合に,現時点の販売キャンペーンの計画よりも需要は増加することが考えられる。
〔予算と費用実績の管理に向けた検討〕
T 事業部と IT インフラ部のプロジェクト担当者は,リソースオンデマンドを使って迅速にリソース拡張を行うことで,急増する需要に対応できることを確認している。
〔Rクラウド利用料の見積り〕
① 従量制料金:サーバは時間単位,ストレージは月単位に割り当てたリソース使用量に応じて課金額が決まる方式
予算に織り込めるのは,2024年3月時点で分かっている販売キャンペーンの計画までである。規模が拡大すれば,予算に入っていない需要が出てくる。
そこにリソースオンデマンドがある。管理ツールで手早くリソースを増やせるので,需要そのものには応えられる。だが料金は従量制なので,増やしたぶんはそのまま費用になる。
つまり「需要に応えるために増やした結果,予算を超える」というのがリスクである。増やせること自体が問題なのではなく,増やすと費用が予算を超えるところが予算管理上のリスクになる。
35字。解答例は「急増する需要に対応してリソースを拡張し,予算を超過する。」で27字。需要が増えるとだけ書くと予算の話にならないので,予算超過まで言い切る。
設問3(2)
40字以内
本文中の下線(エ)について,予算管理者として検討すべき対策を,40 字以内で答えよ。
解答例
予算を超過して費用支出をする場合の承認手順を作り,利害関係者と合意する。
解説
本文の根拠
〔予算と費用実績の管理に向けた検討〕
S 氏は,予算管理者として,予算がどのように執行されるかを監視する責任がある。
〔予算と費用実績の管理に向けた検討〕
事業環境変化に対応してタイムリーにリソースオンデマンドを活用できるように
〔情報系サービスの移行計画〕
R 社から管理ツールとその使用権限が与えられ,これによってリソースオンデマンドの機能を使うことができる。
条件は2つある。タイムリーにリソースオンデマンドを使えること,そして予算管理者としての対策であること。
拡張を禁じたり,そのつど上位者の判断を待つ形にすると,タイムリーさが失われる。逆に自由に増やさせれば予算を超える。どちらも条件を満たさない。
そこで,予算を超える支出をするときの承認の手順をあらかじめ決めておき,利害関係者と合意しておく。手順が決まっていれば,その場で判断して拡張できる。事前に決めておくから,タイムリーさと予算の監視が両立する。
40字。リソースにしきい値を決めて監視するのは容量・能力管理であって,予算の話ではない。使ってから請求するのでは,執行を監視する責任を果たしたことにならない。
採点講評(IPA)
設問3(2)は,正答率が低かった。リソースにしきい値を設定して監視するという容量・能力管理の観点での解答や,予算超過した費用支出の後に請求するという解答が見受けられた。予算の超過が見込まれる場合は,費用支出の前に対応方法について合意形成できるような手順を整備することが,ITサービスマネージャの重要な役割である。
出典:令和6年度 春期 ITサービスマネージャ試験 午後Ⅰ 問1(表記を一部改変)
問2 IoT を活用した駅務サービスの可用性
IoT を活用した駅務サービスの可用性に関する次の記述を読んで,設問に答えよ。
E 社は,関西圏を中心とした中堅の鉄道事業者である。大阪の本社を中心として,3 路線 50 駅の運営を行っている。E 社本社には駅業務部と情報システム部がある。駅業務部は,E 社が運営する各駅の業務を統括している。情報システム部では,発売した乗車券などの集計を行う駅務システムを運用している。
駅では,ハードウェアメーカーの F 社が提供する自動改札機,自動券売機及び窓口端末(以下,これらを駅務機器という)を導入して,駅の出改札業務を行っている。窓口端末は全ての駅に最低 1 台設置されており,自動券売機で取り扱う全ての出改札業務に対応するほか,駅員が窓口端末を使って駅務システムを利用できる。また,自動改札機と自動券売機は,駅構内の LAN を経由して窓口端末と接続されており,駅員は,窓口端末を使って,当該駅の駅務機器の稼働状態を確認することができる。窓口端末で駅務機器の稼働状態の異常を検知し,故障などで保守員による対応が必要と判断した場合,駅員は駅業務部に電話連絡し,駅業務部経由で F 社保守員の手配が行われる。
情報システム部は,駅務機器及び駅構内の LAN の管理を行っており,駅業務部及び各駅に対して,駅務システムの運用を含めて,駅務サービスとして提供している。E 社では,全ての駅の営業時間は同じ時間帯であり,駅務サービスでは,駅の営業時間をサービス提供時間としている。
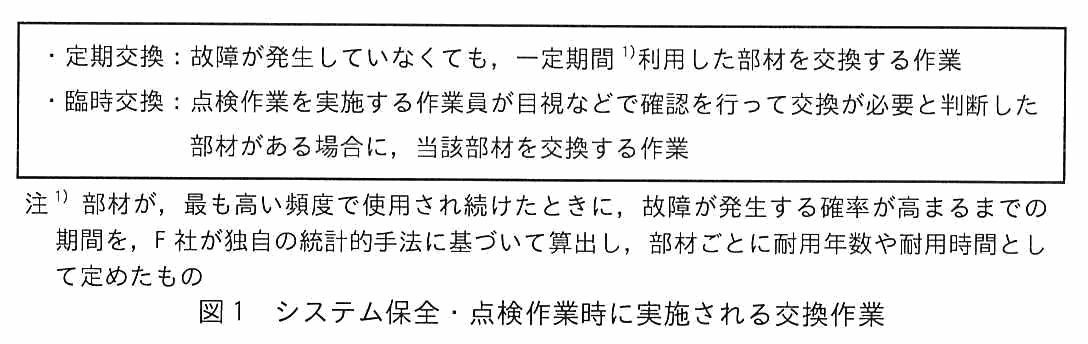
情報システム部では,駅務機器のシステム保全・点検作業の計画を立て,全ての駅の駅務機器に対して定期的にシステム保全・点検作業を行うことで,故障前に対応を行う予防保全に取り組んでいる。システム保全・点検作業は F 社に業務委託されており,駅務機器のシステム保全・点検作業の対象部品(以下,部材という)に対して,必要に応じ,図1に示す交換作業が行われる。
図1 システム保全・点検作業時に実施される交換作業
システム保全・点検作業は,自動券売機と窓口端末については夜間の営業停止時間帯に行われているが,自動改札機は点検作業の回数と台数が多く,営業時間内に行われている。自動改札機のシステム保全・点検作業に伴う計画停止については,駅の利用者に事前案内され,利用者は他の自動改札機を使うか駅員による改札を受ける。
〔現状の課題と改善策の検討〕
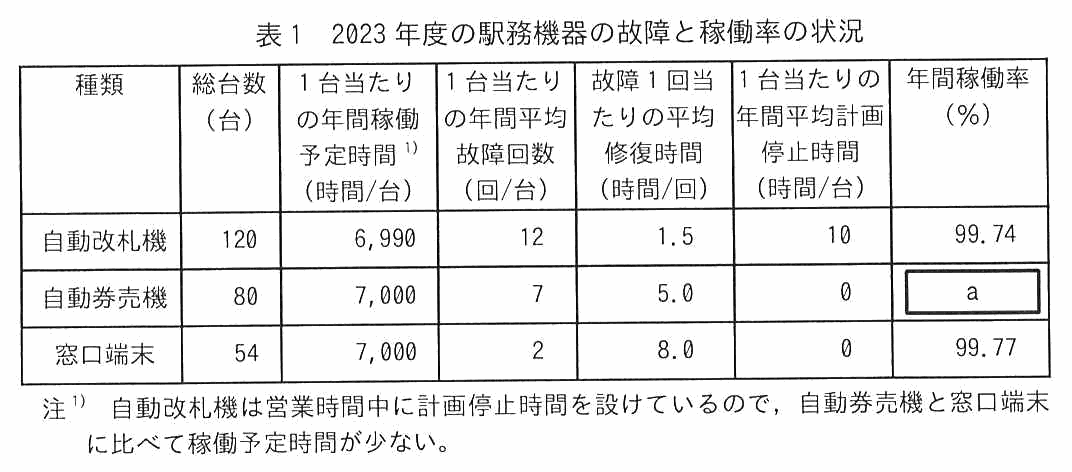
情報システム部では,駅務機器の安定稼働を維持するために,F 社に業務委託してシステム保全・点検作業で必要となった部材の交換を行っているが,一部の駅務機器では故障が発生しており,予防保全に取り組む情報システム部の課題となっていた。駅務サービスの可用性の一つの指標として駅務機器の稼働率を採用している。2023 年度の状況を表1に示す。
表1 2023 年度の駅務機器の故障と稼働率の状況
駅務機器の年間稼働率は,年度ごとに種類別に次の式で計算する。ここで,年間稼働率(%)は小数第 3 位を四捨五入するものとする。
全台の年間稼働予定時間の合計 - 全台の年間故障修復時間の合計
────────────────────────────────
           全台の年間稼働予定時間の合計
2024 年度,情報システム部では,システム保全・点検作業コストの削減に取り組む方針が示された。そこで,IT サービスマネージャの G 氏を中心に,現状の課題及びコスト削減の方針への対応を検討することにした。
まず,G 氏は,課題となっている駅務機器の安定稼働の維持について,駅務機器の稼働率の数値を確認した上で,駅務機器の故障発生を減少させる必要があると考えた。
次に,G 氏は,システム保全・点検作業コストの削減について考えた。現在の定期交換の対象部材には,実際にはまだ使えるものがあって,無駄が多い。そこで,データ分析を活用した CBM(Condition Based Maintenance:状態基準保全)システムを導入することでコストを削減できないかと考えた。G 氏は,機器の動作状況を取得する IoT センサーを設置し,収集したデータを分析して故障の可能性が高まった時点で,対象部材を交換することによって無駄なコストを抑えることができると考えた。また,CBM システムを導入した場合,現在行っているシステム保全・点検作業と比べて,(ア)サービス提供者としてのサービス可用性管理の観点からもメリットを期待できる 。G 氏は,これらの仕組みを CBM システムとして構築し,社内で活用する検討に着手した。
〔CBM システムの構築準備〕
G 氏は,CBM システムの構築に当たって,まず,どのデータをどのように取得するかを検討するため,F 社に相談した。その結果,駅務機器の中でも故障頻度が高く,全ての駅務機器に含まれている券片の搬送機構に着目し,券片が搬送機構を通過する速度(以下,搬送速度という)のデータを取得対象に決めた。また,搬送速度を取得するには IoT センサーの設置が必要となるが,F 社からは,既存の駅務機器を大きく改造することなく設置が可能であり,少額の投資で搬送速度データを駅務システムに送信する仕組みを実現できるとの回答があった。
次に,G 氏は,取得したデータから搬送速度の低下を検知するための(イ)しきい値 を設け,継続的に監視する仕組みを構築した。搬送速度がしきい値を下回った場合には,アラームリストを出力し,その情報を,駅業務部及び当該の駅務機器が稼働する駅に対して速やかに通知されるようにした。
また,現行の駅務機器のシステム保全・点検作業について,今回は点検対象の一部に CBM システムを導入することで,点検対象を削減し,点検作業時間も削減できると考えた。
G 氏は,社内の変更管理規程に従って,CBM システムを構築する変更要求を提出した。情報システム部長は,“CBM システムは,(ウ)点検対象の機器数の削減及び点検作業時間の削減以外のコスト削減効果も期待できる。 また,今後対象機器を拡大し,点検作業の頻度を減らしたり,無くしたりできれば,将来的に大きなコスト削減にもつながる”と評価した。変更要求は承認され,CBM システムの構築が開始された。
〔SNS データの分析を活用した障害検知〕
CBM システム構築中のある日,行楽イベントで混雑するある駅で,駅務機器が故障するインシデントが発生し,駅構内が混雑した。当該駅では,駅の利用客対応を優先し,駅業務部への障害連絡が遅れてしまった。インシデントの初動対応が遅れて解決までに時間を要し,駅務サービスの可用性が悪化した。
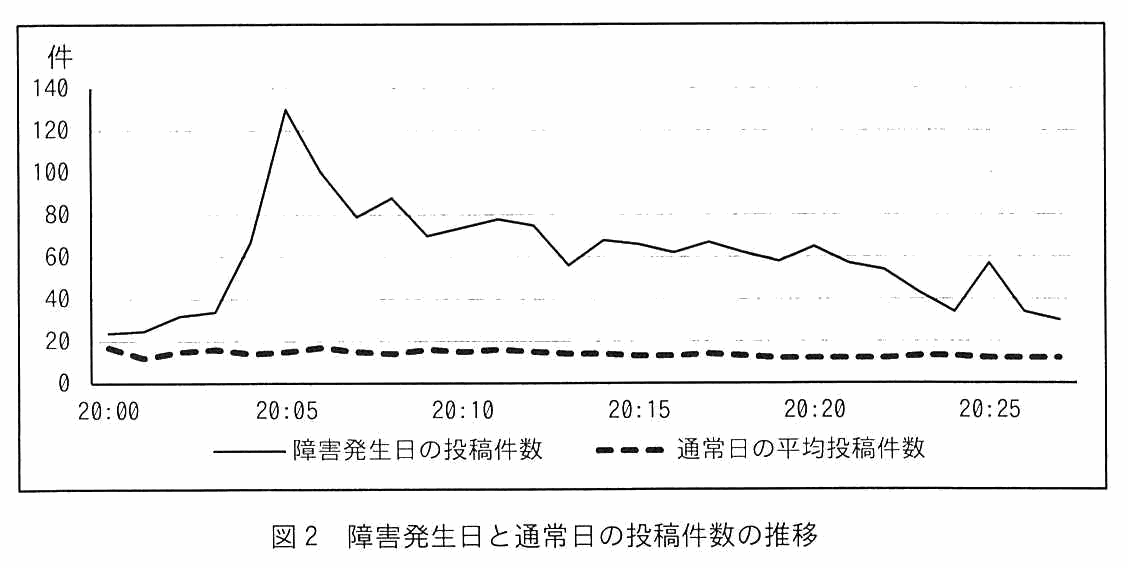
情報システム部では,インシデント対応中にインシデントの影響の大きさを把握するために,E 社が提供する不特定多数の人が閲覧可能な SNS への投稿内容から利用者の反響を調査した。SNS への投稿は,“情報源が不特定多数であって現場からの情報より正確性は低いが,情報の早さは現場よりも早い場合がある”といった特性がある。調査を担当した G 氏は,調査の過程で,E 社が当該インシデントの対応を開始する前に,障害に関する幾つかの投稿があることに気付いた。当該インシデント対応が終了した後日,投稿を時系列に整理して 1 分ごとに集計したところ,投稿件数が図2のように推移していることが分かった。
図2 障害発生日と通常日の投稿件数の推移
情報システム部では,障害当日 20:10 に駅業務部からの障害連絡を受け,20:15 にインシデントの対応を開始していた。また,SNS 上では障害に関する最初の投稿は 20:00 であった。この結果を見て,G 氏は,SNS の特性に着目し,自社の駅務機器に関する障害発生を検知できないか検討することにした。
G 氏は,SNS の情報を使って障害を検知する仕組みを,次のステップで考えた。
① SNS 上における障害に関する投稿(以下,障害投稿という)を定義する。 ② 障害が発生したと推定するための条件(以下,検知条件という)を定義する。 G 氏は,①の障害投稿の定義として,“「E 社」「(E 社の) 駅」などの E 社に関する情報”と“「通れない」「使えない」「障害」などのネガティブワード”の両方が含まれる投稿とした。また,②の検知条件として,次のような条件を抽出した。
1 分当たりの投稿件数が基準値以上であること 1 分当たりの障害投稿件数が基準値以上であること 1 分ごとに 5 分連続で障害投稿件数が増加傾向にあること G 氏は,三つの検知条件の全てを採用すると検知遅れや検知漏れが増え,(エ)一つだけに絞ると誤検知が増える と考えた。そこで,三つの検知条件のうちの二つを満たす場合に障害が発生していると判定することにした。
出題趣旨(IPA)
近年,IoTデバイスなどを構成品目とするITサービスが増えており,ITサービスマネージャには,構成品目の特性を捉えた管理が求められる。本問では,IoTを活用した駅務サービスを題材として,稼働率や計画停止といったサービスの可用性管理に関する実践的な能力を問うとともに,SNSデータの分析を使った障害検知の早期化による可用性の改善能力を問う。
設問と解答例
設問1(1)
表1中の a に入れる適切な数値を答えよ。答えは小数第 3 位を四捨五入して,小数第 2 位まで求めよ。
解答例
解説
本文の根拠
計算式
全台の年間稼働予定時間の合計 - 全台の年間故障修復時間の合計
表1
自動券売機は 80 台,7,000 時間,7 回,5.0 時間,0 時間,年間稼働率は空欄 a。
式の分子は「稼働予定時間の合計 - 故障修復時間の合計」である。故障修復時間は表に直接は載っていないので,故障回数と1回当たりの修復時間から作る。
自動券売機は80台。稼働予定時間の合計は 80 × 7,000 = 560,000時間。故障修復時間の合計は 80 × 7回 × 5.0時間 = 2,800時間。
(560,000 - 2,800)÷ 560,000 = 0.995,つまり99.50%。
台数は分子・分母の両方に掛かるので,1台当たりで計算しても同じ値になる。(7,000 - 35)÷ 7,000 = 0.995。
計画停止時間を引きたくなるが,引いてはいけない。表1の注1のとおり,計画停止のぶんは稼働予定時間からあらかじめ差し引かれている(自動改札機だけ7,000時間ではなく6,990時間なのがその印)。自動改札機で検算すると(6,990 - 12×1.5)÷ 6,990 = 0.99742…で,表の99.74%と一致する。
設問1(2)
25字以内
本文中の下線(ア)について,期待できるメリットを,25 字以内で答えよ。
解答例
解説
本文の根拠
冒頭
自動改札機は点検作業の回数と台数が多く,営業時間内に行われている。
表1 注1
自動改札機は営業時間中に計画停止時間を設けているので,自動券売機と窓口端末に比べて稼働予定時間が少ない。
〔CBMシステムの構築準備〕
今回は点検対象の一部に CBM システムを導入することで,点検対象を削減し,点検作業時間も削減できると考えた。
「サービス可用性管理の観点から」と条件が付いている。可用性管理はサービスを使える時間の話なので,故障が減るという答えはここでは外れる。
表1を見ると,自動改札機だけ年間稼働予定時間が6,990時間で,他の2つの7,000時間より10時間少ない。注1のとおり,営業時間中に計画停止しているからである。点検の回数と台数が多くて夜間に収まらない,というのが理由である。
CBMシステムで点検対象と点検作業時間が減れば,この計画停止も減る。つまりサービスを提供できる時間が増える。これが可用性の観点でのメリットになる。
25字。解答例は「計画停止時間を削減することができる。」で18字。
採点講評(IPA)
設問1(2)は,正答率は平均的であった。サービス可用性管理の観点からのメリットを問う設問に対し,故障の観点から解答する受験者が多かった。
設問2(1)
40字以内
本文中の下線(イ)について,従来の点検作業と比べて,CBM システムのしきい値を使った運用のメリットとは何か。駅務機器の故障の観点から,40 字以内で答えよ。
解答例
作業員が目視で判断していた故障の前兆を,データに基づいて判断できる。
解説
本文の根拠
図1 臨時交換
臨時交換は,点検作業を実施する作業員が目視などで確認を行って交換が必要と判断した部材がある場合に,当該部材を交換する作業。
〔CBMシステムの構築準備〕
取得したデータから搬送速度の低下を検知するための
従来の点検作業で故障の前ぶれを見つけていたのは,図1の臨時交換である。作業員が目視などで確認して交換の要否を判断していた。つまり判断がその作業員の腕に左右される。同じ部材でも,見る人が変われば結論が変わりうる。
しきい値は数値である。搬送速度がその値を下回ったかどうかで決まるので,誰が見ても同じ判断になる。
40字。解答例は「作業員が目視で判断していた故障の前兆を,データに基づいて判断できる。」で33字。
狙いは「正確になる」ではなく「客観的になる」ところにある。目視よりデータのほうが精度が高い,とは本文のどこにも書いていない。書いてあるのは「作業員が目視などで確認して判断していた」という一点なので,そこと対にして答える。
採点講評(IPA)
設問2(1)は,正答率が低かった。CBMシステムの導入によって,作業員よりも正確に故障を検知できる,検知率を向上できるなどの誤答が多かった。従来の点検作業が熟練作業員のノウハウに依存しているという問題点を的確に捉え,誰もが同じように判断できる客観性を担保できる旨の内容を解答してほしい。
設問2(2)
45字以内
本文中の下線(ウ)について,情報システム部長が CBM システムにコスト削減効果を期待できると考えた理由を,45 字以内で答えよ。
解答例
定期交換と比べて部材を長期間利用するので,部材の交換頻度を減らすことができるから
解説
本文の根拠
図1 定期交換
定期交換は,故障が発生していなくても,一定期間利用した部材を交換する作業。
図1 注1
一定期間とは,部材が最も高い頻度で使用され続けたときに故障が発生する確率が高まるまでの期間を,F 社が独自の統計的手法に基づいて算出し,部材ごとに耐用年数や耐用時間として定めたもの。
〔現状の課題と改善策の検討〕
現在の定期交換の対象部材には,実際にはまだ使えるものがあって,無駄が多い。
定期交換の「一定期間」がどう決まっているかが鍵である。注1のとおり,最も高い頻度で使われ続けたときを前提に算出した期間である。つまり一番厳しい使い方に合わせてあるので,実際にはまだ使える部材が多く含まれる。本文も「無駄が多い」と書いている。
CBMシステムは搬送速度という実際の状態を見て,故障の可能性が高まってから交換する。同じ部材をより長く使えるので,交換の回数そのものが減る。
点検の手間が減るのとは別に,部材の費用が減る。これが「点検対象の機器数の削減及び点検作業時間の削減以外の」コスト削減効果である。
45字。解答例は「定期交換と比べて部材を長期間利用するので,部材の交換頻度を減らすことができるから」で39字。
設問3(1)
20字以内
G 氏の検討に従って SNS への投稿を活用した場合,今回のようなインシデントが発生したとき,どのような改善が期待できるか。20 字以内で答えよ。
解答例
解説
本文の根拠
〔SNSデータの分析を活用した障害検知〕
当該駅では,駅の利用客対応を優先し,駅業務部への障害連絡が遅れてしまった。インシデントの初動対応が遅れて解決までに時間を要し,駅務サービスの可用性が悪化した。
〔SNSデータの分析を活用した障害検知〕
情報システム部では,障害当日 20:10 に駅業務部からの障害連絡を受け,20:15 にインシデントの対応を開始していた。また,SNS 上では障害に関する最初の投稿は 20:00 であった。
今回のインシデントの時刻を並べると,SNSの最初の投稿が20:00,駅からの連絡が20:10,対応開始が20:15である。
連絡が遅れたのは,駅が利用客の対応を優先したからで,駅を責めても直らない。ところがSNSにはその10分前から投稿が出ていた。SNSで検知できていれば,駅からの連絡を待たずに動き出せる。
初動が10分以上早まれば解決も早まり,「初動対応が遅れて解決までに時間を要し,可用性が悪化した」という今回の流れを断てる。
20字。解答例は「インシデントの初動対応の早期化」で15字。障害の検知が早くなるだけでは改善にならないので,初動対応まで書く。
設問3(2)
25字以内
G 氏が,検知条件について本文中の下線(エ)のように考えたのは,どのような理由からか。SNS への投稿の特性を表した本文中の字句を使って,25 字以内で答えよ。
解答例
解説
本文の根拠
〔SNSデータの分析を活用した障害検知〕
SNS への投稿は,“情報源が不特定多数であって現場からの情報より正確性は低いが,情報の早さは現場よりも早い場合がある”といった特性がある。
〔SNSデータの分析を活用した障害検知〕
三つの検知条件の全てを採用すると検知遅れや検知漏れが増え,
設問が「SNSへの投稿の特性を表した本文中の字句を使って」と指定しているので,特性が書いてある1文を探す。本文には,情報源が不特定多数で現場より正確性は低い,ただし現場より早いことがある,と2つ書いてある。
使うのは正確性のほうである。投稿しているのは不特定多数なので,障害と関係のない投稿や思い違いも混ざる。条件を1つに絞れば,そうした投稿だけで障害と判定してしまう。だから誤検知が増える。
逆に3つ全部を求めると条件が厳しくなりすぎて,検知が遅れたり漏れたりする。間を取って2つを満たすことにした,という流れである。
25字。解答例は「情報の正確性が,現場からの情報より低いから」で20字。一般論としてのSNSの問題点ではなく,本文が挙げた特性で答える。
採点講評(IPA)
設問3(2)は,正答率は平均的であった。SNSへの投稿の特性を表した解答を求めているにもかかわらず,自らがもつ知識や一般的なSNSの課題などから解答する受験者が散見された。設問の内容に沿った解答をするよう留意してもらいたい。
出典:令和6年度 春期 ITサービスマネージャ試験 午後Ⅰ 問2(表記を一部改変)
問3 コンテナ型仮想環境における運用管理
コンテナ型仮想環境における運用管理に関する次の記述を読んで,設問に答えよ。
W 社は,オンラインゲームのアプリケーションソフトウェア(以下,ゲームアプリという)を企画,開発及び運用している。W 社の開発部は,開発環境と試験環境を利用して,ゲームアプリの開発と保守を行っている。W 社の運用部は,開発されたゲームアプリを稼働環境で運用し,W サービスとしてスマートデバイスからインターネットを経由してゲームを行う利用者に提供している。開発環境の管理は開発部が,試験環境及び稼働環境の管理は運用部が担当している。W サービスの提供時間帯は,ゲームアプリ改修に必要な計画停止時間を除いた 24 時間 365 日となっている。
〔ゲームアプリの開発と運用における課題〕
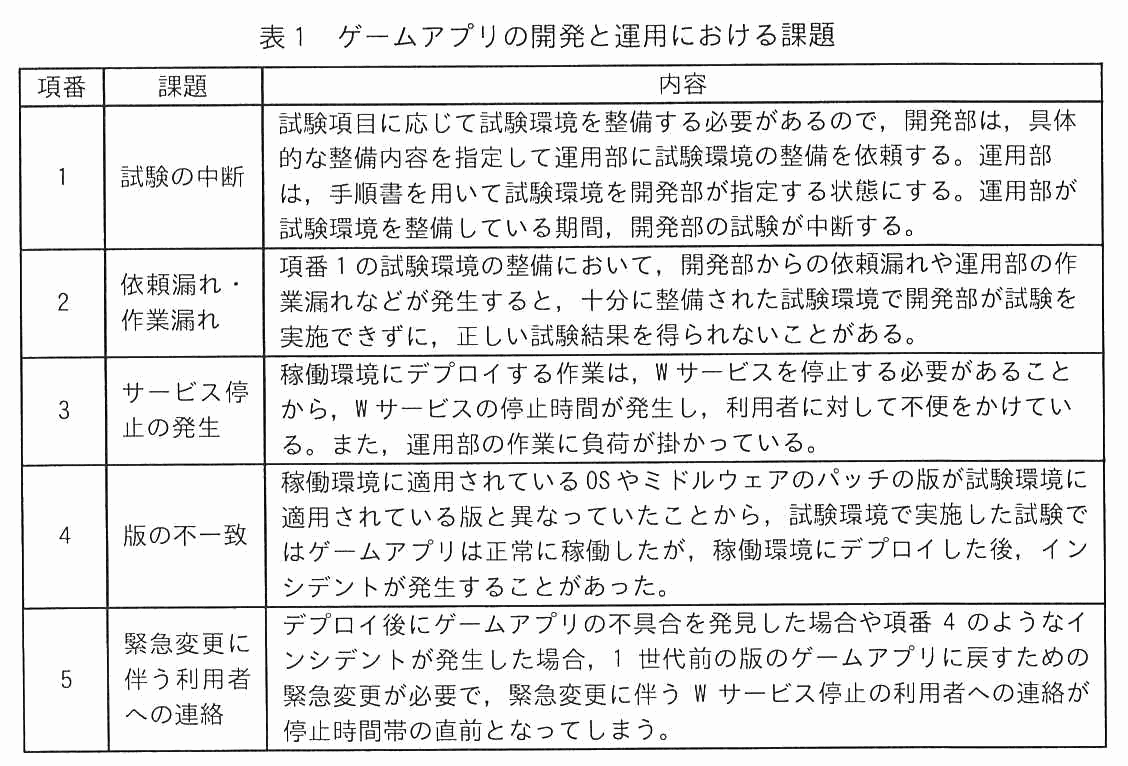
ゲームアプリの競争が激しく機能追加のための改修が多いので,新たな版のゲームアプリを週 1 回の頻度で稼働環境にデプロイする必要がある。開発部と運用部では,開発に掛かる期間を短縮し,リリース頻度を高めているが,ゲームアプリの開発と運用には表1に示す課題がある。
表1 ゲームアプリの開発と運用における課題
開発部の Y 氏は,アプリケーションが稼働する環境を,高速かつ簡単に生成できるコンテナ技術を導入することによって,表1の項番 1 や項番 2 の課題を解決できないかと考えた。
〔コンテナ技術〕
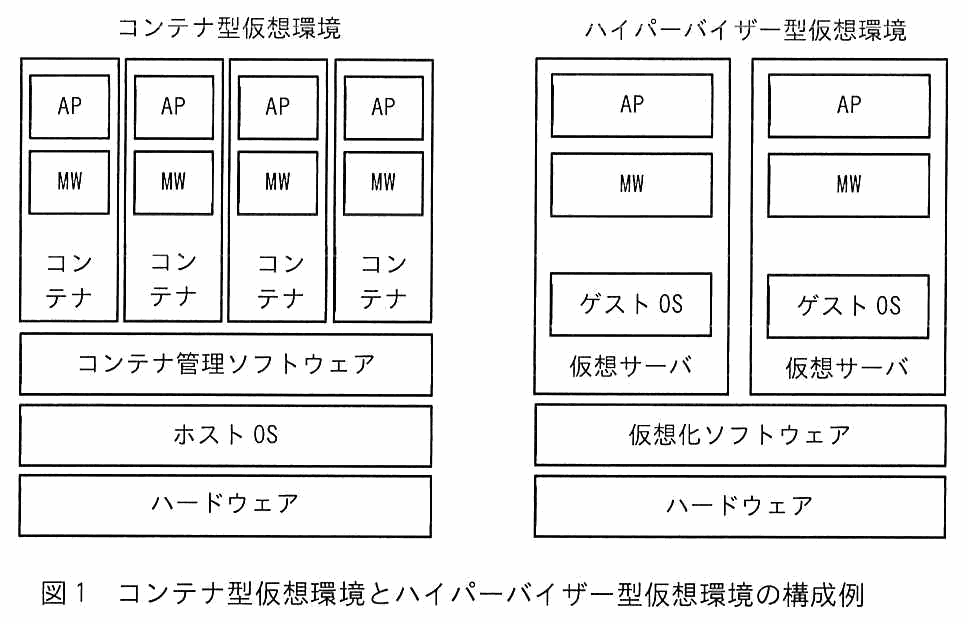
コンテナ技術とは,アプリケーションプログラム(以下,AP という),ミドルウェア(以下,MW という)などを一つにまとめたもの(コンテナ)をホスト OS のコンテナ管理ソフトウェア上で仮想環境として動作させる技術のことで,次のような特徴がある。
開発者が自らに必要な環境を専有して開発できる。 サーバのリソースを有効利用でき,環境の準備,起動,廃棄などを迅速に行うことができる。 別の環境への移行が簡単にできる。 コンテナ型仮想環境とハイパーバイザー型仮想環境の構成例を図1に示す。
図1 コンテナ型仮想環境とハイパーバイザー型仮想環境の構成例
〔コンテナ型仮想環境の導入検討〕
W サービスは,運用部が運用する W システムによって実現されている。W システムの稼働環境及び試験環境は,2 台の物理サーバ,通信装置,外部記憶装置など,W 社の設備を使って構成されている。物理サーバのうち 1 台では,AP の不具合によって AP が停止した場合でも W サービスを継続できるようにハイパーバイザー型仮想環境で,二つのアプリケーションサーバ(以下,アプリサーバという)を稼働させている。他の物理サーバでも,同様に二つのデータベースサーバが稼働している。
Y 氏は,運用部の IT サービスマネージャである Z 氏にコンテナ技術の導入について意見を求めた。Z 氏は,試験項目に応じたコンテナをあらかじめ用意しておくことで,現在のコンテナの廃棄と用意されたコンテナの起動を行うことができるので,試験環境の整備を迅速かつ正確に行うことができると考えた。また,AP の不具合によって AP が停止するインシデントが発生した場合,現在の運用では,原因を調査後,原因となった問題を除去して再度 AP の起動を行っているが,その間は 2 台のアプリサーバのうち 1 台だけしか稼働していない状態となる。コンテナ技術を導入すれば,複数のコンテナを稼働させることができることに加えて,(ア)コンテナを稼働させてインシデント発生前の状態に戻すまでの時間を短縮できる と考えた。
〔デプロイ方法の改善〕
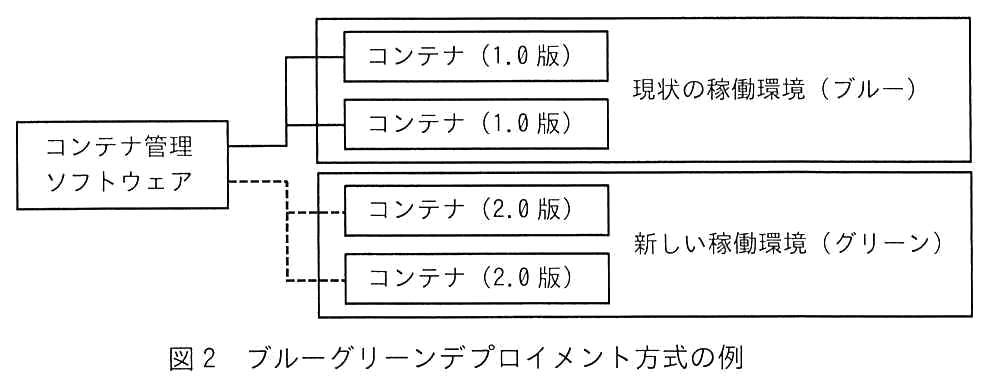
Z 氏は,ゲームアプリの開発と運用における課題に対して,コンテナ型仮想環境を活用したデプロイ方法を,ブルーグリーンデプロイメント方式にすることにした。この方式では,二つの稼働環境を用意して,利用者が使う稼働環境を切り替えられるようにする。具体的には,現状の稼働環境(ブルー)とは別に,新しい稼働環境(グリーン)を構築して最新版の AP を準備しておき,デプロイする日時に合わせて,利用者が使う稼働環境を切り替える運用方法のことである。
ブルーグリーンデプロイメント方式の例を図2に示す。
図2 ブルーグリーンデプロイメント方式の例
図2の例では,現状の稼働環境(ブルー)で 1.0 版のコンテナが稼働している。新しい稼働環境(グリーン)に 2.0 版のコンテナを起動させておき,コンテナ管理ソフトウェアを使って,現在の稼働環境をブルーからグリーンに変更する。(イ)2.0 版のコンテナの動作に問題がないことを確認できた場合 ,1.0 版のコンテナを停止し,1.0 版のコンテナを廃棄する。
〔コンテナ型仮想環境の検証〕
Z 氏と Y 氏は,コンテナ型仮想環境の検証を実施するための環境を新たに用意して,コンテナ型仮想環境の検証を開始した。
開発部では,AP が出力するエラーログの情報などを,稼働環境に影響を与えないようにアプリサーバに保存する設定としていた。そこで,今回の検証における AP のエラーログなどの情報も,コンテナ内に出力する設定とした。検証のために,コンテナを起動したところ,しばらく稼働していたがその後 AP が異常終了し,コンテナが廃棄される事象が発生した。運用部が原因を調査するためにエラーログ情報の内容を確認しようとしたところ,解析に必要な情報を取得できていなかったことが判明した。そこで,a する運用方法を検討することとした。
Z 氏は,コンテナオーケストレーションツールを導入し,コンテナの運用管理を自動化することにした。Z 氏が検討したコンテナオーケストレーションツールでは,起動されているコンテナの負荷状況によって,自動的にコンテナのスケーリングが行われる。スケーリングでは,CPU 使用率が一定のしきい値を上回る又は下回る場合に,コンテナ数の増減を行う。これによって CPU 能力を最適化するとともに,CPU 能力不足によってシステムがダウンする事象の発生を防ぐ。必要となるコンテナ数は,次の計算式によって求めることができる。
                                     現在の平均 CPU 使用率
スケーリング後のコンテナ数 = 現在のコンテナ数 × ────────────
                                      期待する CPU 使用率
現在の平均 CPU 使用率は,コンテナオーケストレーションツールが定期的に自動的に測定を行う。Z 氏は,検証で最大 8 個までコンテナを稼働できる環境を用意し,現在の稼働環境の稼働状況を踏まえて,期待する CPU 使用率を 50%とした。
出題趣旨(IPA)
近年,DXを進める企業にとって,新しいITサービスを迅速に提供することが重要事項となって,コンテナ技術を導入するケースが増えている。本問では,新たにコンテナ型仮想環境を導入する事例を題材として,ITサービスマネージャとして,コンテナ型仮想環境を使うメリットやコンテナ技術の特徴を理解しているかを評価し,運用管理に必要な能力を問う。
設問と解答例
設問1(1)
20字以内
表1中の項番 1 及び項番 2 の課題に対して,コンテナ技術の導入によって試験環境が正しく整備されること以外の運用部にとっての利点は何か。20 字以内で答えよ。
解答例(2通り)
試験環境整備の作業時間を削減できる。 試験環境の整備を迅速に行える。
解説
本文の根拠
表1 項番1
運用部は手順書を用いて試験環境を開発部が指定する状態にする。運用部が試験環境を整備している期間,開発部の試験が中断する。
〔コンテナ型仮想環境の導入検討〕
試験項目に応じたコンテナをあらかじめ用意しておくことで,現在のコンテナの廃棄と用意されたコンテナの起動を行うことができるので,試験環境の整備を迅速かつ正確に行うことができる
Z氏は「迅速かつ正確に行うことができる」と2つ挙げている。設問が「試験環境が正しく整備されること以外」と断っているので,「正確に」は外れる。残るのは「迅速に」のほうである。
もう1つ条件がある。「運用部にとっての」利点である。試験の中断が減るのは開発部の利点なので,これも違う。運用部の側で何が変わるかを見る。
運用部はいま,手順書を見ながら試験環境を指定の状態に作り込んでいる。コンテナなら,用意しておいたものを起動して,今のものを廃棄するだけで済む。整備にかけていた作業時間そのものが減る。
20字。解答例は「試験環境整備の作業時間を削減できる。」で18字。
採点講評(IPA)
設問1(1)は,正答率がやや低かった。開発部にとっての利点やコンテナの特徴だけに着目して解答した受験者も多かった。コンテナの特徴だけではなく,コンテナを用いることで運用部が得られる利点に着目して解答してほしい。
設問1(2)
20字以内
本文中の下線(ア)で,インシデント発生前の状態に戻すまでの時間短縮は,コンテナ技術の特徴を生かすことによって可能となる。可能となる理由を 20 字以内で答えよ。
解答例
解説
本文の根拠
〔コンテナ技術〕
サーバのリソースを有効利用でき,環境の準備,起動,廃棄などを迅速に行うことができる。
〔コンテナ型仮想環境の導入検討〕
現在の運用では,原因を調査後,原因となった問題を除去して再度 AP の起動を行っているが,その間は 2 台のアプリサーバのうち 1 台だけしか稼働していない状態となる。
設問が「コンテナ技術の特徴を生かすことによって」と言っているので,本文が挙げた3つの特徴のどれかを選ぶ。専有して開発できる,準備・起動・廃棄が迅速,別環境への移行が簡単——時間短縮に効くのは2つ目である。
現在は,APが止まると原因を調べ,問題を取り除いてからAPを起動し直している。その間ずっと1台だけの状態が続く。
コンテナなら,止まったコンテナを廃棄して新しいコンテナを起動すればAPが動き出す。原因調査の完了を待たずに2台の状態へ戻せる。起動が速いという特徴が,そのまま復旧時間の短縮になる。
20字。解答例は「APを迅速に起動できるから」で13字。専有できる・移行が簡単といった特徴は,どちらも復旧の速さには結び付かない。
採点講評(IPA)
設問1(2)は,正答率がやや低かった。インシデント発生から復旧までの時間短縮に関連するコンテナの特徴を踏まえて解答してほしかったが,時間短縮に関連しないコンテナの特徴を解答した受験者も多かった。
設問2(1)
35字以内
表1中の項番 3 の課題に対して,ブルーグリーンデプロイメント方式を採用することのメリットを 35 字以内で答えよ。
解答例
Wサービスをほとんど止めることなくデプロイすることができる。
解説
本文の根拠
表1 項番3
稼働環境にデプロイする作業は W サービスを停止する必要があることから,W サービスの停止時間が発生し利用者に対して不便をかけている。
〔デプロイ方法の改善〕
現状の稼働環境(ブルー)とは別に,新しい稼働環境(グリーン)を構築して最新版の AP を準備しておき,デプロイする日時に合わせて,利用者が使う稼働環境を切り替える運用方法のことである。
これまでは,動いている稼働環境そのものに新しい版を入れていた。入れ替えている間はサービスを止めるしかない。表1の項番3の「Wサービスの停止時間が発生し」はここを指している。
ブルーグリーンデプロイメント方式では,新しい版をグリーン側にあらかじめ作って起動しておく。準備している間,利用者はブルーで使い続けられる。止まるのは切り替える一瞬だけである。
35字。解答例は「Wサービスをほとんど止めることなくデプロイすることができる。」で29字。「ほとんど」を落として「止めずに」と言い切ると,切り替えの瞬間があることと食い違う。
設問2(2)
30字以内
1 世代前の AP に戻すための緊急メンテナンスに対して,ブルーグリーンデプロイメント方式を採用することで復旧までの時間を削減することができる理由を 30 字以内で答えよ。
解答例
1世代前の稼働環境をコンテナとして残すことができるから
解説
本文の根拠
〔デプロイ方法の改善〕
2.0 版のコンテナの動作に問題がないことを確認できた場合
〔デプロイ方法の改善〕
1.0 版のコンテナを停止し,1.0 版のコンテナを廃棄する。
表1 項番5
1 世代前の版のゲームアプリに戻すための緊急変更が必要で
本文の手順の順番が答えになっている。1.0版のコンテナを停止して廃棄するのは「2.0版の動作に問題がないことを確認できた場合」である。裏を返せば,確認が済むまで1.0版はそのまま残っている。
だから戻すときは,残っている1.0版へ切り替えるだけでよい。バックアップから復元したり,1.0版をもう一度デプロイし直したりする必要がない。ここが時間の差になる。
30字。解答例は「1世代前の稼働環境をコンテナとして残すことができるから」で26字。「コンテナだから速い」ではなく,前の版を残したまま新しい版を用意できる,というこの方式の形を書く。
採点講評(IPA)
設問2(2)は,正答率が平均的であった。バックアップからの戻しやコンテナを再びデプロイすればよいといった,現状の稼働環境を保持したまま新たな版の稼働環境を用意できていることを意識できていない解答も散見された。ブルーグリーンデプロイメント方式の特徴に着目して解答してほしい。
設問2(3)
25字以内
本文中の下線(イ)で,図2の例において 2.0 版のコンテナの動作で問題が発生した場合,1.0 版のコンテナに戻す場合の手順を 25 字以内で答えよ。
解答例(2通り)
接続先を1.0版のコンテナに切り替える。 利用者が使う稼働環境をブルーに切り替える。
解説
本文の根拠
〔デプロイ方法の改善〕
二つの稼働環境を用意して,利用者が使う稼働環境を切り替えられるようにする。
〔デプロイ方法の改善〕
コンテナ管理ソフトウェアを使って,現在の稼働環境をブルーからグリーンに変更する。
行きの手順は「コンテナ管理ソフトウェアを使って,稼働環境をブルーからグリーンに変更する」である。戻すときはこれを逆にたどる。
1.0版のコンテナは,2.0版の動作を確認できるまで廃棄していない。だから利用者の接続先をグリーンからブルーへ,つまり1.0版のコンテナへ切り替えるだけで元に戻る。
25字。解答例は「接続先を1.0版のコンテナに切り替える。」のほか,「利用者が使う稼働環境をブルーに切り替える。」でもよい。復元やデプロイのやり直しを書くと,この方式を使う意味が無くなる。
設問3(1)
25字以内
本文中の a には,エラーログ情報の運用方法が入る。コンテナが破棄されても原因の調査ができるようにするために,どのように運用しておけばよいか。25 字以内で答えよ。
解答例
解説
本文の根拠
〔コンテナ型仮想環境の検証〕
今回の検証における AP のエラーログなどの情報も,コンテナ内に出力する設定とした。
〔コンテナ型仮想環境の検証〕
しばらく稼働していたがその後 AP が異常終了し,コンテナが廃棄される事象が発生した。
〔コンテナ型仮想環境の導入検討〕
W システムの稼働環境及び試験環境は,2 台の物理サーバ,通信装置,外部記憶装置など,W 社の設備を使って構成されている。
原因は置き場所である。エラーログをコンテナの中に出していたので,コンテナが廃棄されたときにログも一緒に消えた。
コンテナは「準備,起動,廃棄などを迅速に行う」のが持ち味で,廃棄されること自体は異常ではない。中に置いたものが残らないのは,この技術では前提として受け入れる性質である。
したがってログはコンテナの外に書き出しておく。本文に挙がっている設備のうち,コンテナが消えても残るのは外部記憶装置である。
25字。解答例は「エラーログの情報を外部記憶装置に保存」で18字。「ログを残す」だけでは,どこに残すのかが決まらない。
設問3(2)
現在のコンテナ数が 4 で,平均 CPU 使用率が 80%となり,しきい値を上回ってスケーリングが行われた場合,スケーリング後のコンテナ数を整数で答えよ。なお,計算結果で小数が発生する場合,小数を切り上げて整数で求めよ。
解答例
解説
本文の根拠
計算式
スケーリング後のコンテナ数 = 現在のコンテナ数 ×
〔コンテナ型仮想環境の検証〕
検証で最大 8 個までコンテナを稼働できる環境を用意し,現在の稼働環境の稼働状況を踏まえて,期待する CPU 使用率を 50%とした。
式に当てはめるだけである。現在のコンテナ数が4,現在の平均CPU使用率が80%,期待するCPU使用率が50%。
4 × 80 ÷ 50 = 6.4。設問の指示どおり切り上げて7個。
切り捨てて6にすると,1コンテナ当たりの負荷が 4 × 80 ÷ 6 = 53.3%となり,期待する50%に届かない。切り上げるのはこのためである。
検証環境は最大8個まで動かせるので,7個は収まる。
出典:令和6年度 春期 ITサービスマネージャ試験 午後Ⅰ 問3(表記を一部改変)
ほかの年度
令和7年度 秋期 午前Ⅱ
令和5年度 春期 午前Ⅱ
令和4年度 春期 午前Ⅱ
令和3年度 春期 午前Ⅱ
令和元年度 秋期 午前Ⅱ
平成30年度 秋期 午前Ⅱ
平成29年度 秋期 午前Ⅱ
平成28年度 秋期 午前Ⅱ
平成27年度 秋期 午前Ⅱ
平成26年度 秋期 午前Ⅱ
平成25年度 秋期 午前Ⅱ
平成24年度 秋期 午前Ⅱ
平成23年度 秋期 午前Ⅱ
平成22年度 秋期 午前Ⅱ
平成21年度 秋期 午前Ⅱ
令和6年度 春期 午前Ⅱ
令和5年度 春期 午前Ⅱ
令和4年度 春期 午前Ⅱ
令和6年度 春期 午前Ⅱ
令和5年度 春期 午前Ⅱ
令和4年度 春期 午前Ⅱ
令和6年度 春期 午前Ⅱ
令和5年度 春期 午前Ⅱ
令和4年度 春期 午前Ⅱ
令和7年度 秋期 午前Ⅱ
令和6年度 秋期 午前Ⅱ
令和5年度 秋期 午前Ⅱ
令和4年度 秋期 午前Ⅱ
令和3年度 秋期 午前Ⅱ
令和2年度 10月 午前Ⅱ
平成31年度 春期 午前Ⅱ
平成30年度 春期 午前Ⅱ
平成29年度 春期 午前Ⅱ
平成28年度 春期 午前Ⅱ
平成27年度 春期 午前Ⅱ
令和7年度 秋期 午前Ⅰ
令和7年度 春期 午前Ⅰ
令和7年度 春期 午前Ⅱ
令和7年度 春期 午後Ⅰ
令和6年度 秋期 午前Ⅰ
令和6年度 春期 午前Ⅰ
令和6年度 春期 午前Ⅱ
令和5年度 秋期 午前Ⅰ
令和5年度 春期 午前Ⅰ
令和5年度 春期 午前Ⅱ
令和5年度 春期 午後Ⅰ
令和4年度 秋期 午前Ⅰ
令和4年度 春期 午前Ⅰ
令和4年度 春期 午前Ⅱ
令和4年度 春期 午後Ⅰ
令和3年度 秋期 午前Ⅰ
令和3年度 春期 午前Ⅰ
令和3年度 春期 午前Ⅱ
令和3年度 春期 午後Ⅰ
令和2年度 10月 午前Ⅰ
令和元年度 秋期 午前Ⅰ
令和元年度 秋期 午前Ⅱ
令和元年度 秋期 午後Ⅰ
平成31年度 春期 午前Ⅰ
平成30年度 秋期 午前Ⅰ
平成30年度 秋期 午前Ⅱ
平成30年度 秋期 午後Ⅰ
平成30年度 春期 午前Ⅰ
平成29年度 秋期 午前Ⅰ
平成29年度 秋期 午前Ⅱ
平成29年度 秋期 午後Ⅰ
平成29年度 春期 午前Ⅰ
平成28年度 秋期 午前Ⅰ
平成28年度 秋期 午前Ⅱ
平成28年度 秋期 午後Ⅰ
平成28年度 春期 午前Ⅰ
平成27年度 秋期 午前Ⅰ
平成27年度 春期 午前Ⅰ
平成27年度 秋期 午前Ⅱ
平成27年度 秋期 午後Ⅰ
平成26年度 秋期 午前Ⅰ
平成26年度 秋期 午後Ⅰ
平成26年度 春期 午前Ⅰ
平成25年度 秋期 午前Ⅰ
平成25年度 秋期 午後Ⅰ
平成25年度 春期 午前Ⅰ
平成24年度 秋期 午前Ⅰ
平成24年度 秋期 午後Ⅰ
平成24年度 春期 午前Ⅰ
平成23年度 秋期 午前Ⅰ
平成23年度 秋期 午後Ⅰ
平成23年度 特別試験 午前Ⅰ
平成22年度 秋期 午前Ⅰ
平成22年度 秋期 午後Ⅰ
平成22年度 春期 午前Ⅰ
平成21年度 秋期 午前Ⅰ
平成21年度 秋期 午後Ⅰ
平成26年度 秋期 午前Ⅱ
平成25年度 秋期 午前Ⅱ
平成24年度 秋期 午前Ⅱ
平成23年度 秋期 午前Ⅱ
平成22年度 秋期 午前Ⅱ
平成21年度 秋期 午前Ⅱ
平成21年度 春期 午前Ⅰ