平成28年度 秋期に実施されたITサービスマネージャ試験
午後Ⅰの全3問(記述式)です。事例本文・設問・解答例と解説をそのまま読めます。
この年度を解いてみる
問1 サービス継続及び可用性管理
サービス継続及び可用性管理に関する次の記述を読んで,設問1〜3に答えよ。
R 社は,中堅の製薬会社である。R 社の本社は関東地方の C 市にあり,工場,関東支店及びサーバ室(全て同じ建物内にある)は C 市に隣接する D 市に,近畿支店は近畿地方の E 市にある。両支店には倉庫が併設されており,関東支店は東日本地域の注文受付と入出庫,近畿支店は西日本地域の注文受付と入出庫を担当している。
R 社の製造部の部員は,工場に勤務して製品の製造記録及び倉庫への輸送記録を端末から生産管理システムに入力している。R 社の販売部の部員は,関東支店又は近畿支店に勤務して注文の入力を行っている。顧客からの注文は,両支店で毎日 8 時から 19 時までの間,電話又はファックスで受け付け,端末から販売管理システムに入力している。また,端末から製品の入出庫を販売管理システムに入力している。
〔システム全体の構成〕
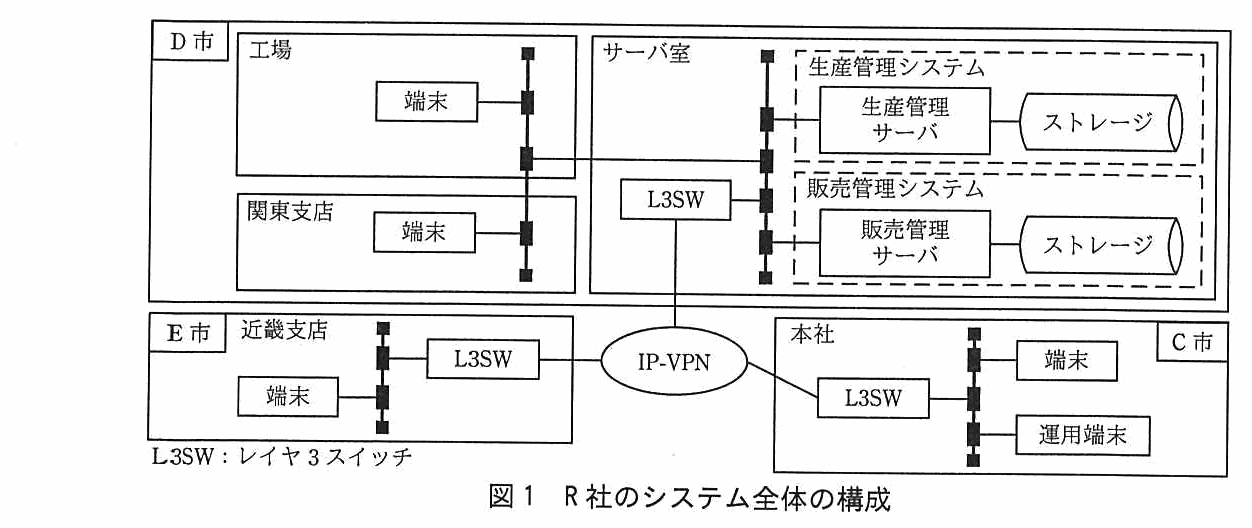
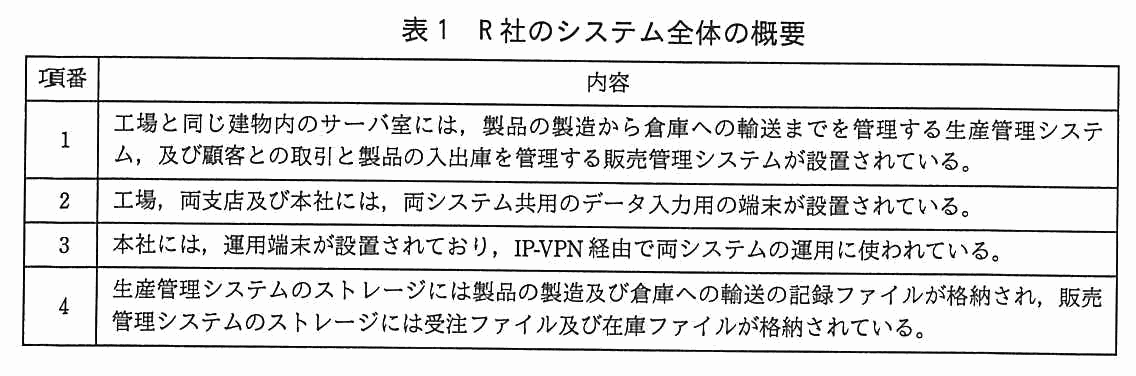
R 社のシステム全体の構成を図1に,システム全体の概要を表1に示す。
図1 R 社のシステム全体の構成
表1 R 社のシステム全体の概要
〔両システムの運用〕
R 社の情報システム部員は,本社に勤務して両システムを運用している。両システムとも,毎日 4 時から 23 時までオンライン処理を行う。23 時から 24 時までは,テープ媒体にファイルのフルバックアップを取得し,サーバ室に保管している。
システムのオペレーションは,販売管理システム専任の A チームと,生産管理システム専任の B チームの 2 チームに分かれている。部員は自身が担当するシステムについて教育を受け,オペレーションを実施している。
なお,部員は自身が担当するシステム以外のオペレーションは実施していない。両チームともシフト体制を組み,それぞれ 1 シフト 1 名でオペレーションを実施している。
〔事業継続計画の策定〕
関東地方に震度 6 弱レベルの地震が発生した場合の,R 社の建物が損傷を受けるリスクについて調査した。その結果は次のとおりである。
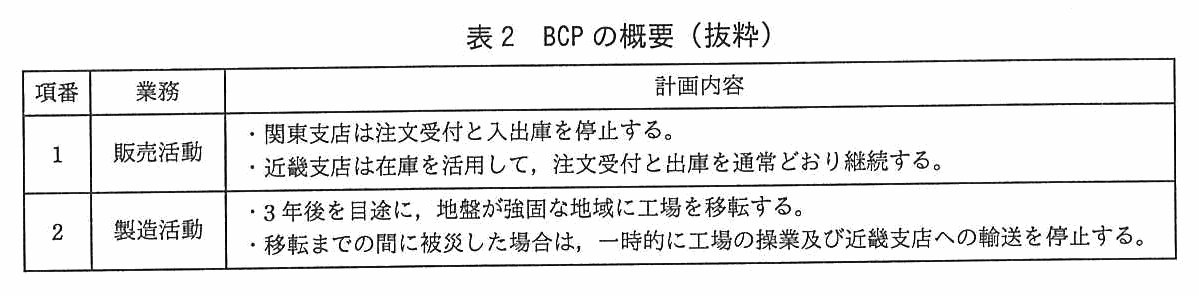
C 市にある本社の建物は耐震性能が高く,震度 6 弱レベルの地震で損傷を受ける確率が低い。 D 市にある R 社の敷地の地盤は軟弱であって,R 社の建物(工場,関東支店,倉庫及びサーバ室)は,震度 6 弱レベルの地震で損傷を受ける確率が高い。 E 市にある近畿支店の建物及び倉庫は,損傷を受ける確率が低い。 この調査結果を受け,R 社では情報システム部も参加する検討チームを設置して,事業継続計画(以下,BCP という)の策定に着手した。BCP の概要を表2に示す。
表2 BCP の概要(抜粋)
〔災害対策用システムの検討〕
工場,関東支店及びサーバ室の建物の被災によって両システムが停止することが想定された。一方で,近畿支店の販売活動は可能なので,販売管理システムの RTO(目標復旧時間)は被災時点から 120 分,生産管理システムの RTO は被災時点から 5 日と設定した。ただし,RPO(目標復旧時点)は関係部署との調整が必要なので,継続して検討することになった。
RTO の設定を受け,IT サービスマネージャである G 氏は,被災時の技術的対策の検討を始めた。検討した結果,現在稼働中の販売管理システムと同一機能で,被災時だけ使用する災害対策用システム(以下,災対システムという)を構築することになった。概要は次のとおりである。
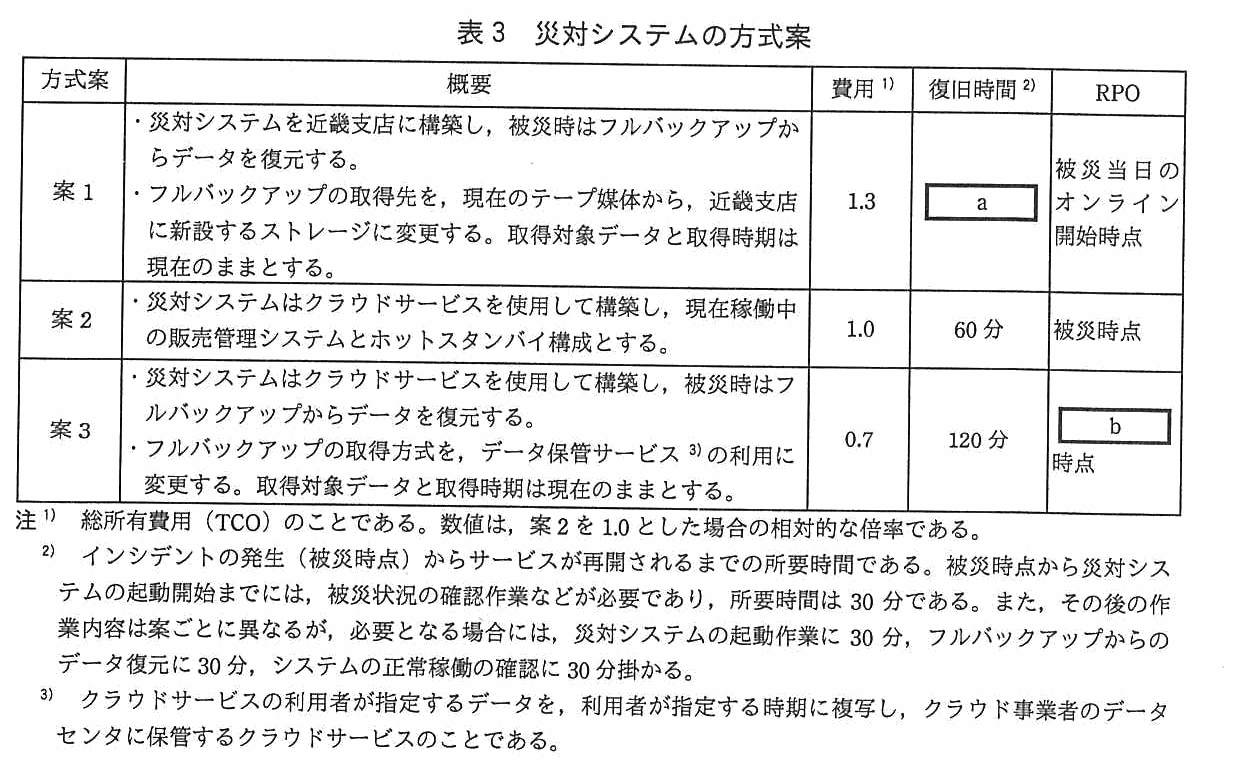
災対システムと本社との間に専用線を新規に敷設し,本社の運用端末から遠隔操作を行う。 クラウドサービスの活用も検討する。現在稼働中の販売管理システムとの互換性を考慮し,クラウド事業者が提供する PaaS を利用する。PaaS は,サービスの利用量に応じた料金体系であり,システム環境の構築だけであれば少額の費用で利用できる。 G 氏はこれらの検討結果を踏まえ,災対システムの方式案を表3のようにまとめた。
表3 災対システムの方式案
案 1 で,RPO を被災当日のオンライン開始時点と設定した場合,(ア)情報システム部が販売部とあらかじめ合意すべき内容がある 。
G 氏は,案 1〜3 について検討した結果,案 3 を推奨案として検討チームに提案し,案 3 に決定した。
〔復旧手順の検討及びクラウドサービスの選定〕
案 3 の決定を受けて,G 氏は,販売管理システムの復旧手順の検討と,使用するクラウドサービスの選定に着手した。
(1) 復旧手順の検討
災対システムは,平常時は停止状態としておき,被災時に運用端末から起動する。被災状況の確認作業などに 30 分,その後,災対システムの起動作業に 30 分,さらに,フルバックアップからのデータ復元に 30 分掛かる。データ復元の完了後,システムの正常稼働の確認に 30 分掛かるが,RTO 内に復旧できる。 ストレージは,平常時は最低限の容量だけを確保しておき,被災時点のデータ量に応じて,災対システムの起動作業と並行して容量の追加を行う。 (2) 災対システム稼働中にインシデントが発生した場合の対応
災対システム稼働中にインシデントが発生し,災対システムが停止した場合,クラウド事業者がインシデントの解決及び災対システムの起動を実施する。その後,R 社でフルバックアップからのデータ復元及びシステムの正常稼働の確認を実施し,サービスを再開する。
(3) クラウドサービスの選定
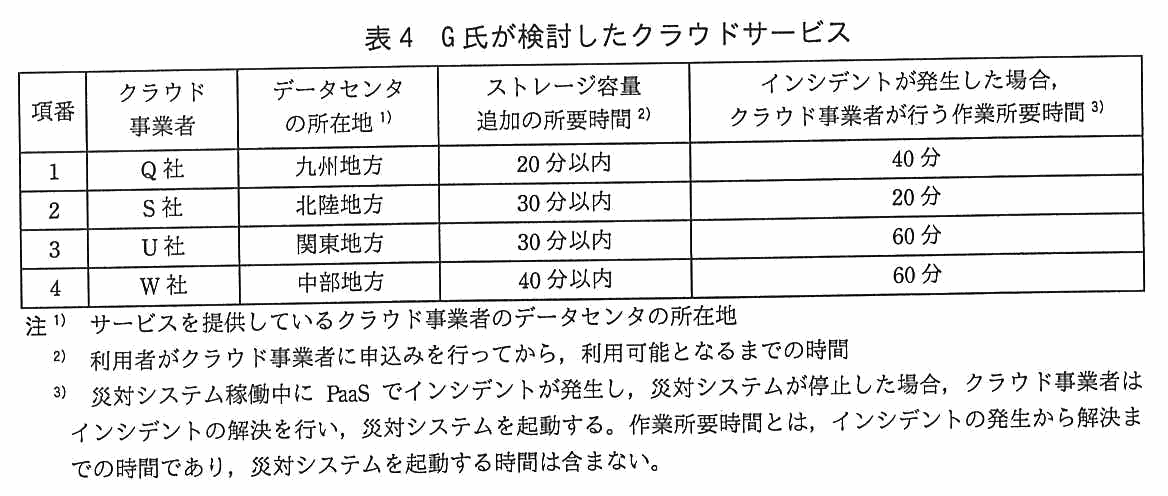
G 氏は,災対システムの候補として,表4の 4 社のクラウドサービスを選んだ。
表4 G 氏が検討したクラウドサービス
G 氏は,各社のサービスを比較し,次の条件に合致するクラウドサービスを提供する 1 社を選定した。
事業継続に関する要求事項として,サービスを提供するデータセンタが,R 社のサーバ室と同じ地方にないこと 災対システム稼働中にインシデントが発生し,災対システムが停止した場合,インシデントの発生から 120 分以内にサービスが再開可能なこと c 〔災対システムの構築〕
G 氏は変更計画として,災対システムの構築計画,災対システムに関連する既存システムの稼働環境の修正計画,及び既存システムのオペレーションマニュアルの修正計画をまとめた。変更計画は R 社で規定する変更管理プロセスに従って承認され,災対システムが構築された。災対システムの構築が完了した後,G 氏は災害対策用マニュアル(以下,災対マニュアルという)も作成した。
当初,災対システムと本社との間は,1 本の専用線で接続する予定であった。しかし,災対システムの構築完了後,G 氏は予備の専用線を追加して,可用性を向上させることにした。この場合,災対システムの正常稼働の確認で予備の専用線の切替え作業と疎通確認作業が増えるが,想定している 30 分の範囲内で作業可能と判断した。予備の専用線の追加は,変更管理プロセスに従って承認された後,予備の専用線の敷設作業が実施された。
〔災害復旧訓練の準備・実施〕
災対システムの構築完了後,G 氏は災害復旧訓練(以下,訓練という)の実施を計画した。訓練には,実施日時に勤務中の販売管理システム専任の A チームのオペレータと運用責任者が参加し,実機を使用して災対システムへの切替えなどを行う。
G 氏は訓練の計画書を作成し,参加者向け会議で訓練計画及び災対マニュアルについて説明を行った。会議において,“被災時には,勤務中の A チームのオペレータが何らかの理由で作業を行えなくなり,非番のオペレータも招集できないという不測の事態も考えられる。RTO 内に復旧するために,こうしたリスクへの備えも必要である。”という指摘を受け,G 氏は (イ)対策を検討した 。
訓練は予定した日時に実施された。訓練終了後,訓練実施者の会議において,“(ウ)災対マニュアルの復旧手順では,予備の専用線の疎通確認が漏れていた ので,作業に手間取ってしまった。”という報告があった。
出題趣旨(IPA)
事業継続計画(BCP)への社会的ニーズが高まる中,ITサービスマネージャには,BCPに基づいてサービス継続計画を作成し,管理していくことが求められている。本問では,クラウドサービスを利用した災害対策用システムの検討,及び復旧訓練の実施を題材に,サービス継続計画を作成し,管理する能力,サービス継続計画を試験する能力,及び変更管理プロセスを使って計画を変更する能力を問う。
設問と解答例
設問1(1)
解答欄2つ
表 3 中の a に入れる適切な字句を 5 字以内で,b に入れる適切な字句を 15 字以内で,それぞれ答えよ。
解説
本文の根拠
表3 注2
被災時点から災対システムの起動開始までには,被災状況の確認作業などが必要であり,所要時間は 30 分である。また,その後の作業内容は案ごとに異なるが,必要となる場合には,災対システムの起動作業に 30 分,フルバックアップからのデータ復元に 30 分,システムの正常稼働の確認に 30 分掛かる。
〔両システムの運用〕
両システムとも,毎日 4 時から 23 時までオンライン処理を行う。23 時から 24 時までは,テープ媒体にファイルのフルバックアップを取得し,サーバ室に保管している。
表3 案3
案3:災対システムはクラウドサービスを使用して構築し,被災時はフルバックアップからデータを復元する。フルバックアップの取得方式を,データ保管サービスの利用に変更する。取得対象データと取得時期は現在のままとする。
空欄a。案1で必要な作業を注2から拾って足す。被災状況の確認30分,災対システムの起動30分,フルバックアップからのデータ復元30分,正常稼働の確認30分で合計120分。
案2で検算できる。案2はホットスタンバイ構成なので,起動もデータ復元も要らない。確認30分+正常稼働の確認30分で60分となり,表3の値と一致する。案3も案1と同じ4つの作業を行うので120分で,これも表と合う。
空欄b。案3は「取得対象データと取得時期は現在のままとする」と断っている。現在のフルバックアップは23時から24時に取っている。オンライン処理は4時から23時なので,このバックアップはその日のオンラインが終わった状態である。
24時から翌4時までは何も動かないから,前日のバックアップは翌日(被災当日)のオンラインが始まる直前の状態と同じになる。案1のRPOが「被災当日のオンライン開始時点」と書かれているのと同じ理屈で,案3も同じ時点になる。
設問1(2)
40字以内
本文中の下線(ア)について,合意すべき内容を 40 字以内で述べよ。
解答例
被災日に入力済みのデータを,システム復旧後に再入力する必要があること
解説
本文の根拠
表3 案1
費用 1.3,復旧時間 a ,RPO は被災当日のオンライン開始時点。
冒頭
顧客からの注文は,両支店で毎日 8 時から 19 時までの間,電話又はファックスで受け付け,端末から販売管理システムに入力している。
表2 BCP
項番1(販売活動):関東支店は注文受付と入出庫を停止する。近畿支店は在庫を活用して,注文受付と出庫を通常どおり継続する。
RPOが被災当日のオンライン開始時点ということは,その日に入力した分は戻ってこないということである。
注文の受付は8時から19時まで行っている。オンラインは4時に始まるので,被災が8時以降なら,その日に入れた注文はすべて失われる。しかもBCPでは近畿支店が注文受付を通常どおり続けるので,データが欠けたまま業務が進む。
これは技術で埋められる欠落ではない。入力した本人たち,つまり販売部が入れ直すしかない。その作業が発生することを,案を決める前に販売部と合意しておく必要がある。合意なしに案1を選ぶと,被災時に「誰が入れ直すのか」で止まる。
40字。解答例は「被災日に入力済みのデータを,システム復旧後に再入力する必要があること」で33字。
設問2(1)
40字以内
本文中の c には,ストレージに関する条件が入る。適切な条件を,40 字以内で具体的に述べよ。
解答例
ストレージ容量の追加作業が,災対システムの起動作業完了までに終わること
解説
本文の根拠
〔復旧手順の検討及びクラウドサービスの選定〕
ストレージは,平常時は最低限の容量だけを確保しておき,被災時点のデータ量に応じて,災対システムの起動作業と並行して容量の追加を行う。
〔復旧手順の検討及びクラウドサービスの選定〕
被災状況の確認作業などに 30 分,その後,災対システムの起動作業に 30 分,さらに,フルバックアップからのデータ復元に 30 分掛かる。
表4
項番4 W 社:中部地方,40 分以内,60 分。
容量の追加は「災対システムの起動作業と並行して」行う,と決まっている。起動作業は30分なので,追加に使える時間も30分である。
この30分を超えると何が困るか。次の工程はフルバックアップからのデータ復元で,入れ物が広がっていなければ始められない。つまり復旧時間120分が守れなくなる。
したがって条件は,ストレージ容量の追加が災対システムの起動作業の完了までに終わること。表4ではW社だけが40分以内で,この条件から外れる。
40字。解答例は「ストレージ容量の追加作業が,災対システムの起動作業完了までに終わること」で34字。
「短時間で追加できること」では基準がない。並行して行える時間が30分だ,という前提から具体的な線を引く。
採点講評(IPA)
設問2(1)はストレージの追加作業が可能な時間帯を誤って認識している解答も見受けられた。問題文を落ち着いて読み,作業の前提条件を正しく把握してほしかった。
設問2(2)
表 4 のクラウド事業者のうち,G 氏が選定した 1 社を答えよ。
解答例
解説
本文の根拠
〔復旧手順の検討及びクラウドサービスの選定〕
事業継続に関する要求事項として,サービスを提供するデータセンタが,R 社のサーバ室と同じ地方にないこと
〔復旧手順の検討及びクラウドサービスの選定〕
災対システム稼働中にインシデントが発生し,災対システムが停止した場合,クラウド事業者がインシデントの解決及び災対システムの起動を実施する。その後,R 社でフルバックアップからのデータ復元及びシステムの正常稼働の確認を実施し,サービスを再開する。
表4 注3
作業所要時間とは,インシデントの発生から解決までの時間であり,災対システムを起動する時間は含まない。
3つの条件で順にふるいにかける。
1つ目は所在地。R社のサーバ室はD市,つまり関東地方にある。同じ関東地方のU社が落ちる。
2つ目はインシデント発生から120分以内の再開。内訳を積む。クラウド事業者の作業所要時間(注3のとおり起動は含まない)に,災対システムの起動30分,データ復元30分,正常稼働の確認30分が続く。後ろの3つで90分使うので,事業者の作業所要時間は30分以内でなければならない。Q社40分,U社60分,W社60分が落ち,残るのはS社の20分だけである。
3つ目は空欄cのストレージ条件で,容量追加は30分以内。W社の40分が落ちる。
3つすべてを満たすのはS社である。
注3を読み飛ばして起動時間を作業所要時間に含めてしまうと,2つ目の線引きが狂う。表の注記まで読むこと。
設問3(1)
50字以内
本文中の下線(イ)について,有効な対策を 50 字以内で述べよ。
解答例
Bチームのオペレータを販売管理システムのオペレーションもできるように教育する。
解説
本文の根拠
〔両システムの運用〕
システムのオペレーションは,販売管理システム専任の A チームと,生産管理システム専任の B チームの 2 チームに分かれている。部員は自身が担当するシステムについて教育を受け,オペレーションを実施している。
〔両システムの運用〕
部員は自身が担当するシステム以外のオペレーションは実施していない。
〔災害対策用システムの検討〕
販売管理システムの RTO(目標復旧時間)は被災時点から 120 分,生産管理システムの RTO は被災時点から 5 日と設定した。
指摘されたのは,Aチームが動けず非番も呼べない場合である。現場にBチームの部員はいるが,販売管理システムの教育を受けていないので操作できない。人がいないのではなく,できる人がいないという状態である。
そこでBチームにも販売管理システムのオペレーションを教育しておく。被災時,生産管理システムのRTOは5日と長いので,Bチームは当面そちらに追われない。手を貸せる余地がある。
50字。解答例は「Bチームのオペレータを販売管理システムのオペレーションもできるように教育する。」で38字。
Bチームを訓練に参加させる,とだけ書くと足りない。教育を受けていない者が訓練に出ても操作はできないので,教育まで遡って書く。
採点講評(IPA)
設問3(1)は,BチームをAチームとともに災害復旧訓練に参加させるとだけ述べた解答が散見された。ここでは,問題文にあるシステムの運用実態を踏まえ,訓練参加の前提として必要となる運用要員の教育まで遡って考察してほしかった。
設問3(2)
40字以内
本文中の下線(ウ)について,サービスマネジメントの観点から,改善すべき内容を 40 字以内で述べよ。
解答例
災対マニュアルをサービスの構成品目として認識し,変更計画の対象とする。
解説
本文の根拠
〔災対システムの構築〕
G 氏は変更計画として,災対システムの構築計画,災対システムに関連する既存システムの稼働環境の修正計画,及び既存システムのオペレーションマニュアルの修正計画をまとめた。
〔災対システムの構築〕
災対システムの構築が完了した後,G 氏は災害対策用マニュアル(以下,災対マニュアルという)も作成した。
〔災対システムの構築〕
予備の専用線の追加は,変更管理プロセスに従って承認された後,予備の専用線の敷設作業が実施された。
なぜ漏れたのかを時系列で追う。変更計画に入っていた修正対象は「既存システムのオペレーションマニュアル」で,災対マニュアルはその後に作られた。最初から変更計画の枠の外にある。
予備の専用線を追加したときも,変更管理プロセスは通っている。それでも災対マニュアルは修正対象に挙がらなかった。個人が書き忘れたのではなく,仕組みの側で拾われないようになっている。
拾われるようにするには,災対マニュアルを構成品目として管理すればよい。構成品目であれば,変更のたびに影響を受けるものとして洗い出され,修正が変更計画に含まれる。
40字。解答例は「災対マニュアルをサービスの構成品目として認識し,変更計画の対象とする。」で34字。「マニュアルを更新する」で止めると,今回の漏れは直っても次の変更でまた漏れる。
採点講評(IPA)
設問3(2)は,正答率が低かった。サービス継続の手順となる災害対策用マニュアルを更新するための変更要求を,変更管理プロセスに提供することに気付いてほしかった。
出典:平成28年度 秋期 ITサービスマネージャ試験 午後Ⅰ 問1(表記を一部改変)
問2 キャパシティ管理
キャパシティ管理に関する次の記述を読んで,設問1〜3に答えよ。
F 社は,通信事業者である。F 社の情報システム部門では,F 社の顧客が利用するインターネット受付サービス,代理店が利用する代理店サービス,及び社員が利用する顧客管理サービスを運用している。これらのサービスは F 社の営業部門が統括している。
〔サービスの概要〕
インターネット受付サービス及び代理店サービスは,オンライン処理形態で提供されている。インターネット受付サービスはインターネット受付システムで,代理店サービスは代理店システムで処理されている。インターネット受付サービスのサービス提供時間帯は 24 時間 365 日で,代理店サービスは平日の 8〜21 時である。
顧客管理サービスは,契約管理,課金管理,問合せ管理,請求・入金,受注分析の五つのサービスで構成され,顧客管理システムで処理されている。
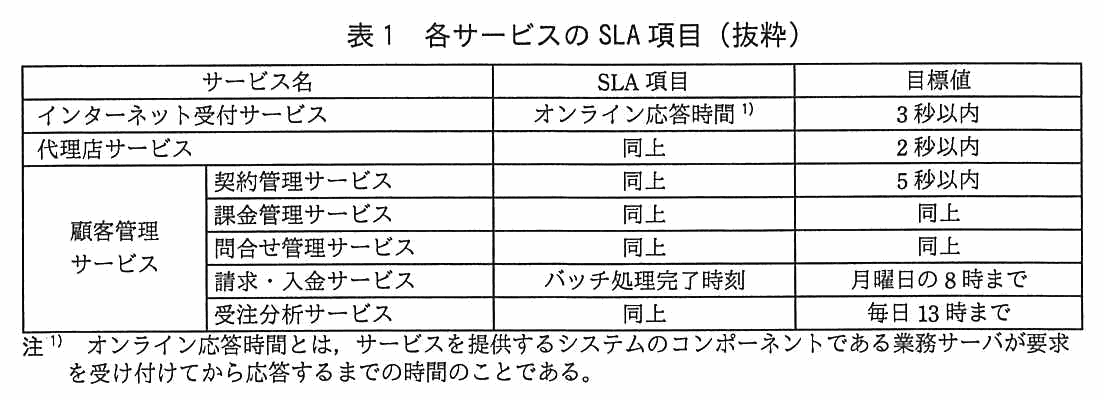
契約管理サービス,課金管理サービス及び問合せ管理サービスは,オンラインでサービスを行っている。サービス提供時間帯は,平日の 8〜21 時である。 請求・入金サービスは毎週 1 回提供されるサービスである。毎週日曜日の 22 時に起動する顧客管理システムのバッチ処理として運用されている。 受注分析サービスは毎日 1 回提供されるサービスである。請求・入金サービスのバッチ処理との競合を避けるために 9 時以降に処理を開始する必要があり,毎日 9 時に起動する顧客管理システムのバッチ処理として運用されている。 各サービスの SLA 項目(抜粋)を,表1に示す。
表1 各サービスの SLA 項目(抜粋)
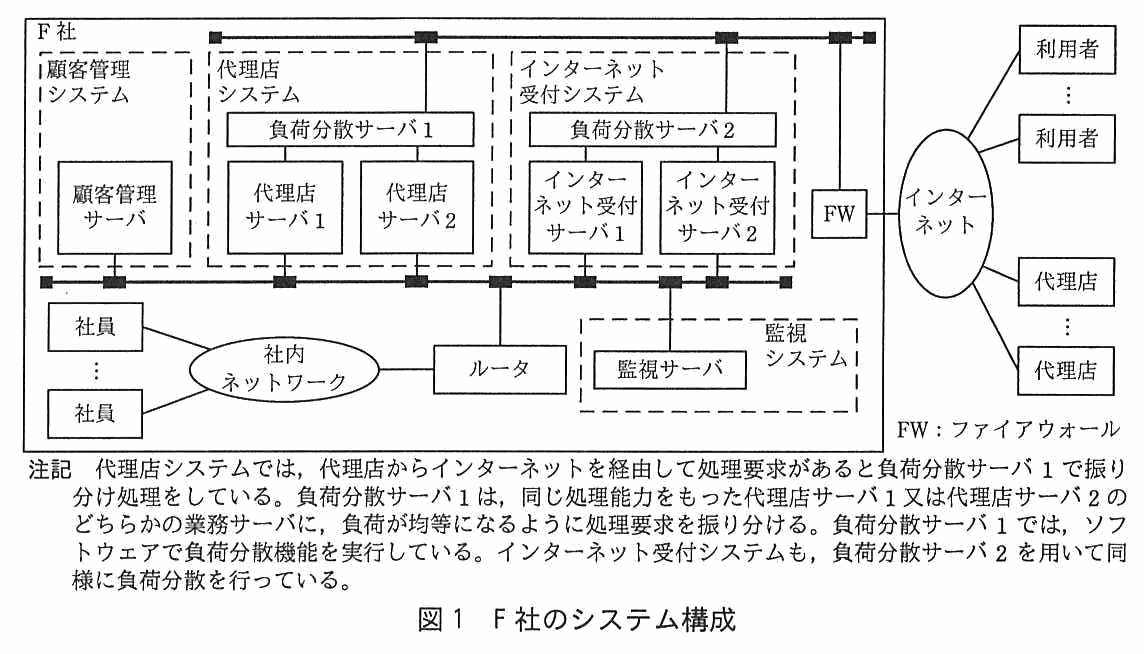
F 社のシステム構成を図1に示す。
図1 F 社のシステム構成
なお,受注分析サービスは,F 社でサービス提供を開始した当初は,1 時間で処理を完了していたが,処理対象データの増加に伴って処理時間が長くなり,現在では処理完了までに 1 時間 30 分掛かっている。
〔キャパシティ計画の策定〕
情報システム部門の L 氏は,IT サービスマネージャとしてキャパシティ管理を担当している。L 氏は,F 社の規程に従ってキャパシティ計画を次のとおり策定した。
営業部門から入手した,現在及び将来のサービスに対する需要とサービス利用者の見通しから,データ処理量の増加を見積もる。 営業部門と合意したオンライン応答時間などの要求事項,データ処理量を基に,ハードウェア,ソフトウェアなどのコンポーネントのキャパシティ及び構成を計画する。 コンポーネントのキャパシティを増強するための方式及び構成を計画する。 なお,F 社の規程では,サービス開始後は,実際のオンライン応答時間,キャパシティのニーズなどに基づいて,“毎年,キャパシティ計画を変更する”としている。
〔サービス運用段階のキャパシティ管理〕
L 氏は,サービス運用段階のキャパシティ管理として次の活動を実施している。
(1) キャパシティ監視
① サービスがオンライン処理形態の場合は,サーバの CPU 使用率,サーバの処理件数及びオンライン応答時間を監視項目とする。これらの監視項目は,監視システムによって 1 分間隔で測定し,監視データとして収集される。一方,サービスがバッチ処理形態の場合は,サーバの CPU 使用率及びバッチ処理完了時刻を監視項目とする。
なお,LAN 及び社内ネットワークには十分なキャパシティがあり,サービス提供に支障がないので,監視項目を設定していない。
② オンライン応答時間の測定値が,あらかじめ決められたしきい値を超えた場合は,監視システムがインシデントとして検知する。しきい値には,各サービスの SLA 項目の目標値を設定しており,キャパシティに関わるインシデントが発生した場合は,直ちに監視システムから L 氏に通知される。
(2) 分析及び対策
① 監視システムによって収集した監視データについて,各サービスの SLA 項目の目標値の達成に影響を与える可能性がないか,キャパシティ計画どおりにコンポーネントのキャパシティが使われているかなどの視点で分析する。
② キャパシティ不足が懸念される場合には,キャパシティの増強計画を作成する。キャパシティの増強は,サービス提供時間以外の計画停止時間帯に実施する。
〔顧客管理サービスのインシデントとその対策〕
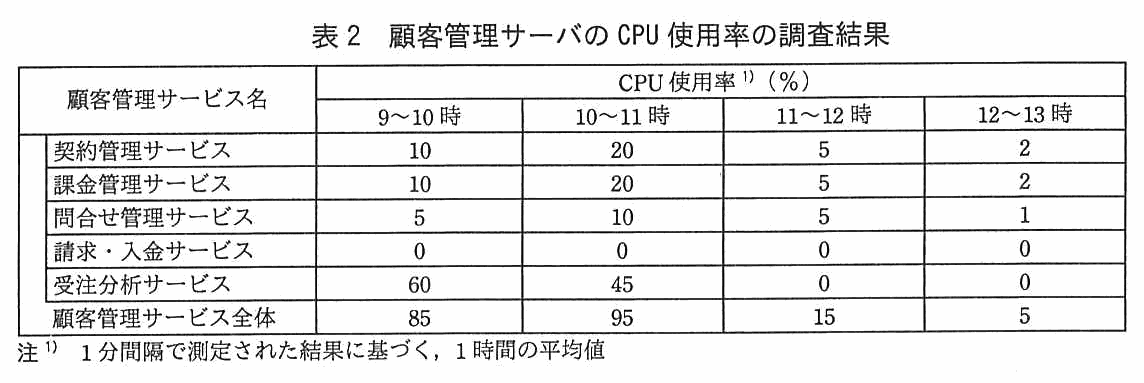
ある月曜日の 10 時に,顧客管理サービスにおいてオンライン応答時間がしきい値を超えるというインシデントが発生し,監視システムから L 氏に通知があった。その後,11 時までの間に同一インシデントが数回発生した。また,営業部門からサービスデスクに,“サービスの応答が遅くなっている”とのクレームが寄せられた。L 氏が監視データを調査したところ,10〜11 時の時間帯で顧客管理サーバの CPU 使用率が 90〜100%で推移していたことが判明した。その調査結果を表2に示す。
表2 顧客管理サーバの CPU 使用率の調査結果
顧客管理サーバの利用状況を調査したところ,1 日のオンライン処理件数のうち約 2 割が 10〜11 時のピーク時間帯に集中していた。L 氏は,根本対策として,顧客管理サーバのキャパシティの増強が必要と判断した。しかし,増強には時間が掛かるので,暫定対策を策定し,営業部門と協議することにした。
〔代理店サービスのオンライン応答時間の悪化〕
ある日の 22 時に,負荷分散サーバ 1 の機器障害が発生した。機器障害の発生時刻はサービス提供時間帯ではなかったので,サービス利用者に影響しなかったが,翌日のサービス提供開始までには回復する必要があった。情報システム部門でサーバ運用を担当している T 氏は,負荷分散サーバ 1 の交換作業が必要と判断し,次の手順で対応した。
変更管理プロセスに従って,緊急変更の作業計画を策定し,実施の許可を得た。 翌日の 6 時から,負荷分散サーバのメーカ作業員とともに変更作業を実施した。 変更作業の最後の作業項目として,代理店システムの機能の確認作業を行った。この作業で代理店サービスが利用できることを確認して,8 時までに作業を終了した。 代理店サービスは,予定どおり 8 時に開始されたが,9〜10 時のピーク時間帯に代理店からサービスデスクに“サービスの応答が遅くなっている”というクレームが多数寄せられた。サービスデスクから調査を依頼された L 氏は,今回の緊急変更作業が影響したと判断し,T 氏に調査を依頼した。
しばらくして,T 氏から,“緊急変更作業で,負荷分散機能を実行するソフトウェアの負荷分散先サーバの登録を誤り,代理店サーバ 1 に処理が集中してボトルネックとなってしまった。直ちに,設定を修正する。”という回答があった。
〔キャパシティ計画の変更〕
インターネット受付サービスは,サービスを開始してから 1 年が経過し,F 社では,キャパシティ計画を変更することになった。そこで,L 氏はインターネット受付サービスの現状を次のとおり整理した。
オンライン応答時間は,SLA 項目の目標値は達成しているが,サービス開始時に比べて悪化している。 インターネット受付システムは Web 型のシステムであって,主にサーバの処理能力がパフォーマンスに影響を与える。 オンライン応答時間の SLA 項目の目標値を達成するために,将来の需要の予測が必要である。 そこで,L 氏は,まず,(ア)サービスの需要と達成されているパフォーマンスの状況を調査する ことにした。
出題趣旨(IPA)
キャパシティ管理では,サービスの要求事項に従い,サービスのパフォーマンスを適正な容量・能力で提供する。本問では,変動するサービスの利用量に起因するキャパシティの不足によるインシデントを防止し,SLAの目標値を達成する活動,及び将来の需要に対応してキャパシティ計画を変更する活動に関して,ITサービスマネージャに要求されるキャパシティ管理の能力を問う。
設問と解答例
設問1(1)
40字以内
キャパシティ監視でインシデントと認識するためのしきい値には問題があり,変更が必要である。しきい値の変更内容を,SLA との関連性を含めて 40 字以内で述べよ。
解答例
SLA違反となる前に対策がとれるよう,しきい値を目標値より下に設定する。
解説
本文の根拠
〔サービス運用段階のキャパシティ管理〕
オンライン応答時間の測定値が,あらかじめ決められたしきい値を超えた場合は,監視システムがインシデントとして検知する。しきい値には,各サービスの SLA 項目の目標値を設定しており
表1
顧客管理サービスの契約管理サービス:同上,5 秒以内。
しきい値にSLAの目標値をそのまま置いている,というのが問題の所在である。
この置き方だと,しきい値を超えたときにはもうSLAを割っている。検知は「これから危ない」ではなく「すでに違反した」の合図になってしまう。実際,今回も通知を受けてから調査を始め,その間に営業部門からクレームが届いた。
しきい値を目標値より低い値にしておけば,違反する前に気づいて手を打てる。監視の目的は,違反を記録することではなく違反を防ぐことである。
40字。解答例は「SLA違反となる前に対策がとれるよう,しきい値を目標値より下に設定する。」で35字。設問が「SLAとの関連性を含めて」と言っているので,目標値との上下関係を書く。
採点講評(IPA)
設問1(1)は,オンライン応答時間の悪化を検知する監視項目を誤った解答が多かった。しきい値にSLA項目の目標値を設定していることの問題点を的確に指摘してほしかった。
設問1(2)
35字以内
サービスの応答が遅くなっていることへの対策として,営業部門と協議して実施する暫定対策を 35 字以内で述べよ。
解答例
受注分析サービスのバッチ処理開始時刻を11時に変更する。
解説
本文の根拠
〔サービスの概要〕
受注分析サービスは毎日 1 回提供されるサービスである。請求・入金サービスのバッチ処理との競合を避けるために 9 時以降に処理を開始する必要があり,毎日 9 時に起動する顧客管理システムのバッチ処理として運用されている。
表1
顧客管理サービスの受注分析サービス:同上,毎日 13 時まで。
〔サービスの概要〕
現在では処理完了までに 1 時間 30 分掛かっている。
表2
受注分析サービス:60,45,0,0。
表2の内訳を見ると,10〜11時の95%のうち45%が受注分析サービスである。オンラインの3サービスを合わせても50%しかない。重いのはバッチのほうである。
受注分析はバッチ処理なので,動かす時刻を選べる。制約は3つ。9時以降に開始すること,13時までに完了すること,処理に1時間30分かかること。
11時開始なら12時30分に終わり,13時に間に合う。しかも表2のとおり11〜12時のオンラインは15%,12〜13時は5%と空いている。ピークを外して空いている時間帯へ移せる。
35字。解答例は「受注分析サービスのバッチ処理開始時刻を11時に変更する。」で27字。
12時開始では13時30分になって完了時刻を守れない。9時より前に動かすのも,請求・入金サービスとぶつかるので不可。動かせる幅は9時から11時30分の間しかない。
設問1(3)
40字以内
(2)の暫定対策が有効であると考えた理由を,40 字以内で述べよ。
解答例
オンライン処理のピーク時間帯のCPU負荷を分散させることができるから
解説
本文の根拠
表2
顧客管理サービス全体:85,95,15,5。
〔顧客管理サービスのインシデントとその対策〕
顧客管理サーバの利用状況を調査したところ,1 日のオンライン処理件数のうち約 2 割が 10〜11 時のピーク時間帯に集中していた。
10〜11時はオンライン処理が1日の約2割集中するピークである。そこへ受注分析の45%が重なって,全体が95%まで上がっていた。CPUが飽和すれば応答時間は伸びる。
受注分析を11時以降へ動かすと,ピーク時間帯からバッチの負荷が丸ごと抜ける。オンラインの3サービスだけなら50%程度で,余裕ができる。一方の11〜12時はもともと15%なので,そこへ受注分析が入っても収まる。
つまりサーバを増やさずに,負荷の山を時間軸でならすことができる。増強には時間が掛かるので,それまでのつなぎとして有効である。
40字。解答例は「オンライン処理のピーク時間帯のCPU負荷を分散させることができるから」で32字。
採点講評(IPA)
設問1(3)は,正答率が高かった。応答時間の性能を維持するために,現状与えられたキャパシティ制約の中で対応できる方法を見いだすことは実施できるようだった。
設問2
60字以内
〔代理店サービスのオンライン応答時間の悪化〕について,L 氏は,緊急変更作業の終了後に,サービス提供開始から数分間の監視データを分析しておくべきであった。キャパシティ管理担当として,監視データを分析し,確認すべきであった内容を 60 字以内で述べよ。
解答例
代理店サーバ1と代理店サーバ2が有効に稼働していることを,それぞれのサーバのCPU使用率から確認する。
解説
本文の根拠
図1 注記
負荷分散サーバ 1 は,同じ処理能力をもった代理店サーバ 1 又は代理店サーバ 2 のどちらかの業務サーバに,負荷が均等になるように処理要求を振り分ける。
〔代理店サービスのオンライン応答時間の悪化〕
変更作業の最後の作業項目として,代理店システムの機能の確認作業を行った。この作業で代理店サービスが利用できることを確認して,8 時までに作業を終了した。
〔サービス運用段階のキャパシティ管理〕
サービスがオンライン処理形態の場合は,サーバの CPU 使用率,サーバの処理件数及びオンライン応答時間を監視項目とする。
T氏が確かめたのは「代理店サービスが利用できること」である。ところが代理店サーバは2台あり,1台だけに寄っていてもサービスは使える。この確認では振分けの誤りを見つけられない。
キャパシティ管理の担当として見るべきは,2台へ均等に振り分けられているかどうかである。図1の注記のとおり,負荷が均等になるように振り分けるのが負荷分散サーバの役目なので,そのとおり動いているかを数字で確かめる。
監視項目にはサーバのCPU使用率とサーバの処理件数があるので,これをサーバごとに見比べればよい。片寄っていれば数字がそろわない。
60字。解答例は「代理店サーバ1と代理店サーバ2が有効に稼働していることを,それぞれのサーバのCPU使用率から確認する。」で50字。
「応答時間を確認する」だけでは足りない。開始直後の数分間は利用がまだ少なく,1台でもさばけてしまうので,応答時間には表れない。
採点講評(IPA)
設問2は,要求を正しく振り分けて処理していることを確認する内容の記載がない誤った解答が多かった。振り分け処理の正常動作を確認できる具体的な内容を解答してほしかった。
設問3(1)
30字以内
本文中の下線(ア)として実施すべき内容を,30 字以内で述べよ。
解答例
サーバの処理件数とオンライン応答時間の推移を調べる。
解説
本文の根拠
〔サービス運用段階のキャパシティ管理〕
サービスがオンライン処理形態の場合は,サーバの CPU 使用率,サーバの処理件数及びオンライン応答時間を監視項目とする。
〔キャパシティ計画の変更〕
オンライン応答時間は,SLA 項目の目標値は達成しているが,サービス開始時に比べて悪化している。
〔キャパシティ計画の変更〕
インターネット受付システムは Web 型のシステムであって,主にサーバの処理能力がパフォーマンスに影響を与える。
下線(ア)は「サービスの需要」と「達成されているパフォーマンス」の2つを調べよと言っている。監視項目の中から,それぞれに当たるものを選ぶ。
需要に当たるのはサーバの処理件数である。どれだけ要求が来ているかを表す。
パフォーマンスに当たるのはオンライン応答時間である。すでに「サービス開始時に比べて悪化している」と分かっているので,どう推移したかを見る。
この2つを1年分並べれば,処理件数の伸びと応答時間の悪化がどう結び付いているかが読める。将来の需要を予測してキャパシティを見積もる材料になる。
CPU使用率は資源の使われ方を表すもので,需要そのものでもパフォーマンスでもない。
30字。解答例は「サーバの処理件数とオンライン応答時間の推移を調べる。」で25字。
採点講評(IPA)
設問3(1)は,誤った解答が散見された。業務サーバの負荷状況や性能を確認できる具体的な監視項目を解答してほしかった。
設問3(2)
40字以内
キャパシティ計画を変更するに当たって監視データ以外に L 氏が入手すべき情報を,入手先を含めて 40 字以内で述べよ。
解答例
将来のサービスに対する需要とサービス利用者の見通しを営業部門から入手する。
解説
本文の根拠
〔キャパシティ計画の策定〕
営業部門から入手した,現在及び将来のサービスに対する需要とサービス利用者の見通しから,データ処理量の増加を見積もる。
〔キャパシティ計画の変更〕
オンライン応答時間の SLA 項目の目標値を達成するために,将来の需要の予測が必要である。
冒頭
これらのサービスは F 社の営業部門が統括している。
監視データから分かるのは,これまでどうだったかだけである。これから利用者がどれだけ増えるかは,運用の記録には残っていない。
答えはキャパシティ計画の策定手順にそのまま書いてある。営業部門から現在及び将来のサービスに対する需要とサービス利用者の見通しを入手し,そこからデータ処理量の増加を見積もる,という流れである。サービスを統括しているのが営業部門なので,見通しを持っているのもそこになる。
40字。解答例は「将来のサービスに対する需要とサービス利用者の見通しを営業部門から入手する。」で36字。設問が「入手先を含めて」と言っているので,営業部門を落とさない。
出典:平成28年度 秋期 ITサービスマネージャ試験 午後Ⅰ 問2(表記を一部改変)
問3 インシデント管理
インシデント管理に関する次の記述を読んで,設問1〜4に答えよ。
M 社は,中堅の通信販売会社である。M 社では,数年前からインターネット経由で注文を受け付ける販売サービスを開始した。サービス提供時間は 24 時間 365 日である。最近では,インターネット経由の注文が増えており,更なる売上拡大のために販売サービスの充実が課題となっている。また,受注した商品を顧客に配送する業務を支援する配送管理サービスが M 社の社員向けに提供されている。サービス提供時間は毎日 6 時から 23 時までである。
〔システムの概要〕
システム部では,販売サービスを提供する販売システム,及び配送管理サービスを提供する配送管理システムを開発し,運用している。システムの開発は開発チームが担当し,運用は運用チームが担当している。
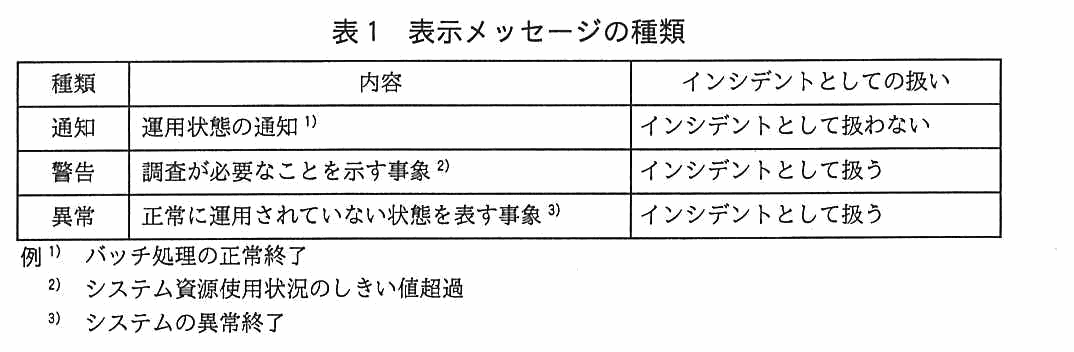
販売システムは,外部の顧客が利用する M 社の重要システムであり,5 台の Web サーバで冗長システムを構成している。M 社では,Web 管理端末から Web サーバにコンテンツを登録している。また,外部の顧客との連絡手段として電子メールを使っていることから,社員間でも利用するメールサーバを販売システムのコンポーネントとして管理している。 販売システム及び配送管理システムは,運用チームが監視システムを利用して常時監視し,インシデントが発生した場合は 1 次対応を行っている。インシデントはインシデント管理システムで管理している。 監視システムに表示されるメッセージ(以下,表示メッセージという)は,M 社の統一基準に従って分類されている。表示メッセージの種類を表1に示す。
表1 表示メッセージの種類
〔システム部のインシデント管理〕
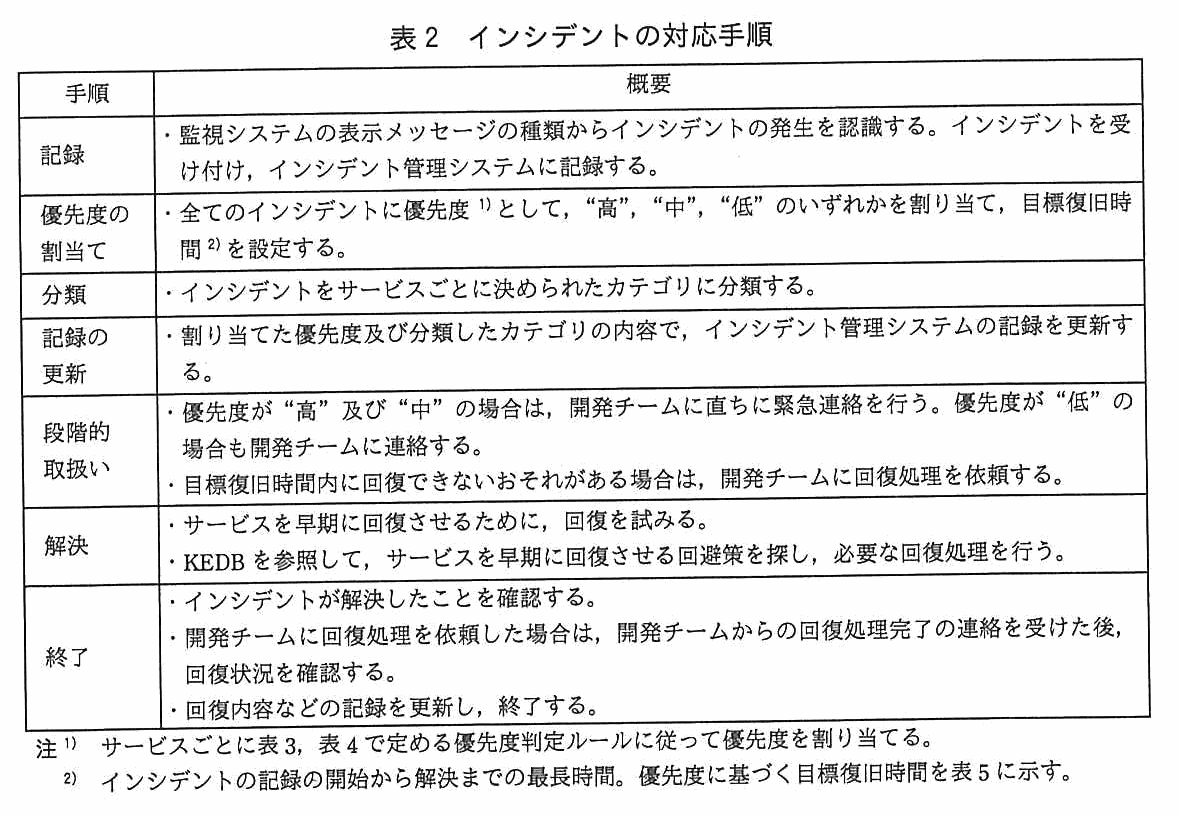
システム部では,表示メッセージの種類が“警告”又は“異常”の場合,インシデントとして扱い,インシデント管理システムに記録する。また,サービスを早期に回復させるために,既知の誤りのデータベース(以下,KEDB という)を利用している。KEDB には,過去のインシデントの発生原因と,サービスの回復方法又はサービスへの影響を低減する有効な回避策が登録されている。運用チームはインシデントの対応手順の中で,KEDB を参照する。
運用チームが実施するインシデントの対応手順を表2に示す。
表2 インシデントの対応手順
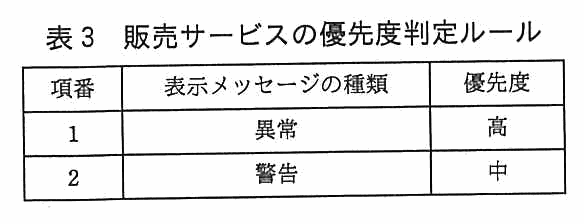
表3 販売サービスの優先度判定ルール
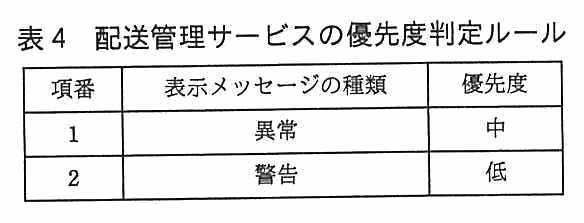
表4 配送管理サービスの優先度判定ルール
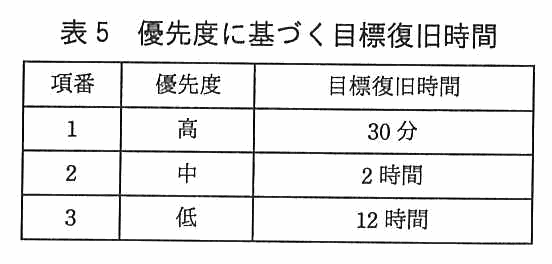
表5 優先度に基づく目標復旧時間
発生したインシデントが情報セキュリティインシデントに該当するおそれがある場合,運用チームの担当者は,システム部の情報セキュリティ担当要員に連絡して,指示に従って対応する。情報セキュリティ担当要員は,インシデントが情報セキュリティインシデントに該当するかどうかを判断する。該当する場合は,M 社の情報セキュリティ管理プロセスの規程に従って対応を指示し,自ら迅速に対応策を実施して被害を最小限に抑える。
〔販売サービスのインシデント〕
ある日,販売システムの 5 台の Web サーバのうち,1 台の CPU 使用率がしきい値を超え,監視システムで“警告”のメッセージが表示された。監視していた運用チームの Y 氏は,インシデントの対応手順に従って対応した。対応状況は次のとおりである。
インシデントをインシデント管理システムに記録した。 表 3 及び表 5 を参照し,優先度を“中”と割り当て,目標復旧時間を 2 時間に設定した。その後,分類したカテゴリの内容で記録の更新を行った。 インシデントの解決を図るために,解決策を立案し実施することにした。そこで,必要な回復処理を行うために KEDB を参照したところ,特定の条件の下で販売システムのバッチ処理プログラムの負荷が高くなって,CPU 使用率が上昇した事例を見つけた。回避策として,バッチ処理プログラムを強制終了させる方法,又は Web サーバの再起動を行う方法が記載されていた。そこで,Web サーバを確認したが,バッチ処理プログラムは稼働していなかった。 CPU 使用率のしきい値超過は,販売システムの Web サーバ 1 台だけで発生しており,他の 4 台の Web サーバでは発生していない。Y 氏は,サービス継続の観点から,利用者への影響は小さいと判断し,インシデントの原因を調査することにした。Y 氏は,CPU 使用率のしきい値超過が発生している Web サーバを調査し,CPU 使用率が高いプログラムを特定した。 CMDB に登録されている販売システムのプログラム一覧を確認したところ,特定したプログラムは CMDB には登録されていなかった。そこで,Y 氏は開発チームの Z 氏に調査を依頼した。 Z 氏は,稼働環境で販売サービスを利用したところ,応答遅延が発生する場合があることを確認した。次に,Z 氏は,CMDB を確認し,当該プログラムは CMDB に登録されておらず,M 社が開発したプログラムではないことが分かった。更に調査したところ,不正プログラムであることが判明した。Z 氏は Y 氏に調査結果を回答し,強制終了する手順を伝えた。Y 氏は Z 氏の指示に従って,不正プログラムを強制終了した。その結果,Web サーバの CPU 使用率の低下を確認できたことから,Y 氏はインシデントが解決したと判断した。
なお,Z 氏は,CMDB に登録されていないプログラムが稼働していた場合に強制終了する手順を回避策として整備し,後日 KEDB に登録することにした。
〔標的型攻撃メールの検出〕
Z 氏は,インシデントの根本原因を特定するために調査し,次の事実が判明した。
Web 管理端末にも不正プログラムがあった。 不正プログラムは,販売システムの 5 台の Web サーバのうち,1 台の Web サーバだけに存在していた。 メールサーバのログには,不審なファイルが添付された Web 管理者宛ての電子メールの受信記録があった。また,同じファイルが添付された電子メールが社内の他部署の社員にも送信されている記録があった。 そこで,Z 氏は,“外部から送付された標的型攻撃メールに添付されたファイルを Web 管理端末で開封した。その際,不正プログラムが起動され,Web 管理端末と,メンテナンス作業のために接続していた該当の 1 台の Web サーバに不正プログラムがコピーされ,動作するよう設定された。”と推定した。Z 氏は,今回のインシデントが情報セキュリティインシデントに該当するおそれがあるとして,情報セキュリティ担当要員の K 氏に連絡した。K 氏は,情報セキュリティインシデントに該当すると判断し,Z 氏に,1 台の Web サーバと Web 管理端末を LAN から切り離すように指示した。そこで,Z 氏は Y 氏に,該当機器を LAN から切り離すよう依頼した。
次に,K 氏は,類似の標的型攻撃メールが送付された宛先を,a から調査し,標的型攻撃メールが届いた全ての社員に対して,次の内容を直ちに指示した。
社員が添付ファイルを開封していた場合,開封操作を行った機器を LAN から切り離す。その後,指示に従って不正プログラムの確認をすること。 社員が添付ファイルを開封していない場合,b をすること。 そして,K 氏は,社内に今回の標的型攻撃メールに対する注意喚起を行った。
〔標的型攻撃メールの対策〕
システム部の部長は,K 氏から,“今回の標的型攻撃メールには,情報窃取を目的として,マルウェアを仕掛けたファイルが添付されていた。幸い外部への情報漏えいは確認されなかった。また,社内への注意喚起も完了した。”という報告を受けた。システム部では,標的型攻撃メールへの対策として,マルウェアが仕掛けられた標的型攻撃メールを検出した場合,電子メールから添付ファイルを削除したり,不正な通信を検出したりすることができるシステム(以下,防御システムという)を検討し,導入することにした。システム部は,防御システムを販売システムのコンポーネントとして管理する。また,システム部は,標的型攻撃メールを検出した場合の対応として,次のとおり決定した。
検出された電子メールの添付ファイルは,調査用に防御システムのストレージに保存される。情報セキュリティ担当要員は,保存されたファイルの内容を定期的に調査し,対策が必要と判断した場合は,適切な対策を立案し実施する。 防御システムで,特定の基準以上の危険性がある不正な通信を検出した場合は監視システムに通知する。(ア)通知された監視システムでは,“警告”のメッセージを表示する 。 運用チームは,インシデントを記録し,管理する。 〔配送管理サービスの変更〕
M 社では,顧客へのサービス充実を目的に,インターネット経由の注文について,配送時間を短縮することを決定した。そのためには,M 社の物流拠点間で深夜に商品を配送する必要がある。営業部とシステム部は,配送管理サービスのサービス要求事項について,次のとおり合意した。
物流拠点からいつでも配送管理サービスを利用できるように,配送管理システムを 24 時間稼働に変更する。 システム障害による配送業務の停止は,サービスの低下につながるので,システム停止を伴うインシデントが発生した場合には,インシデントの対応手順に従って,30 分以内に回復させる。 システム部では,サービス要求事項を基に,サービス変更の活動を開始した。
出題趣旨(IPA)
インシデント管理のプロセスでは,サービスの回復を,合意したサービス目標及び時間枠内に達成するために,インシデントを一貫して管理することが求められる。本問では,標的型攻撃メールによるインシデントを題材に,ITサービスマネージャとして必要な,インシデントを解決する能力,インシデント解決のために分析を行う能力,及びインシデント管理手順を管理する能力を問う。
設問と解答例
設問1(1)
解答欄2つ
Y 氏が実施したインシデント対応の問題点を二つ挙げ,それぞれ 30 字以内で述べよ。ただし,情報セキュリティに関する内容は除くこと。
〔①〕解答例
優先度に従って開発チームに緊急連絡を行っていない。
〔②〕解答例
サービスの早期回復を優先せずに原因の調査を続けた。
解説
本文の根拠
表2 段階的取扱い
段階的取扱い:優先度が“高”及び“中”の場合は,開発チームに直ちに緊急連絡を行う。
表2 解決
解決:サービスを早期に回復させるために,回復を試みる。KEDB を参照して,サービスを早期に回復させる回避策を探し,必要な回復処理を行う。
〔販売サービスのインシデント〕
Y 氏は,サービス継続の観点から,利用者への影響は小さいと判断し,インシデントの原因を調査することにした。
表2の手順とY氏の行動を,上から突き合わせる。
手順は,記録 → 優先度の割当て → 分類 → 記録の更新 → 段階的取扱い → 解決 → 終了の順である。ところがY氏は,記録の更新の次にいきなり解決へ進んでいる。優先度は“中”なので,本来はその前に開発チームへ直ちに緊急連絡をしなければならない。これが1つ目の問題点である。
2つ目は解決の中身である。KEDBには回避策が2つ書かれていた。バッチ処理プログラムの強制終了と,Webサーバの再起動である。バッチ処理は動いていなかったが,再起動のほうは試せた。それをせずに原因の調査へ移っている。手順“解決”の目的は「サービスを早期に回復させる」ことであって,原因を突き止めることではない。
各30字。「利用者への影響は小さい」という判断自体が,早期回復より調査を選ばせた原因になっている。
採点講評(IPA)
設問1(1)では,Y氏の実施した記録から解決までのインシデント対応手順の中で,段階的取扱い及び解決に関する問題点を的確に指摘してほしかった。
設問1(2)
40字以内
Z 氏が,KEDB に回避策を登録した目的を,40 字以内で述べよ。
解答例
同類のインシデントが再発した場合に,サービスを早期に回復させるため
解説
本文の根拠
〔システム部のインシデント管理〕
サービスを早期に回復させるために,既知の誤りのデータベース(以下,KEDB という)を利用している。KEDB には,過去のインシデントの発生原因と,サービスの回復方法又はサービスへの影響を低減する有効な回避策が登録されている。
〔販売サービスのインシデント〕
Z 氏は,CMDB に登録されていないプログラムが稼働していた場合に強制終了する手順を回避策として整備し,後日 KEDB に登録することにした。
今回なぜ時間がかかったかを振り返る。KEDBに該当する回避策がなかったので,Y氏は原因の調査に入り,開発チームのZ氏の調査結果を待って,ようやく強制終了にたどり着いた。
登録しておけば,次に同じことが起きたときはKEDBを見るだけで手順が分かる。運用チームだけで,開発チームの調査を待たずに回復できる。
KEDBの目的そのものが本文に「サービスを早期に回復させるために」と書いてあるので,そこに沿って答える。
40字。解答例は「同類のインシデントが再発した場合に,サービスを早期に回復させるため」で32字。「記録を残すため」では,KEDBを使う意味が言えていない。
設問2(1)
15字以内
本文中の a に入れる適切な字句を 15 字以内で答えよ。
解答例
解説
本文の根拠
〔標的型攻撃メールの検出〕
メールサーバのログには,不審なファイルが添付された Web 管理者宛ての電子メールの受信記録があった。また,同じファイルが添付された電子メールが社内の他部署の社員にも送信されている記録があった。
他部署の社員にも同じファイルが送られている,という事実は,直前のZ氏の調査でメールサーバのログから分かったものである。
宛先を洗い出すのにも,同じログを使えばよい。誰に何が届いたかは,受信の記録が持っている。
15字。解答例は「メールサーバのログ」で9字。
採点講評(IPA)
設問2は,正答率が高く,標的型攻撃メール受信などセキュリティインシデントが発生した際の緊急対応方法は理解されているようだった。
設問2(2)
20字以内
本文中の b で指示すべき事項を,20 字以内で答えよ。
解答例
解説
本文の根拠
〔標的型攻撃メールの検出〕
社員が添付ファイルを開封していた場合,開封操作を行った機器を LAN から切り離す。その後,指示に従って不正プログラムの確認をすること。
〔標的型攻撃メールの検出〕
そして,K 氏は,社内に今回の標的型攻撃メールに対する注意喚起を行った。
開封していないなら,その機器に不正プログラムは入っていない。だからLANから切り離す必要はないし,確認も要らない。
ただし電子メール自体は受信箱に残ったままである。残しておけば,あとで気づかずに開いてしまう恐れがある。危険はまだ去っていない。
だから削除させる。開封した人には切り離しと確認を,していない人には削除を,と指示を分けているのはこのためである。
20字。解答例は「標的型攻撃メールの削除」で11字。
採点講評(IPA)
設問2は,正答率が高く,標的型攻撃メール受信などセキュリティインシデントが発生した際の緊急対応方法は理解されているようだった。
設問3
40字以内
〔標的型攻撃メールの対策〕について,本文中の下線(ア)で,監視システムに“警告”のメッセージを表示させる理由を,40 字以内で述べよ。
解答例
情報セキュリティ担当要員に連絡して,早期に対応する必要があるから
解説
本文の根拠
表1
通知:運用状態の通知,インシデントとして扱わない。警告:調査が必要なことを示す事象,インシデントとして扱う。
〔システム部のインシデント管理〕
発生したインシデントが情報セキュリティインシデントに該当するおそれがある場合,運用チームの担当者は,システム部の情報セキュリティ担当要員に連絡して,指示に従って対応する。
〔標的型攻撃メールの対策〕
防御システムで,特定の基準以上の危険性がある不正な通信を検出した場合は監視システムに通知する。
表1の区分が効いてくる。“通知”はインシデントとして扱わないので,表示されても運用チームは対応手順に乗せない。“警告”ならインシデントとして扱う。
インシデントとして扱えば,運用チームが記録し,情報セキュリティインシデントに該当するおそれがあるとして情報セキュリティ担当要員へ連絡が回る。担当要員は対応策を実施して被害を最小限に抑える役目をもっている。
不正な通信は情報の持ち出しにつながるので,止めるのが早いほど被害が小さい。“通知”のままにすると,誰の手も動かないまま流出が続く。
40字。解答例は「情報セキュリティ担当要員に連絡して,早期に対応する必要があるから」で31字。
「記録を残すため」では弱い。記録が目的なのではなく,担当要員へ渡して手を打たせるのが目的である。
採点講評(IPA)
設問3は,“記録を残すためにインシデントとして管理する”などの誤った解答が多かった。セキュリティインシデントの可能性がある場合の影響範囲の確認や被害拡大防止のための対応手順を理解した上で解答してほしかった。
設問4
40字以内
〔配送管理サービスの変更〕について,サービス要求を満たすためにインシデントの対応手順を変更する必要がある。変更内容を 40 字以内で述べよ。
解答例
配送管理サービスの優先度判定ルールで“異常”の優先度を“高”に変更する。
解説
本文の根拠
〔配送管理サービスの変更〕
システム障害による配送業務の停止は,サービスの低下につながるので,システム停止を伴うインシデントが発生した場合には,インシデントの対応手順に従って,30 分以内に回復させる。
表4
項番1:異常,中。項番2:警告,低。
表5
項番1:高,30 分。項番2:中,2 時間。項番3:低,12 時間。
求められているのは30分以内の回復である。表5で30分に当たるのは優先度“高”だけなので,該当するインシデントを“高”に上げる必要がある。
該当するのは「システム停止を伴うインシデント」で,表1の“異常”(正常に運用されていない状態)がこれに当たる。ところが表4では,配送管理サービスの“異常”は“中”,つまり2時間になっている。これでは要求を満たせない。
そこで表4の優先度判定ルールを変え,“異常”を“高”にする。“警告”は調査が必要な事象でシステム停止ではないので,“低”のままでよい。
40字。解答例は「配送管理サービスの優先度判定ルールで“異常”の優先度を“高”に変更する。」で36字。表5の目標復旧時間のほうを書き換える答えは誤りで,そちらは全サービス共通なので,販売サービスの目標まで一緒に変わってしまう。
採点講評(IPA)
設問4は,正答率が高かった。ITサービスマネージャとして,サービスの変更に対応したサービス目標について合意し,優先度に基づくインシデントの解決目標時間を見直す方法や必要性は,理解されているようであった。
出典:平成28年度 秋期 ITサービスマネージャ試験 午後Ⅰ 問3(表記を一部改変)
ほかの年度
令和7年度 秋期 午前Ⅱ
令和5年度 春期 午前Ⅱ
令和4年度 春期 午前Ⅱ
令和3年度 春期 午前Ⅱ
令和元年度 秋期 午前Ⅱ
平成30年度 秋期 午前Ⅱ
平成29年度 秋期 午前Ⅱ
平成28年度 秋期 午前Ⅱ
平成27年度 秋期 午前Ⅱ
平成26年度 秋期 午前Ⅱ
平成25年度 秋期 午前Ⅱ
平成24年度 秋期 午前Ⅱ
平成23年度 秋期 午前Ⅱ
平成22年度 秋期 午前Ⅱ
平成21年度 秋期 午前Ⅱ
令和6年度 春期 午前Ⅱ
令和5年度 春期 午前Ⅱ
令和4年度 春期 午前Ⅱ
令和6年度 春期 午前Ⅱ
令和5年度 春期 午前Ⅱ
令和4年度 春期 午前Ⅱ
令和6年度 春期 午前Ⅱ
令和5年度 春期 午前Ⅱ
令和4年度 春期 午前Ⅱ
令和7年度 秋期 午前Ⅱ
令和6年度 秋期 午前Ⅱ
令和5年度 秋期 午前Ⅱ
令和4年度 秋期 午前Ⅱ
令和3年度 秋期 午前Ⅱ
令和2年度 10月 午前Ⅱ
平成31年度 春期 午前Ⅱ
平成30年度 春期 午前Ⅱ
平成29年度 春期 午前Ⅱ
平成28年度 春期 午前Ⅱ
平成27年度 春期 午前Ⅱ
令和7年度 秋期 午前Ⅰ
令和7年度 春期 午前Ⅰ
令和7年度 春期 午前Ⅱ
令和7年度 春期 午後Ⅰ
令和6年度 秋期 午前Ⅰ
令和6年度 春期 午前Ⅰ
令和6年度 春期 午前Ⅱ
令和6年度 春期 午後Ⅰ
令和5年度 秋期 午前Ⅰ
令和5年度 春期 午前Ⅰ
令和5年度 春期 午前Ⅱ
令和5年度 春期 午後Ⅰ
令和4年度 秋期 午前Ⅰ
令和4年度 春期 午前Ⅰ
令和4年度 春期 午前Ⅱ
令和4年度 春期 午後Ⅰ
令和3年度 秋期 午前Ⅰ
令和3年度 春期 午前Ⅰ
令和3年度 春期 午前Ⅱ
令和3年度 春期 午後Ⅰ
令和2年度 10月 午前Ⅰ
令和元年度 秋期 午前Ⅰ
令和元年度 秋期 午前Ⅱ
令和元年度 秋期 午後Ⅰ
平成31年度 春期 午前Ⅰ
平成30年度 秋期 午前Ⅰ
平成30年度 秋期 午前Ⅱ
平成30年度 秋期 午後Ⅰ
平成30年度 春期 午前Ⅰ
平成29年度 秋期 午前Ⅰ
平成29年度 秋期 午前Ⅱ
平成29年度 秋期 午後Ⅰ
平成29年度 春期 午前Ⅰ
平成28年度 秋期 午前Ⅰ
平成28年度 秋期 午前Ⅱ
平成28年度 春期 午前Ⅰ
平成27年度 秋期 午前Ⅰ
平成27年度 春期 午前Ⅰ
平成27年度 秋期 午前Ⅱ
平成27年度 秋期 午後Ⅰ
平成26年度 秋期 午前Ⅰ
平成26年度 秋期 午後Ⅰ
平成26年度 春期 午前Ⅰ
平成25年度 秋期 午前Ⅰ
平成25年度 秋期 午後Ⅰ
平成25年度 春期 午前Ⅰ
平成24年度 秋期 午前Ⅰ
平成24年度 秋期 午後Ⅰ
平成24年度 春期 午前Ⅰ
平成23年度 秋期 午前Ⅰ
平成23年度 秋期 午後Ⅰ
平成23年度 特別試験 午前Ⅰ
平成22年度 秋期 午前Ⅰ
平成22年度 秋期 午後Ⅰ
平成22年度 春期 午前Ⅰ
平成21年度 秋期 午前Ⅰ
平成21年度 秋期 午後Ⅰ
平成26年度 秋期 午前Ⅱ
平成25年度 秋期 午前Ⅱ
平成24年度 秋期 午前Ⅱ
平成23年度 秋期 午前Ⅱ
平成22年度 秋期 午前Ⅱ
平成21年度 秋期 午前Ⅱ
平成21年度 春期 午前Ⅰ