令和7年度 春期に実施されたITサービスマネージャ試験
午後Ⅰの全3問(記述式)です。事例本文・設問・解答例と解説をそのまま読めます。
この年度を解いてみる
問1 インシデント管理プロセスの分析と改善
インシデント管理プロセスの分析と改善に関する次の記述を読んで,設問に答えよ。
J 社は,全国で電子機器を製造し,販売する電子機器メーカーである。J 社の情報システム部は,販売システム(以下,K システムという)の開発と運用を行っている。J 社の全国の支店には販売部の販売担当者がおり,販売サービス(以下,K サービスという)を利用して販売活動を行っている。K サービスは,K システムによって実現されている。
情報システム部には,開発課と運用課がある。開発課は,管理者の開発課長及び数名の開発担当者で構成され,主に機能追加などの開発業務を開発計画に基づいて実施している。運用課には,管理者の運用課長及び運用業務の取りまとめを行う L 氏がおり,システムの運用を担当する運用チーム及び利用者からの問合せやインシデントの対応を行うサービスデスクがある。サービスデスクは担当者(以下,オペレーターという)の離職率が高く,経験の浅いオペレーターも多い。また,情報システム部は,インシデント管理,問題管理,変更管理などのサービスマネジメント活動ごとに,対応手順を定めている。サービスマネジメント活動全体は L 氏が統括している。
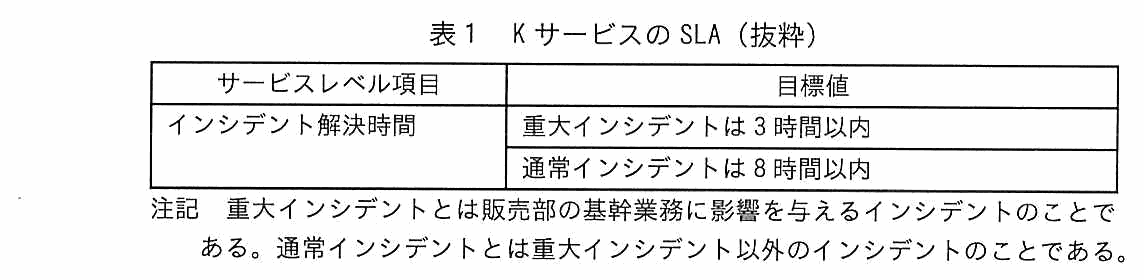
K サービスについて,情報システム部と販売部とは表1に示す SLA を合意している。
表1 K サービスの SLA(抜粋)
今年になって,K システムを更改したこともあり,インシデントの発生が多くなっている。先月は,重大インシデントはなかったが,通常インシデントが 200 件発生した。インシデントの解決時間は最長で 7 時間 40 分も掛かっており,SLA の目標値達成が危ぶまれる状況になっている。そこで,通常インシデントの管理について分析することにした。
〔インシデント管理の概要〕
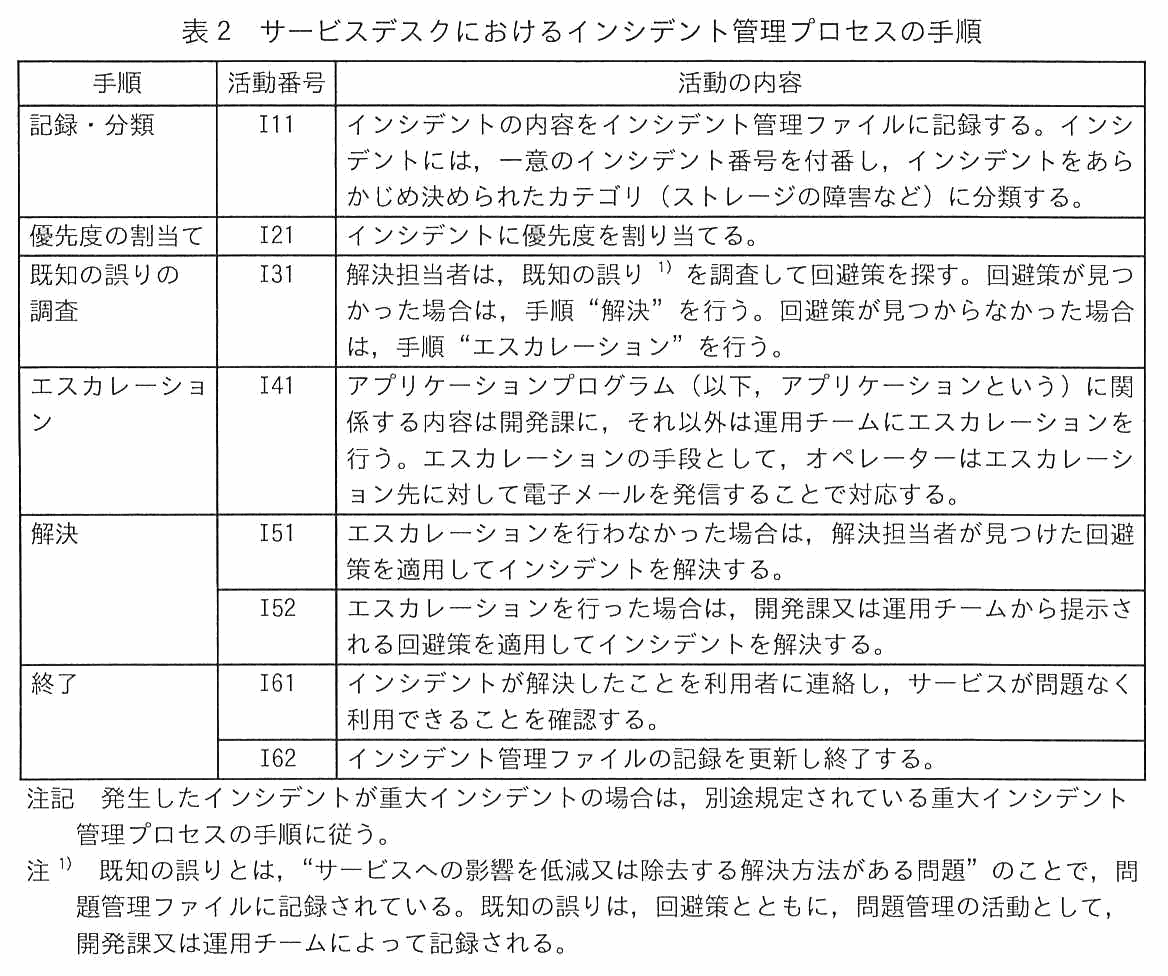
オペレーターは,利用者から“K サービス利用中にある事象が発生し,対処の仕方が分からない”との問合せを受け,事象について利用者とコミュニケーションを行った結果,当該事象をインシデントと認識する場合がある。このようにインシデントの発生を認識した場合は,自らが解決担当者となってインシデント管理プロセスを開始する。サービスデスクにおけるインシデント管理プロセスの手順を表2に示す。
表2 サービスデスクにおけるインシデント管理プロセスの手順
オペレーターは,手順を効率的に実施するために,ソフトウェアツールとしてインシデント管理システムを使用し,インシデント管理ファイルに対応した内容を登録している。インシデント管理ファイルには,データ項目として,インシデント番号,活動番号,担当者の ID,対応日時(開始日時,終了日時),対応内容などがあり,インシデントの活動ごとにデータ項目の内容が記録される。オペレーターは,インシデントの発生を認識した場合,活動番号 I11 で,“担当者の ID”に自らの社員番号を登録する。社員番号が登録されると,インシデント管理システムは“開始日時”を記録する。オペレーターは活動ごとに対応した内容を入力していく。インシデント管理システムはオペレーターの入力と連動して活動の対応日時を記録していく。なお,活動番号 I41 でエスカレーションを行った場合,オペレーターは I41 の終了日時にエスカレーションの電子メールの発信日時を登録する。
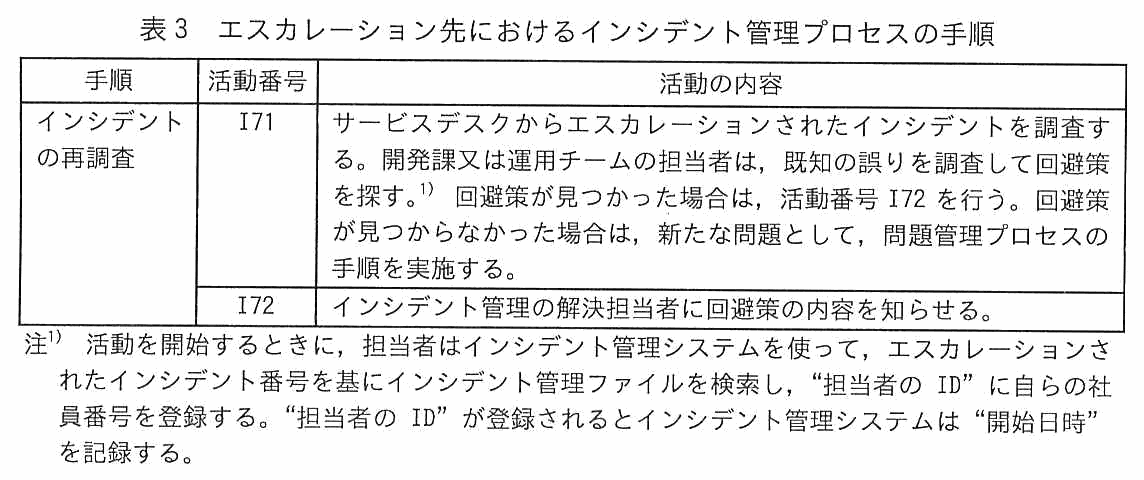
サービスデスクからエスカレーションされたインシデントについて,開発課又は運用チームで,再度,回避策が存在するかどうかを詳細に調査する。調査した結果で回避策が見つかった場合は,インシデント管理の解決担当者に回避策の内容を提示する。回避策が見つからなかった場合は,インシデントの原因となる問題を調査する必要があり,問題管理プロセスの手順を実施する。エスカレーション先におけるインシデント管理プロセスの手順を表3に示す。
表3 エスカレーション先におけるインシデント管理プロセスの手順
〔問題管理の概要〕
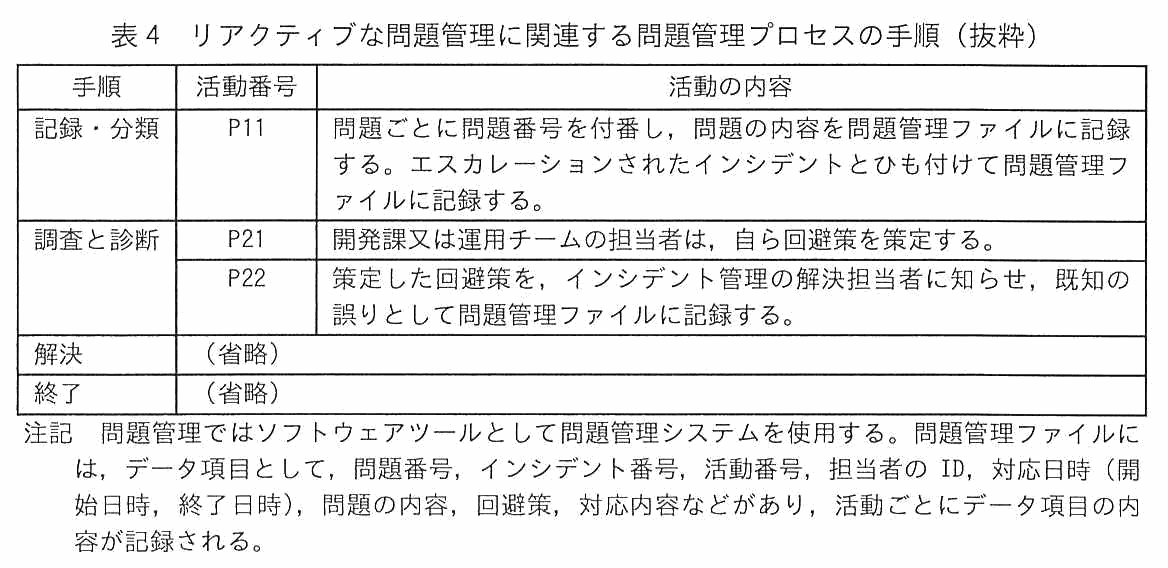
問題管理には,インシデント発生に伴って実施するリアクティブな問題管理の作業だけでなく,ベンダーから公開されるパッチ情報が K システムのアプリケーションに影響するかどうかに関する調査などのプロアクティブな問題管理の作業がある。開発課の場合,パッチ情報の適用時期などを踏まえ,プロアクティブな問題管理の作業は開発計画に織り込んで実施する。問題管理のうち,リアクティブな問題管理は突発的な作業であり,計画した作業を中断して実施する必要がある。リアクティブな問題管理に関連する問題管理プロセスの手順(抜粋)を,表4に示す。
表4 リアクティブな問題管理に関連する問題管理プロセスの手順(抜粋)
〔改善活動の実施〕
L 氏は,表2,表3及び表4の活動を可視化,分析し,インシデントを解決する活動の全体像を捉えて課題を発見し,改善することにした。
〔インシデント対応の分析〕
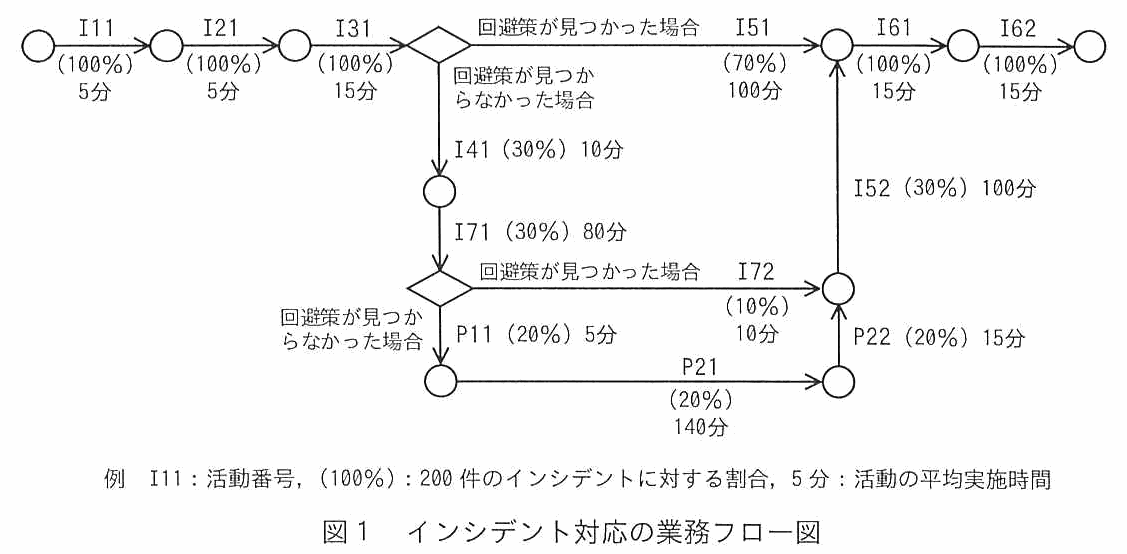
まず,先月発生したインシデントの 200 件を対象として課題となる活動を特定することにした。そこで,インシデントの対応時に記録しているインシデント管理ファイルと問題管理ファイルの対応履歴を使って,分析対象の(ア)インシデント対応の業務フロー図を作成 した。作成したインシデント対応の業務フロー図を図1に示す。
図1 インシデント対応の業務フロー図
なお,作成に当たっては,あるインシデントで実施した活動番号ごとの実施時間の合計が当該インシデントの解決時間となるように工夫した。具体的には,I11 の実施時間は I11 の開始日時と終了日時の時間差とし,それ以降の活動番号の実施時間は,一つ前に実施した活動番号の終了日時と当該活動番号の終了日時との時間差とした。
L 氏は,図1から,対象の 200 件のうち,解決担当者が問題管理ファイルから回避策を見つけることができずエスカレーションを行ったものは a 件で,全てアプリケーションに関する内容であり,開発課にエスカレーションされていることを把握した。また,開発課にエスカレーションされたもののうち,開発課で回避策が見つからなかったインシデントは,b 件であることを把握した。
次に,L 氏は図1からインシデント対応には次の三つのパスがあることを確認した。
パス1:表2の活動だけを行う。 パス2:表2及び表3の活動を行う。 パス3:表2,表3及び表4の活動を行う。 L 氏は,それぞれのパスにおける活動の平均実施時間を考慮し,三つのパスのうち,(イ)優先的に分析すべきパスを一つだけ 特定した。
〔改善策の検討〕
L 氏は,図1から,エスカレーションされたインシデントの解決に多くの時間が掛かっていることについて課題があると認識し,開発課及び運用課の業務に着目して調査を進めることにした。まず,図1の活動番号 P21 の調査を行ったところ,P21 は新しい問題を解決する活動であるため,時間が掛かることが分かった。そこで,表3及び表4の手順の中で,図1の活動番号 P21 の次に時間が掛かっている活動番号 I71 を調査した。L 氏は,I71 の活動は,サービスデスクからエスカレーションされて開発課が実施する活動となるので,(ウ)インシデント管理ファイルを使って,作業待ちが発生していないかどうかを調査 し,その後,開発課にヒアリングすることにした。
また,(エ)図1から,既知の誤りを調査して回避策を探す活動についても課題があると考えて調査を進めた 。
サービスデスクの要員は,開発課が使用しているツール(以下,M ツールという)を使って問題管理ファイルの回避策を検索している。M ツールは,開発課が問題管理ファイルへの回避策の登録・検索をする目的で開発したツールで,サービスデスクでも,そのツールを使用している。そこで,L 氏は,サービスデスクの要員構成に着目し,M ツール操作方法の習熟度合いに差がないかどうかについて,経験豊富なベテランオペレーターと経験の浅い新人オペレーターとに分けてヒアリングした。ベテランオペレーターは M ツールの高度な検索機能を使っていたが,新人オペレーターは検索機能を使いこなせていなかった。ベテランオペレーターは,インシデント解決手順の中での開発課要員とのコミュニケーションを通じて,M ツールの検索機能の使い方を習得していた。そこで,L 氏は,オペレーターが使用するツールに関して根本的な対策が必要と考え,c について,開発課に依頼できないか検討を開始した。
さらに,L 氏は,図1を確認し,回避策のあるインシデントが多いことに着目した。そこで,問題管理の活動について,開発課にヒアリングを行うことにした。
出題趣旨(IPA)
ITサービス提供組織では,組織が規定するプロセス手順に基づいてサービスマネジメント活動を行うことで,利用者に安定したサービス提供を行うことができる。本問では,サービスマネジメントにおけるインシデント管理や問題管理を題材に,インシデント対応の手順,インシデント対応に関連して対応するリアクティブな問題管理の活動などに関する実務能力について問う。
設問と解答例
設問1
20字以内
〔改善活動の実施〕について,L 氏が行った改善活動の目的を,K サービスの提供者の立場から 20 字以内で答えよ。
解答例(2通り)
SLAの目標値を確実に達成するため インシデントの解決時間を短縮するため
解説
本文の根拠
冒頭
インシデントの解決時間は最長で 7 時間 40 分も掛かっており,SLA の目標値達成が危ぶまれる状況になっている。
表1
インシデント解決時間について,重大インシデントは3時間以内,通常インシデントは8時間以内。
〔改善活動の実施〕
表2,表3及び表4の活動を可視化,分析し,インシデントを解決する活動の全体像を捉えて課題を発見し,改善することにした。
設問は「Kサービスの提供者の立場から」と断っている。利用者側の「早く使えるようになる」ではなく,提供者として何を守るために改善するのかを答える。
提供者が守るものは表1のSLAである。通常インシデントの目標は8時間以内なのに,先月の実績は最長7時間40分。残りは20分しかなく,本文も「SLAの目標値達成が危ぶまれる」と書いている。改善活動は,この目標を割らないために行っている。
20字に収める。解答例は「SLAの目標値を確実に達成するため」で16字。SLAという語を使わず「インシデントの解決時間を短縮するため」と書いてもよい。
設問2(1)
10字以内
下線(ア)では,インシデント管理ファイルと問題管理ファイルを使って,業務フロー図を作成する。両ファイルを結び付けるデータ項目を,10 字以内で答えよ。
解答例
解説
本文の根拠
〔インシデント管理の概要〕
インシデント管理ファイルには,データ項目として,インシデント番号,活動番号,担当者の ID,対応日時(開始日時,終了日時),対応内容などがあり
表4 注記
問題管理ファイルには,データ項目として,問題番号,インシデント番号,活動番号,担当者の ID,対応日時(開始日時,終了日時),問題の内容,回避策,対応内容などがあり
表4 P11
エスカレーションされたインシデントとひも付けて問題管理ファイルに記録する。
2つのファイルのデータ項目を並べて,共通するものを探す。インシデント管理ファイルにも問題管理ファイルにも「インシデント番号」がある。
問題管理ファイルがインシデント番号を持っているのは,表4のP11で「エスカレーションされたインシデントとひも付けて」記録するからである。ひも付けのために置かれた項目なので,これが2つのファイルを結ぶ鍵になる。
「活動番号」「担当者のID」「対応日時」も両方のファイルにあるが,同じものを指していない(活動番号はI11とP11で体系が違い,担当者も別の人)。結び付けに使えるのは,1件のインシデントに1つだけ付く番号である。10字に収まる答えは「インシデント番号」で8字。
設問2(2)
解答欄2つ
本文中の a ,b に入れる適切な数値を整数で答えよ。
解説
本文の根拠
冒頭
先月は,重大インシデントはなかったが,通常インシデントが 200 件発生した。
図1
I31 で回避策が見つからなかった場合は I41(30%)10分 → I71(30%)80分 へ進む。I71 で回避策が見つかった場合は I72(10%)10分を経て I52(30%)100分から I61 へ合流する。I71 で回避策が見つからなかった場合は P11(20%)5分
図1 凡例
(100%)は200件のインシデントに対する割合
図1の割合は,母数が200件のインシデントである。
aはエスカレーションを行った件数。エスカレーションは活動番号I41で,図1では30%。200×0.30=60件。
bは開発課で回避策が見つからなかった件数。I71で回避策が見つからなかったときに進むのがP11で,図1では20%。200×0.20=40件。
読み違いは検算で防げる。開発課に渡ったのはI71の30%で,そのうち回避策が見つかったのがI72の10%,見つからなかったのがP11の20%。10+20=30でI71と合う。合わなければ割合の拾い方を間違えている。
設問2(3)
40字以内
下線(イ)について,L 氏が優先的に分析すべきと考えた理由を,当該パスの番号を含めて,40 字以内で答えよ。
解答例
パス3は6時間45分で通常インシデントの解決目標時間に近づいているから
解説
本文の根拠
表1
通常インシデントは8時間以内
図1
I11(100%)5分 → I21(100%)5分 → I31(100%)15分 と進み,回避策が見つかった場合は I51(70%)100分 → I61(100%)15分 → I62(100%)15分 で終了する。
図1
I71 で回避策が見つからなかった場合は P11(20%)5分 → P21(20%)140分 → P22(20%)15分を経て I52 へ合流する。
3つのパスについて,通る活動の平均実施時間を足す。
パス1(表2だけ)は 5+5+15+100+15+15=155分,2時間35分。
パス2(表2と表3)は 5+5+15+10+80+10+100+15+15=255分,4時間15分。
パス3(表2と表3と表4)は 5+5+15+10+80+5+140+15+100+15+15=405分,6時間45分。
通常インシデントの目標は8時間以内なので,パス3だけが残り1時間15分まで迫っている。パス1とパス2は倍近い余裕がある。優先して分析すべきなのはパス3である。
40字にはパス番号と「6時間45分」(または目標との近さ)を必ず入れる。「パス3が一番時間が掛かるから」では,目標値との関係が言えていない。
採点講評(IPA)
設問2(3)は,正答率が平均的であった。パス3に時間がかかっていることだけを記述した解答が多かった。SLAの目標値達成が危ぶまれる状況を踏まえ,インシデントの解決目標時間に対して,他のパスと比較してパス3を優先すべき具体的な理由を解答してほしい。
設問3(1)
30字以内
下線(ウ)について,インシデント管理ファイルを使って調査する内容を,30 字以内で具体的に答えよ。
解答例
解説
本文の根拠
〔インシデント管理の概要〕
活動番号 I41 でエスカレーションを行った場合,オペレーターは I41 の終了日時にエスカレーションの電子メールの発信日時を登録する。
表3 注1
活動を開始するときに担当者はインシデント管理システムを使ってエスカレーションされたインシデント番号を基にインシデント管理ファイルを検索し,“担当者の ID”に自らの社員番号を登録する。“担当者の ID”が登録されるとインシデント管理システムは“開始日時”を記録する。
〔インシデント対応の分析〕
それ以降の活動番号の実施時間は,一つ前に実施した活動番号の終了日時と当該活動番号の終了日時との時間差とした。
「作業待ち」とは,サービスデスクがエスカレーションしてから開発課が手を付けるまでの空き時間である。この2つの時刻はどちらもインシデント管理ファイルに入っている。
I41の終了日時が,エスカレーションの電子メールを出した時刻。I71の開始日時が,開発課の担当者が自分の社員番号を登録した時刻。この差が,送ってから着手するまでの待ち時間になる。
図1でI71が80分と長いのも,これで説明がつく。実施時間の数え方が「一つ前の活動の終了日時から当該活動の終了日時まで」なので,待っていた時間もI71に含まれてしまう。I71を調べるのに作業待ちを疑うのは,この数え方から来ている。
30字。解答例は「I41の終了日時とI71の開始日時の時間差の状況」で25字。「作業待ち時間を調べる」では,どのデータを見るのかが言えていない。
採点講評(IPA)
設問3(1)は,正答率がやや低かった。改善が必要な課題を正確に把握するため,作業待ちの発生状況をシステムで記録された定量的なデータから,何をどのように調査する必要があるのか具体的に解答してほしい。
設問3(2)
50字以内
下線(エ)について,サービスデスクと開発課の活動結果の差異に着目して,課題の内容を,50 字以内で具体的に答えよ。
解答例
サービスデスクで回避策を発見できなかった60件のうち,20件を開発課が発見していること
解説
本文の根拠
表2 I31
既知の誤りの調査(I31)は解決担当者が既知の誤りを調査して回避策を探し,見つかれば手順“解決”を,見つからなければ手順“エスカレーション”を行う。
表3 I71
インシデントの再調査(I71)はサービスデスクからエスカレーションされたインシデントを調査し,開発課又は運用チームの担当者は既知の誤りを調査して回避策を探す。
図1
I71 で回避策が見つかった場合は I72(10%)10分を経て
サービスデスクのI31と開発課のI71は,どちらも「既知の誤りを調査して回避策を探す」で,見ている問題管理ファイルも同じである。同じ作業を2回している。
差が出るのは結果のほうである。サービスデスクが見つけられずエスカレーションしたのは60件(30%)。そのうち開発課が見つけたのはI72の10%で20件。同じファイルを見ているのに,60件のうち20件は開発課でだけ見つかっている。
本来サービスデスクで解決できたはずの20件が,エスカレーションを経て余計な時間を使っている。これが課題である。
50字には件数を入れる。「サービスデスクと開発課が同じ活動をしている」だけでは,どれだけ無駄が出ているかが言えていない。
採点講評(IPA)
設問3(2)は,正答率が低かった。サービスデスクと開発課で同じ活動をしていることだけを指摘する解答が散見された。本来サービスデスクで発見すべき回避策が開発課で多く発見されているという状況から,具体的な改善の課題を解答してほしい。
設問3(3)
30字以内
本文中の c に入れる適切な内容を,30 字以内で答えよ。
解答例(2通り)
オペレーターが回避策を効果的に検索できるツールの開発 開発課要員によるオペレーターへのMツール使用法の教育
解説
本文の根拠
〔改善策の検討〕
M ツールは,開発課が問題管理ファイルへの回避策の登録・検索をする目的で開発したツールで,サービスデスクでも,そのツールを使用している。
〔改善策の検討〕
ベテランオペレーターは M ツールの高度な検索機能を使っていたが,新人オペレーターは検索機能を使いこなせていなかった。
冒頭
サービスデスクは担当者(以下,オペレーターという)の離職率が高く,経験の浅いオペレーターも多い。
空欄cには,ツールについての根本的な対策で,かつ開発課に依頼できる内容が入る。
Mツールはもともと開発課が自分たちのために作ったもので,サービスデスクはそれを借りて使っている。作りが開発課向けなので,新人オペレーターには検索機能が使いこなせない。
ベテランは開発課要員とのやり取りの中で,たまたま使い方を覚えた。だがサービスデスクは離職率が高く経験の浅い人が多いので,この偶然に任せたままでは人が入れ替わるたびに元へ戻る。だから開発課に頼んで,仕組みとして手当てする。
30字。オペレーター向けに検索しやすいツールを作ってもらう(解答例1)か,開発課からMツールの使い方を教える場を設けてもらう(解答例2)のどちらでもよい。
出典:令和7年度 春期 ITサービスマネージャ試験 午後Ⅰ 問1(表記を一部改変)
問2 高可用性システムの信頼性向上
高可用性システムの信頼性向上に関する次の記述を読んで,設問に答えよ。
U 社は,一般のインターネット利用者に動画配信サービス(以下,T サービスという)を 24 時間 365 日提供している。T サービスは,W 社のパブリッククラウドサービスを使った T システムによって実現されている。稼働環境と試験環境が存在し,稼働環境では高い可用性が求められている。T サービスは,現在 T1 から T5 の五つのマイクロサービス(以下,T1〜T5 サービスという)で構成されている。
〔T サービスの開発と運用における課題〕
U 社情報システム部は,開発課と運用課で構成され,開発課は開発課長の下で T サービスの開発を,運用課は運用課長の下で T サービスの運用を担当している。情報システム部では,スクラムによるアジャイル開発を採用し,開発課と運用課が連携してリリースサイクルを短縮することを目的に DevOps を推進してきた。スクラム開発によってリリース頻度が高まる一方で,運用課の受入準備が追い付かないといった事象が度々発生するようになった。また,停止時間は僅かではあるがサービス停止の事象も何回か発生しており,システムの信頼性が確保された安定した運用が求められている。
そこで,情報システム部の X 部長は,SRE(Site Reliability Engineering)の考え方を取り入れ,開発から運用までのライフサイクルに関わり,稼働する T サービスの信頼性に責任をもつ組織を作る必要があると考えた。X 部長は,U 社の経営層から了承を得て,暫定的な SRE チーム(以下,S チームという)を作り,3 か月後に正式なサービス開始を予定している T サービスの一つのマイクロサービス(以下,T6 サービスという)を対象として,検証を行うことにした。検証期間の間,情報システム部は,開発課,運用課及び S チームの三つの組織構成とし,S チームは X 部長が直轄する。
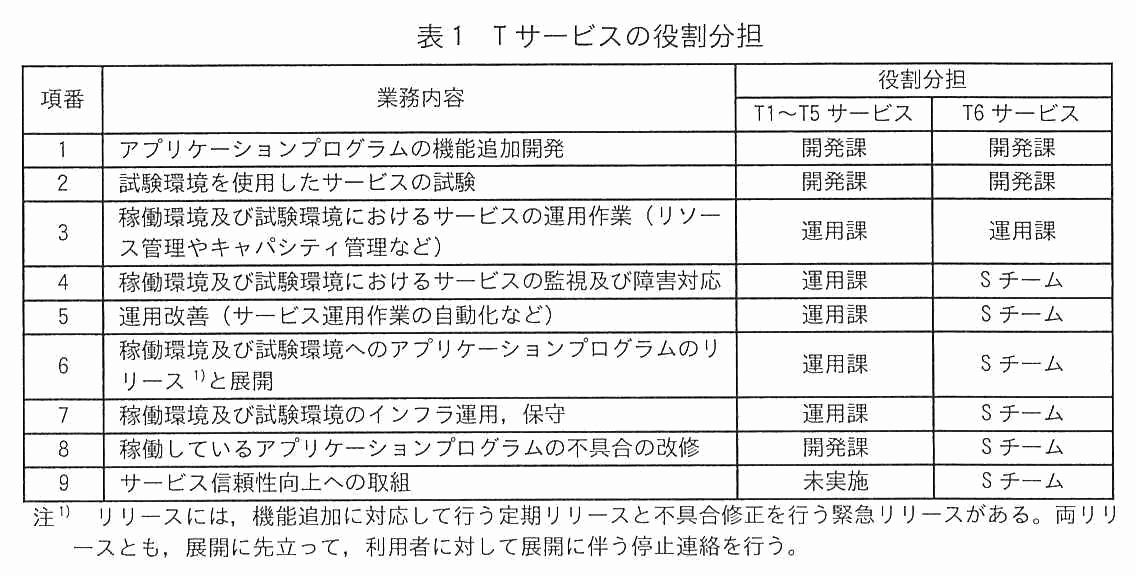
T6 サービスは,今後も反復アプローチに基づいた開発が継続する状況にあり,開発課は機能追加の開発に専念する必要がある。X 部長は,チームの編成に当たって,開発課長及び運用課長と調整を行い,開発課と運用課から(ア)開発経験と運用経験をともに有する要員を S チームに参画させる ことにし,T6 サービスを含む T サービスに関する役割分担を表1に整理した。
表1 T サービスの役割分担
〔S チームの目標設定〕
サービスの信頼性には,スループットや可用性などが該当し,サービスの信頼性を示す指標には,SLI(Service Level Indicator:サービスレベル指標)と SLO(Service Level Objective:サービスレベル目標)がある。SLI は,信頼性の目標が守られているかどうかを評価するために使うサービスレベルの計測値のことである。SLO は,SLI で計測されるサービスレベルの目標値のことである。
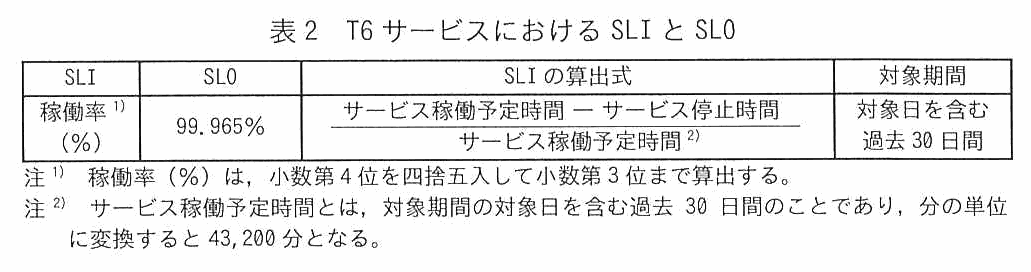
S チームは,T6 サービスにおける SLI と SLO について検討を行った。その結果を表2に示す。ここで,稼働率は算出式に基づいて毎日算出することにし,対象期間は対象日を含む過去 30 日間とする。
表2 T6 サービスにおける SLI と SLO
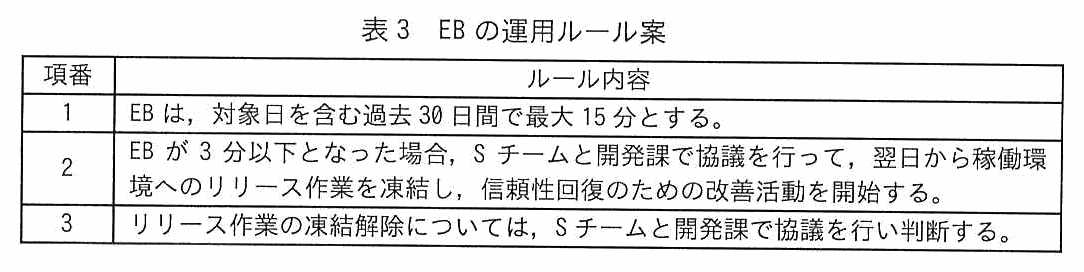
また,S チームは,エラーバジェット(以下,EB という)の運用を採用することにした。EB とは,サービスの信頼性が一定程度損なわれても許容できる時間を示す指標のことであり,定期リリースや緊急リリースの展開に伴って発生する稼働停止の時間及びエラー対処に要した時間を EB から消費させていく運用を行う。T6 サービスの EB は SLO が未達状態とならないサービス停止時間の最大値とする。具体的には,SLO が表2の場合,対象日を含む過去 30 日間の対象期間の中で 15 分を EB の最大値とし,その範囲でのサービス停止を許容した上でサービスを運用する。
EB の消費がひっ迫した場合は,開発課と協議を行い,更なる信頼性低下のリスクを抑えるためにリリース作業と機能追加開発作業を凍結し,サービスの安定性を重視した信頼性回復のための作業を優先して行うことにする。EB の消費ひっ迫を EB が 3 分以下(EB を 12 分消費)となった場合と定め,信頼性回復作業は S チームと開発課が主体的に取り組む。S チームで検討した EB の運用ルール案を表3に示す。
表3 EB の運用ルール案
S チームは,X 部長に運用ルール案を報告したところ,項番 2 について(イ)リリース作業の凍結については,例外規定を設けること を検討するように指示を受けた。
S チームは,検討した結果を X 部長に提案し,X 部長は提案内容を含めて運用ルール案を承認し,試行運用を開始するように S チームに指示した。
〔試行運用の開始〕
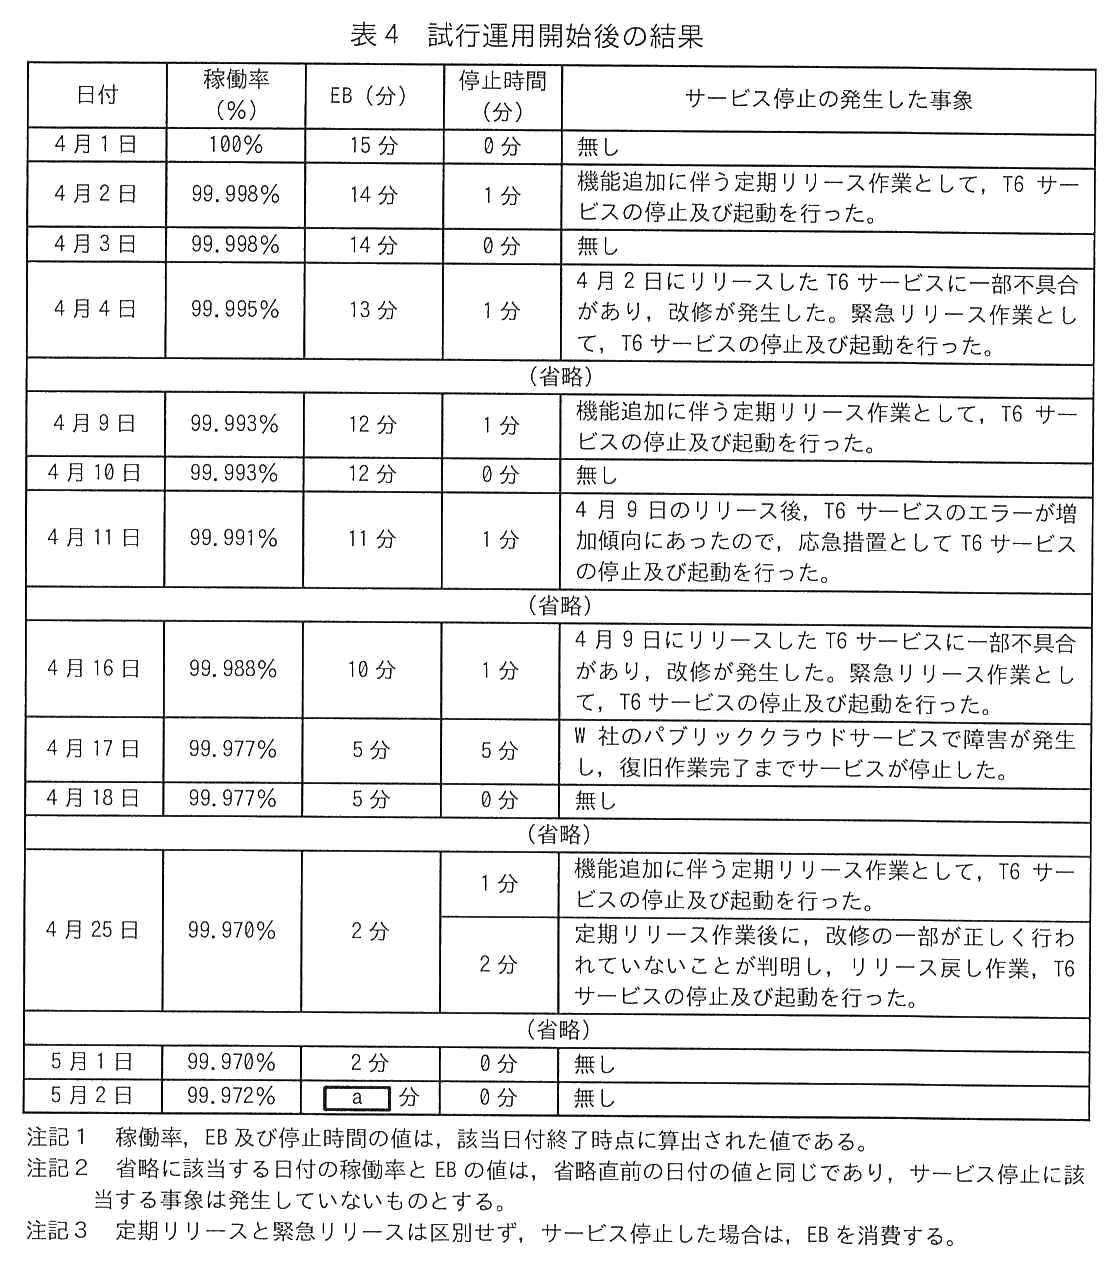
S チームは,4 月 1 日から EB の試行運用を開始した。T6 サービスは,2 月 1 日からサービス開始に向けた準備を進めて稼働環境で稼働しており,3 月はリリース作業などによるサービス停止の停止時間は発生していない。したがって,4 月 1 日開始時点での SLI の稼働率は,対象日を含む過去 30 日間のサービス稼働予定時間である 43,200 分から算出された 100%となり,EB は 15 分である。試行運用開始後の結果を表4に示す。ここで,EB は,次の計算式に基づいて計算される。
当日の EB = 前日の EB - 当日の EB の消費 + 当日の EB の回復 当日の EB の消費とは“当日発生したサービス停止時間のこと”であり,当日の EB の回復とは“過去に発生したサービス停止事象が対象日(当日)を含む過去 30 日間から外れたので,EB に追加する当該事象のサービス停止時間のこと”である。例えば,4 月 2 日の EB の計算では,前日の EB が 15 分,当日の EB の消費が 1 分,当日の EB の回復が 0 分であり,計算結果は 14 分となる。
表4 試行運用開始後の結果
また,S チームは,(ウ)4 月 26 日に信頼性回復のための改善活動を開始した 。改善活動を開始するに当たって,S チームは,開発課と,EB の推移を示して議論を行い,T6 サービスの信頼性についての認識を合わせた。改善活動の候補を議論したところ,稼働環境へのリリース方法について,(エ)T6 サービスを停止することなくリリース作業が可能となる方式 が実現できないかどうかの検討に取り組むことにした。
〔試行運用の振り返り〕
X 部長は,試行運用の振り返りと今後の本格運用に向けた改善点などについて,S チームにヒアリングを行ったところ,次の意見が出された。
開発課と b の実施判断について,EB を使って効果的な議論を行い,T6 サービスの信頼性低下のリスクを抑えることができた。 4 月 11 日は,“数名の利用者が,問合せリクエストへの応答がないので再度リクエスト入力したという報告”を受けた対策をしている。調査したところ,プログラムでエラーが発生していて,リクエストが失敗となっていた。稼働時間を基に算出する稼働率の SLI だけでは,十分でないように感じる。そこで,サービス利用者からの客観的な評価を反映したサービスの信頼性指標として“T6 サービスが受け付けた総リクエスト数に対する c の割合”を SLI に追加した方がよい。 X 部長は,今後の本格運用に向けて,改善計画を策定することにした。
出題趣旨(IPA)
高可用性が求められるクラウドネイティブなシステム環境において,システムの信頼性を向上させるための取組として,SRE(SiteReliabilityEngineering)の考え方を導入する組織が増えている。本問では,SREを導入する題材として,エラーバジェット(EB)に基づいた作業の仕方,システム運用の自動化の取組,SREがチームとして効果的に機能する組織のあり方などを通じて,信頼性を向上していく技術と能力を問う。
設問と解答例
設問1
30字以内
〔T サービスの開発と運用における課題〕の本文中の下線(ア)について,運用だけでなく開発の業務経験が必要な理由を,30 字以内で答えよ。
解答例(2通り)
アプリケーションプログラムの不具合の改修を実施するから 表1項番8の業務内容を行う必要があるから
解説
本文の根拠
表1 項番8
8 稼働しているアプリケーションプログラムの不具合の改修は開発課/S チーム。
〔Tサービスの開発と運用における課題〕
T6 サービスは,今後も反復アプローチに基づいた開発が継続する状況にあり,開発課は機能追加の開発に専念する必要がある。
表1のT6サービスの列を上から見ると,Sチームが担うのは項番4〜9である。監視・障害対応,運用改善,リリースと展開,インフラ運用,信頼性向上への取組——ここまでは運用の仕事で,運用経験があれば足りる。
1つだけ違うのが項番8「稼働しているアプリケーションプログラムの不具合の改修」で,これはプログラムを直す仕事である。T1〜T5サービスでは開発課が担っているが,T6サービスでは開発課が機能追加に専念するため,Sチームに回ってくる。だから開発の業務経験が要る。
30字。解答例は「アプリケーションプログラムの不具合の改修を実施するから」で26字。表1を指して「表1項番8の業務内容を行う必要があるから」と書いてもよい。「開発から運用までのライフサイクル全般に関わるから」では,開発経験が要る仕事を名指しできていない。
採点講評(IPA)
設問1は,正答率がやや低かった。Sチームが開発から運用までのライフサイクル全般に関わる点だけに着目した解答も多かった。T6サービスに着目して,U社SREチームの要員には,運用だけではなく開発の業務経験も必要な理由を解答してほしい。
設問2
30字以内
〔S チームの目標設定〕の本文中の下線(イ)について,例外規定を設ける理由を,30 字以内で答えよ。
解答例
解説
本文の根拠
表3 項番2
2 EB が 3 分以下となった場合,S チームと開発課で協議を行って,翌日から稼働環境へのリリース作業を凍結し,信頼性回復のための改善活動を開始する。
表1 注1
リリースには機能追加に対応して行う定期リリースと不具合修正を行う緊急リリースがあり
表3の項番2は「リリース作業を凍結」としか書いていない。ところが表1の注1のとおり,リリースには定期リリースと緊急リリースの2種類があり,緊急リリースは不具合を直すためのものである。
このまま全部を止めると,EBがひっ迫している最中に障害が起きても直せなくなる。信頼性を守るために凍結したのに,かえって信頼性を下げてしまう。だから緊急リリースだけは凍結の対象から外す,という例外が要る。
30字。解答例は「故障対応などの緊急リリースを行う必要があるから」で22字。
設問3(1)
表4中の a に入れる適切な数値を答えよ。
解答例
解説
本文の根拠
〔試行運用の開始〕
当日の EB の回復とは“過去に発生したサービス停止事象が対象日(当日)を含む過去 30 日間から外れたので,EB に追加する当該事象のサービス停止時間のこと”である。
表4
4月2日は99.998%,14分,1分,機能追加に伴う定期リリース作業として T6 サービスの停止及び起動を行った。
表4
5月1日は99.970%,2分,0分,無し。
EBは「前日のEB − 当日の消費 + 当日の回復」で決まる。5月2日は停止が0分なので消費は無い。回復があるかどうかを見る。
対象期間は「対象日を含む過去30日間」である。5月1日の対象期間は4月2日〜5月1日,5月2日の対象期間は4月3日〜5月2日。つまり5月2日になると,4月2日の事象が対象期間から外れる。その停止時間1分がEBに戻ってくる。
2 − 0 + 1 = 3分。
稼働率でも確かめられる。EBが3分ならサービス停止時間の合計は 15 − 3 = 12分で,(43,200 − 12)÷ 43,200 = 0.999722…,小数第4位を四捨五入して99.972%。表4の値と一致する。
設問3(2)
25字以内
本文中の下線(ウ)について,4 月 26 日に信頼性回復のための改善活動を開始した理由を,25 字以内で答えよ。
解答例
解説
本文の根拠
表3 項番2
EB が 3 分以下となった場合,S チームと開発課で協議を行って,翌日から稼働環境へのリリース作業を凍結し,信頼性回復のための改善活動を開始する。
表4
4月25日は99.970%,2分で,停止時間1分の機能追加に伴う定期リリース作業と,停止時間2分の定期リリース作業後に改修の一部が正しく行われていないことが判明したリリース戻し作業の二つの事象がある。
表3の項番2は「EBが3分以下となった場合」「翌日から」と,条件と時期の両方を決めている。表4で条件に当たる日を探す。
4月25日は,定期リリースで1分,リリース戻しで2分の合計3分を消費し,EBが5分から2分になった。3分以下に当たるのはここである。
ルールが「翌日から」なので,開始は4月26日になる。
25字。解答例は「4月25日にEBが3分を下回ったから」で18字。日付と「3分」の両方を入れる。「EBがひっ迫したから」だけでは,なぜ26日なのかが言えていない。
採点講評(IPA)
設問3(2)は,正答率は平均的であった。4月25日にEB(エラーバジェット)が3分を下回った点について解答してほしかったが,部分的な解答も多かった。
設問3(3)
30字以内
本文中の下線(エ)について,サービスを停止することなくリリース作業が可能となる方式に変更することで得られる利点を,SLO の観点から 30 字以内で答えよ。
解答例(3通り)
リリース作業でのEB消費を防止できるから 稼働率が低下することを防ぐことができるから 障害復旧時間を短縮することができるから
解説
本文の根拠
〔Sチームの目標設定〕
定期リリースや緊急リリースの展開に伴って発生する稼働停止の時間及びエラー対処に要した時間を EB から消費させていく運用を行う
表2
SLI は稼働率(%),SLO は 99.965%,算出式は(サービス稼働予定時間 − サービス停止時間)÷ サービス稼働予定時間
「SLOの観点から」と条件が付いているので,稼働率99.965%を守る話に落とす。
表4でEBが減った原因を並べると,W社のクラウド障害(4月17日の5分)を除いて,残りはすべて自分たちのリリース作業に伴う停止である。4月2日,4月4日,4月9日,4月16日,4月25日——1〜2分ずつだが積み上がって,1か月でEBを15分から2分まで減らした。
停止せずにリリースできれば,この消費が無くなる。サービス停止時間が減れば算出式の分子が大きくなって稼働率が上がり,SLOに余裕ができる。
30字。解答例は「リリース作業でのEB消費を防止できるから」のほか,稼働率の低下を防ぐ,障害復旧時間を短縮できる,といった書き方でもよい。
設問4(1)
15字以内
本文中の b に入れる適切な字句を,15 字以内で答えよ。
解答例
解説
本文の根拠
表3 項番2
S チームと開発課で協議を行って,翌日から稼働環境へのリリース作業を凍結し
表3 項番3
3 リリース作業の凍結解除については,S チームと開発課で協議を行い判断する。
空欄bには「開発課と実施判断について議論したもの」が入る。表3で,Sチームと開発課が協議して決めると書いてあるものを探す。
項番2の凍結も項番3の凍結解除も,判断の対象は稼働環境へのリリース作業をやるかどうかである。EBの残りという数字を見ながら,止めるか再開するかを決められた——これが「EBを使って効果的な議論を行い,信頼性低下のリスクを抑えることができた」の中身になる。
15字。解答例は「稼働環境へのリリース作業」で12字。信頼性回復の改善活動は,Sチームと開発課が主体的に取り組むものであって,やるかどうかを協議するものではない。
採点講評(IPA)
設問4(1)は,正答率がやや低かった。EBを使って効果的な議論を行った点に着目し,稼働環境へのリリース作業について解答してほしかったが,信頼性回復の改善活動といった解答も多かった。
設問4(2)
15字以内
本文中の c に入れる適切な字句を,リクエスト数に着目して,15 字以内で答えよ。
解答例
解説
本文の根拠
〔試行運用の振り返り〕
調査したところ,プログラムでエラーが発生していて,リクエストが失敗となっていた。稼働時間を基に算出する稼働率の SLI だけでは,十分でないように感じる。
表2
算出式は(サービス稼働予定時間 − サービス停止時間)÷ サービス稼働予定時間
4月11日に起きたのは,サービスが止まったことではない。動いてはいたが,個々のリクエストがエラーで失敗していた。
表2の稼働率は,稼働していた時間の割合で測る。動いてさえいれば中でリクエストが失敗していても数字に表れない。だから「稼働率のSLIだけでは十分でない」と言っている。
利用者にとっては,リクエストが通ったかどうかが使えたかどうかである。そこで総リクエスト数のうち何件が通ったかを見る。
15字。解答例は「成功したリクエスト数」で10字。「リクエスト数に着目して」という条件があるので,件数で答える。
出典:令和7年度 春期 ITサービスマネージャ試験 午後Ⅰ 問2(表記を一部改変)
問3 IT サービス継続管理
IT サービス継続管理に関する次の記述を読んで,設問に答えよ。
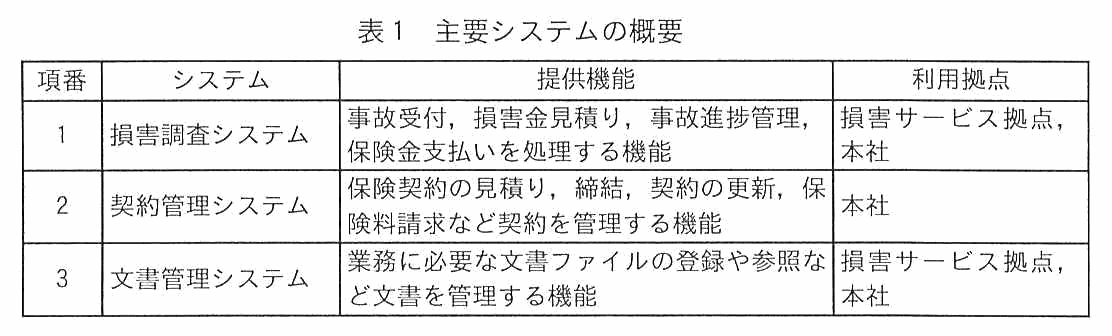
Q 社は自動車保険を販売する損害保険会社である。Q 社の自動車保険部は,全国に 10 か所ある損害サービス拠点を統括している。損害サービス拠点では,事故対応サービスを利用して,被保険者などから事故発生の連絡を受け付け,損害金見積りなどの事故対応を行っている。事故対応サービスは,Q 社情報システム部で運用される損害調査システムによって実現されている。情報システム部では,“事故受付リクエスト全件の 95%に対して応答時間を 5 秒以内とする”ことを,事故対応サービスのサービスレベル目標としている。自動車保険部及び情報システム部は,首都圏にある本社で業務を行っている。情報システム部が運用している主要システムの概要を表1に示す。
表1 主要システムの概要
各システムの IT インフラ(サーバ,ストレージなど)は,オンプレミスで本社にある自社データセンター(以下,DC という)に配置している。情報システム部は,システム障害対策として,毎日 0 時時点で損害調査システム及び契約管理システムのストレージのデータを 24 時間間隔でフルバックアップしている。また,情報システム部では災害に備えたバックアップの方針として,フルバックアップを遠隔地にも保管することとしている。そこで,フルバックアップは DC 内のバックアップ専用の別ストレージに保存し,災害に備えてクラウド事業者 S 社のサービス(以下,S クラウドという)のストレージサービスにも転送して保存している。なお,S クラウドは,Q 社本社の遠隔地となる関西の S 社データセンターで稼働しており,サービス対象データのバックアップを常に取り,S 社データセンターに保存している。
〔現在の IT サービス継続計画〕
Q 社では,地震などの自然災害が発生した場合,被保険者に対して損害サービス拠点で事故対応サービスを継続する方針で,事業継続計画(以下,BCP という)を定めている。情報システム部は,BCP で想定している規模の災害が発生して DC が被災した場合の復旧措置を,IT サービス継続計画に定めている。
IT サービス継続計画では,損害調査システムを,被災後 48 時間以内に復旧させる計画である。復旧作業を行う場合に必要な復旧手順書の最新版は,DC の文書管理システムに文書ファイル(以下,F ファイルという)として保存していて,情報システム部の要員は,F ファイルに基づいて復旧作業を行う。損害調査システムのストレージの復旧作業が必要な場合は,バックアップしてあるストレージのデータをリストアして,更新ログを使って被災時点のファイルの内容に復旧させる手順となる。ここで,被災によって更新ログが使用不能な場合は,バックアップ時点から被災発生時点までの更新内容は,自動車保険部による再入力が必要となる。また,DC に保存してあるバックアップが被災して使用できない場合は,(ア)S クラウドに保存してあるバックアップを使って復旧 する。なお,障害復旧後のシステムの正常稼働については,情報システム部のシステム担当が自動車保険部へ業務面の確認をして判断している。
〔IT サービス継続計画の見直し〕
2024 年 4 月に Q 社は,競合他社との差別化を図るため,BCP を変更し,災害時は事故受付業務を 12 時間以内に優先して再開することを決めた。情報システムに関連しては,次のように変更する。
災害発生後に事故受付業務を再開できるよう損害調査システムを“暫定復旧”する。“目標復旧時間(以下,RTO という)は,障害発生から 10 時間以内”とする。 事故受付業務の再開時は,災害発生直前に事故受付した被保険者の対応を,損害調査システムの事故進捗管理機能を利用して継続できるように,目標復旧時点(以下,RPO という)を被災時点に変更する。 情報システム部は,BCP の変更に伴い,IT サービス継続計画の見直しを開始した。情報システム部長は IT サービスマネージャの R 氏に,事故受付で利用する損害調査システムの IT サービス継続計画の見直しを指示した。
R 氏は,これまでのオンプレミスでの復旧では RTO 及び RPO の目標達成は困難であると考え,損害調査システムの現用系システムとは別に,S クラウドが提供しているサーバサービスを利用して待機系システムを稼働し,暫定復旧させる復旧方針案を検討した。具体的には,S クラウドのサーバサービスを用いて損害調査システムの待機系システムを準備し,更新ログのデータは現用系システムの更新ログと常に同期をとっておく。損害調査システム復旧の手順は次のとおりである。
DC 被災時は,S クラウドにバックアップしてあるフルバックアップと更新ログのデータとを用いて待機系システムのファイルの内容を被災時点に更新する。 被災時点のファイルが準備できたら,待機系システムを起動する。 損害サービス拠点及び本社の PC の接続先を待機系システムに変更する。 R 氏の考えた方針案は,情報システム部でレビューされた。復旧方針案は,次の 2 点の指摘に対応することを条件として承認され,具体的な IT サービス継続計画の検討に進むこととなった。
情報システム部のバックアップ方針に関連して確認すべきことがある。待機系システムを使って損害調査システムを稼働させた場合,待機系システム稼働中にシステム障害が発生したときに備えて,S 社の責任範囲として(イ)S クラウドで実施しているバックアップ運用について S 社に確認を行って ,必要な対策を検討すること。 IT サービス継続計画に基づいてテストを行うこと。(ウ)正式な RTO は,テスト結果を評価して自動車保険部と合意すること 。 〔サービス継続措置の検討〕
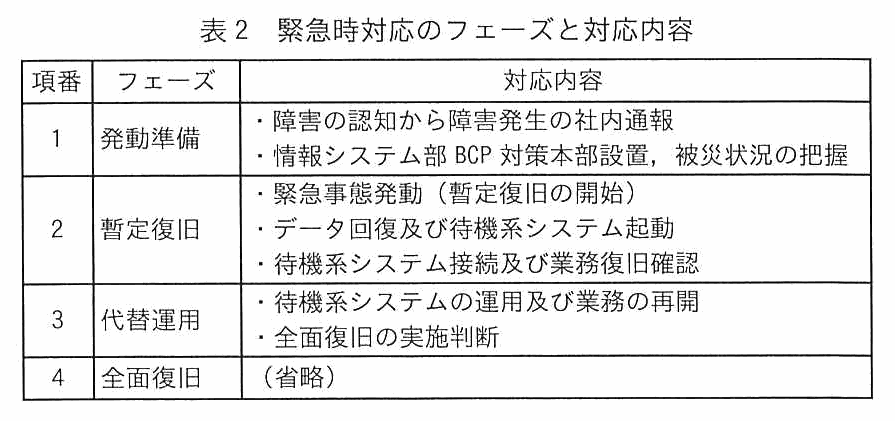
R 氏は,災害発生から全面復旧までの緊急時対応について,フェーズごとに対応内容を確認し,表2のように整理した。
表2 緊急時対応のフェーズと対応内容
次に,R 氏は,IT インフラ担当と実際に S クラウドに待機系システムを準備し,暫定復旧フェーズ及び代替運用フェーズを想定し待機系システムでの障害からの復旧をテストした。テストの結果は次のとおりであった。
データ回復から業務復旧確認までは 6 時間であり,RTO を達成見込である。ただし,データ回復作業の一部で,S クラウドの S 社担当者と連携して作業を進める必要がある。 復旧後の待機系システムで被災前時点のデータ欠落はなく,RPO を達成できる見込である。 待機系システムは,損害サービス拠点及び本社の PC から問題なく業務利用できることを確認できた。 S クラウドのサーバサービスの制約から,待機系システムでは,事故受付リクエスト全件の 95%が応答時間 10 秒以内に収まる結果となった。 R 氏は,応答時間についてのテスト結果を踏まえ,S クラウドのサーバサービスの能力を向上させる検討を,情報システム部長に相談した。R 氏は,情報システム部長から,“能力向上の検討の前に,(エ)代替運用フェーズの目標復旧レベル(以下,RLO という)について,自動車保険部と協議すること ”を指示された。
〔緊急事態発動時の体制整備〕
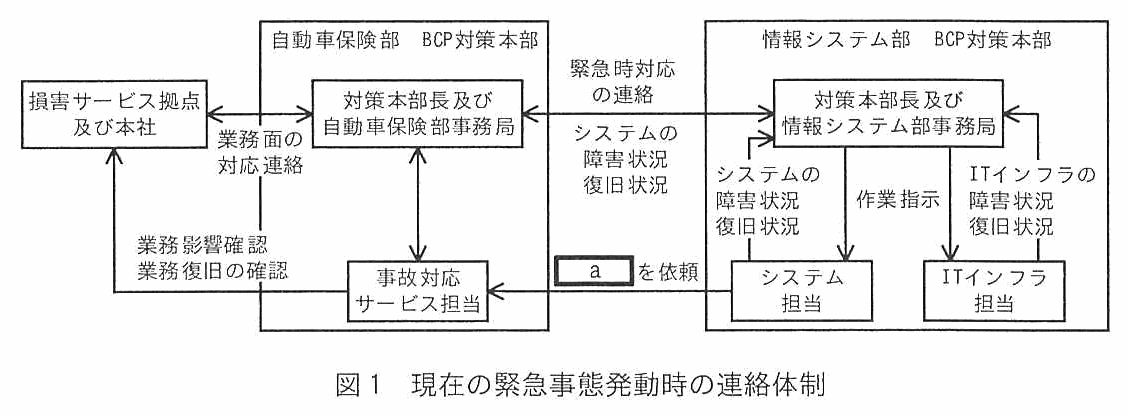
R 氏は,検討してきた事項を取り込み,IT サービス継続計画見直し版としてまとめた。情報システム部及び自動車保険部は,R 氏がまとめた IT サービス継続計画見直し版を,合同でレビューした。レビューの結果,現在の緊急事態発動時の連絡体制を改定することになった。現在,BCP では自動車保険部に BCP 対策本部及び自動車保険部事務局を設置し,自動車保険部事務局で業務復旧のコントロールをすることにしている。また,情報システム部に BCP 対策本部及び情報システム部事務局を設置し,自動車保険部事務局と連携して IT サービスの復旧コントロールをする。ここで,情報システム部のシステム担当には,自動車保険部の事故対応サービス担当に a を依頼する役割をもたせ,情報システム部 BCP 対策本部の対策本部長及び情報システム部事務局が事故対応サービスにおける復旧状況を判断できるようにしている。現在の緊急事態発動時の連絡体制を図1に示す。
図1 現在の緊急事態発動時の連絡体制
情報システム部では,今まで IT サービス継続計画に基づいた緊急事態対応訓練を年 1 回実施することで,IT サービス継続計画の評価を行い,緊急時の連絡を含む確認を行ってきた。R 氏は,IT サービス継続計画の見直しに伴い,(オ)現在の緊急事態対応訓練の計画に,S 社に要請して体制面の内容を追加し ,訓練を実施することを計画した。
出題趣旨(IPA)
ITサービスの提供において,クラウドサービスの利用が進み,事業継続計画(BCP)に基づいたサービス継続計画の対策としても,クラウドサービスを活用する形態が増えている。本問では,BCPと連携したサービス継続計画を策定し,目標達成をするための課題認識,復旧方式検討,サービス継続計画の発動から暫定回復に至るフェーズにおける実施項目の検討と評価を通じて,サービス継続に関する計画能力,評価能力を問う。
設問と解答例
設問1(1)
10字以内
本文中の下線(ア)について,目標復旧時点(RPO)を 10 字以内で答えよ。
解答例
解説
本文の根拠
冒頭
毎日 0 時時点で損害調査システム及び契約管理システムのストレージのデータを 24 時間間隔でフルバックアップしている
冒頭
フルバックアップは DC 内のバックアップ専用の別ストレージに保存し,災害に備えてクラウド事業者 S 社のサービス(以下,S クラウドという)のストレージサービスにも転送して保存している。
〔現在のITサービス継続計画〕
被災によって更新ログが使用不能な場合は,バックアップ時点から被災発生時点までの更新内容は,自動車保険部による再入力が必要となる。
RPO(目標復旧時点)は,どの時点のデータまで戻せるかである。Sクラウドに何が置いてあるかを確かめる。
Sクラウドへ転送しているのはフルバックアップだけで,更新ログは送っていない。しかも下線(ア)の状況はDCのバックアップが被災して使えない場合なので,DCにある更新ログも当てにできない。使えるのはフルバックアップ1本だけである。
そのフルバックアップは毎日0時時点のもの。したがって戻せるのは被災当日の0時までで,そこから被災までの更新は自動車保険部が再入力することになる。
10字。解答例は「被災当日の0時」で7字。「0時」だけでは,いつの0時かが言えていない。
設問1(2)
50字以内
現在の計画では,文書管理システムが被災して使用不能となった場合は,復旧作業に支障が出ることが想定される。必要な対策を,50 字以内で答えよ。
解答例(2通り)
FファイルをSクラウドにバックアップした上でSクラウドに転送して保存し,被災時に参照可能とする。 最新版の復旧手順書を印刷して,使用する拠点に配備し,被災時に使用できるようにする。
解説
本文の根拠
〔現在のITサービス継続計画〕
復旧作業を行う場合に必要な復旧手順書の最新版は,DC の文書管理システムに文書ファイル(以下,F ファイルという)として保存していて,情報システム部の要員は,F ファイルに基づいて復旧作業を行う。
冒頭
毎日 0 時時点で損害調査システム及び契約管理システムのストレージのデータを 24 時間間隔でフルバックアップしている
バックアップの対象を読み直すと,「損害調査システム及び契約管理システム」とだけ書いてある。文書管理システムは入っていない。ここが見落としやすい。
一方で復旧手順書(Fファイル)は,その文書管理システムの中にしか無い。文書管理システムもDCにあるので,DCが被災すれば復旧手順書ごと失われる。手順書が無ければ復旧作業そのものが始められない,というのが「支障」の中身である。
対策は,被災しても手順書が読める状態を作ることになる。Fファイルもバックアップの対象に加えてSクラウドへ転送しておくか,印刷して使用する拠点に置いておくかである。
50字。どちらの案でも,「何を」「どこに置いて」「被災時に使える」の3点をそろえる。
設問2(1)
20字以内
本文中の下線(イ)について,確認すべきことは何か。20 字以内で答えよ。
解答例(2通り)
バックアップの遠隔地保管の有無 SクラウドのRPO及びRTO
解説
本文の根拠
冒頭
情報システム部では災害に備えたバックアップの方針として,フルバックアップを遠隔地にも保管することとしている。
冒頭
S クラウドは,Q 社本社の遠隔地となる関西の S 社データセンターで稼働しており,サービス対象データのバックアップを常に取り,S 社データセンターに保存している。
レビューの指摘は「情報システム部のバックアップ方針に関連して」と言っている。方針は「フルバックアップを遠隔地にも保管する」である。
ところがS社のバックアップは,S社データセンターに保存している。Sクラウドが動いているのと同じ場所である。待機系システムをSクラウドで動かすと,その待機系のバックアップは待機系と同じ拠点にあることになり,S社データセンターが被災すれば両方まとめて失う。自社の方針を満たしていない。
だから確認すべきは,S社のバックアップが遠隔地にも保管されているかどうかである。
20字。解答例は「バックアップの遠隔地保管の有無」で15字。S社側の復旧の早さ・戻せる時点という観点から「SクラウドのRPO及びRTO」と書いてもよい。
採点講評(IPA)
設問2(1)は正解率が低かった。クラウドサービスを活用する際は,災害に備えた自社の方針とクラウドサービスの対応内容が整合していることの確認が重要であると認識してほしい。
設問2(2)
20字以内
本文中の下線(ウ)について,正式な RTO をテスト結果評価後に合意する目的は何か。20 字以内で答えよ。
解答例
解説
本文の根拠
〔ITサービス継続計画の見直し〕
“目標復旧時間(以下,RTO という)は,障害発生から 10 時間以内”とする。
〔サービス継続措置の検討〕
データ回復から業務復旧確認までは 6 時間であり,RTO を達成見込である。ただし,データ回復作業の一部で,S クラウドの S 社担当者と連携して作業を進める必要がある。
RTO 10時間は,BCPを変えたときに「こうしたい」と置いた値で,達成できるかどうかは分からないまま決まっている。
テストをして初めて,データ回復から業務復旧確認まで6時間という実測が出る。この結果を見てから合意すれば,守れない数字を約束することも,逆に余裕を見すぎた数字を置くこともない。
20字。解答例は「実現可能なRTOとするため」で12字。「テスト結果を目標値に反映するため」では,何のために反映するのかが言えていない。実現できる目標にそろえる,というところまで書く。
採点講評(IPA)
設問2(2)は正解率がやや低かった。テスト結果を目標値へ反映することに留まった解答が散見された。実現可能な目標を設定するために,テスト結果評価後に合意形成していくプロセスを認識してほしい。
設問3
30字以内
〔サービス継続措置の検討〕について,テスト結果を踏まえて,下線(エ)の RLO の内容を,30 字以内で答えよ。
解答例
事故受付リクエスト全件の95%の応答時間が10秒以内
解説
本文の根拠
冒頭
情報システム部では,“事故受付リクエスト全件の 95%に対して応答時間を 5 秒以内とする”ことを,事故対応サービスのサービスレベル目標としている。
〔サービス継続措置の検討〕
S クラウドのサーバサービスの制約から,待機系システムでは,事故受付リクエスト全件の 95%が応答時間 10 秒以内に収まる結果となった。
RLO(目標復旧レベル)は,復旧した状態でどこまでのサービス水準を出すかである。
平時の目標は「95%が5秒以内」だが,待機系システムのテスト結果は「95%が10秒以内」だった。R氏は能力を上げようと相談したが,部長は先にRLOを協議せよと指示している。つまり代替運用の間は平時と同じ水準でなくてよいかもしれない,まずどの水準で合意するかを決めよ,ということである。
したがってRLOはテスト結果そのもの,「事故受付リクエスト全件の95%が10秒以内」になる。
30字。解答例は27字。95%という条件を落とすと,平時の目標と対になる形にならない。
設問4(1)
25字以内
本文中の a について,自動車保険部の事故対応サービス担当に依頼することは何か。IT サービス継続計画見直し後を想定して,25 字以内で答えよ。
解答例
解説
本文の根拠
〔現在のITサービス継続計画〕
障害復旧後のシステムの正常稼働については,情報システム部のシステム担当が自動車保険部へ業務面の確認をして判断している。
図1
自動車保険部 BCP 対策本部には「事故対応サービス担当」もあり,損害サービス拠点及び本社との間で業務影響確認・業務復旧の確認を行う。
表1 項番1
1 損害調査システムは,事故受付,損害金見積り,事故進捗管理,保険金支払いを処理する機能を提供し,損害サービス拠点と本社で利用する。
システム担当は,システムが動いただけでは正常稼働と判断できない。業務として使えるかどうかを自動車保険部に確かめてもらったうえで判断する,と本文に書いてある。
確かめる相手は,図1のとおり事故対応サービス担当である。この担当は損害サービス拠点と本社に対して業務影響と業務復旧を確認する役回りをもっている。そして損害調査システムを使うのは,表1のとおりその損害サービス拠点と本社である。
したがって依頼するのは,損害サービス拠点と本社で業務が復旧したかどうかの確認になる。
25字。解答例は「損害サービス拠点及び本社での業務面の復旧確認」で21字。確認する場所を落として「業務の復旧確認」だけにすると,誰にどこを見てもらうのかが決まらない。
採点講評(IPA)
設問4(1)は正解率がやや低かった。システムを利用した業務影響及び業務再開可否を,サービス利用者側で確認する際には,サービス利用者側と事前に役割を合意して計画に組み込むことが重要である。
設問4(2)
20字以内
本文中の下線(オ)について,S 社に要請すべき体制面の内容を,20 字以内で答えよ。
解答例(2通り)
S社担当者の緊急事態対応訓練への参加 データ回復作業を行うS社体制の確保
解説
本文の根拠
〔サービス継続措置の検討〕
ただし,データ回復作業の一部で,S クラウドの S 社担当者と連携して作業を進める必要がある。
〔緊急事態発動時の体制整備〕
今まで IT サービス継続計画に基づいた緊急事態対応訓練を年 1 回実施することで,IT サービス継続計画の評価を行い,緊急時の連絡を含む確認を行ってきた。
見直し後の復旧は,データ回復の一部をS社担当者と一緒に進めることになる。自社の要員だけでは暫定復旧が終わらない。
ところが訓練はこれまで情報システム部だけで行ってきた。S社が入らない訓練では,本番で連携できるかどうかを確かめられないし,S社側に人が出せるかも分からない。「体制面の内容を追加し」とあるのはここを指している。
20字。解答例は「S社担当者の緊急事態対応訓練への参加」で18字。訓練への参加ではなく,復旧作業に人を出せる体制の確保という形で「データ回復作業を行うS社体制の確保」と書いてもよい。
出典:令和7年度 春期 ITサービスマネージャ試験 午後Ⅰ 問3(表記を一部改変)
ほかの年度
令和7年度 秋期 午前Ⅱ
令和5年度 春期 午前Ⅱ
令和4年度 春期 午前Ⅱ
令和3年度 春期 午前Ⅱ
令和元年度 秋期 午前Ⅱ
平成30年度 秋期 午前Ⅱ
平成29年度 秋期 午前Ⅱ
平成28年度 秋期 午前Ⅱ
平成27年度 秋期 午前Ⅱ
平成26年度 秋期 午前Ⅱ
平成25年度 秋期 午前Ⅱ
平成24年度 秋期 午前Ⅱ
平成23年度 秋期 午前Ⅱ
平成22年度 秋期 午前Ⅱ
平成21年度 秋期 午前Ⅱ
令和6年度 春期 午前Ⅱ
令和5年度 春期 午前Ⅱ
令和4年度 春期 午前Ⅱ
令和6年度 春期 午前Ⅱ
令和5年度 春期 午前Ⅱ
令和4年度 春期 午前Ⅱ
令和6年度 春期 午前Ⅱ
令和5年度 春期 午前Ⅱ
令和4年度 春期 午前Ⅱ
令和7年度 秋期 午前Ⅱ
令和6年度 秋期 午前Ⅱ
令和5年度 秋期 午前Ⅱ
令和4年度 秋期 午前Ⅱ
令和3年度 秋期 午前Ⅱ
令和2年度 10月 午前Ⅱ
平成31年度 春期 午前Ⅱ
平成30年度 春期 午前Ⅱ
平成29年度 春期 午前Ⅱ
平成28年度 春期 午前Ⅱ
平成27年度 春期 午前Ⅱ
令和7年度 秋期 午前Ⅰ
令和7年度 春期 午前Ⅰ
令和7年度 春期 午前Ⅱ
令和6年度 秋期 午前Ⅰ
令和6年度 春期 午前Ⅰ
令和6年度 春期 午前Ⅱ
令和6年度 春期 午後Ⅰ
令和5年度 秋期 午前Ⅰ
令和5年度 春期 午前Ⅰ
令和5年度 春期 午前Ⅱ
令和5年度 春期 午後Ⅰ
令和4年度 秋期 午前Ⅰ
令和4年度 春期 午前Ⅰ
令和4年度 春期 午前Ⅱ
令和4年度 春期 午後Ⅰ
令和3年度 秋期 午前Ⅰ
令和3年度 春期 午前Ⅰ
令和3年度 春期 午前Ⅱ
令和3年度 春期 午後Ⅰ
令和2年度 10月 午前Ⅰ
令和元年度 秋期 午前Ⅰ
令和元年度 秋期 午前Ⅱ
令和元年度 秋期 午後Ⅰ
平成31年度 春期 午前Ⅰ
平成30年度 秋期 午前Ⅰ
平成30年度 秋期 午前Ⅱ
平成30年度 秋期 午後Ⅰ
平成30年度 春期 午前Ⅰ
平成29年度 秋期 午前Ⅰ
平成29年度 秋期 午前Ⅱ
平成29年度 秋期 午後Ⅰ
平成29年度 春期 午前Ⅰ
平成28年度 秋期 午前Ⅰ
平成28年度 秋期 午前Ⅱ
平成28年度 秋期 午後Ⅰ
平成28年度 春期 午前Ⅰ
平成27年度 秋期 午前Ⅰ
平成27年度 春期 午前Ⅰ
平成27年度 秋期 午前Ⅱ
平成27年度 秋期 午後Ⅰ
平成26年度 秋期 午前Ⅰ
平成26年度 秋期 午後Ⅰ
平成26年度 春期 午前Ⅰ
平成25年度 秋期 午前Ⅰ
平成25年度 秋期 午後Ⅰ
平成25年度 春期 午前Ⅰ
平成24年度 秋期 午前Ⅰ
平成24年度 秋期 午後Ⅰ
平成24年度 春期 午前Ⅰ
平成23年度 秋期 午前Ⅰ
平成23年度 秋期 午後Ⅰ
平成23年度 特別試験 午前Ⅰ
平成22年度 秋期 午前Ⅰ
平成22年度 秋期 午後Ⅰ
平成22年度 春期 午前Ⅰ
平成21年度 秋期 午前Ⅰ
平成21年度 秋期 午後Ⅰ
平成26年度 秋期 午前Ⅱ
平成25年度 秋期 午前Ⅱ
平成24年度 秋期 午前Ⅱ
平成23年度 秋期 午前Ⅱ
平成22年度 秋期 午前Ⅱ
平成21年度 秋期 午前Ⅱ
平成21年度 春期 午前Ⅰ